Apple emplea un sistema sofisticado, aunque privado, para gestionar la profanidad y el contenido sensible dentro de sus motores de teclado y autocorrector. En el núcleo de este sistema se encuentra Lexicon.framework, un framework privado que gestiona diccionarios por idioma ubicados en las carpetas de datos lingüísticos del sistema. Cada palabra en estos diccionarios está asociada con dos campos de banderas de 32 bits: uno para un 'nivel' de vulgaridad y otro para una máscara de bits de 'tema'. Aunque Apple no proporciona una API pública para estas banderas, estas pueden accederse a través de funciones privadas en C para revelar cómo el sistema operativo clasifica el lenguaje.
El sistema distingue entre tres niveles principales de contenido: 'vulgar' (insultos y jerga sexual), 'ofensivo' (insultos dirigidos a grupos de personas) y 'sensible' (insultos leves, drogas, armas y funciones corporales). Además, las palabras se asignan a hasta once banderas de temas, tales como excreción, partes del cuerpo, drogas, política y religión. Por ejemplo, mientras que una palabra como 'Trump' está marcada en el nivel sensible, también lleva una bandera de tema de política. Estas banderas funcionan de forma independiente; una palabra puede tener una bandera de tema sin estar asignada a un nivel de vulgaridad, lo que puede servir como una pista para que el motor de clasificación maneje la palabra con precaución.
Para equilibrar estas banderas con la intención del usuario, macOS mantiene una base de datos SQLite local en `~/Library/Keyboard/VulgarWordUsage.db`. Esta base de datos rastrea el uso de palabras ya identificadas como vulgares por el sistema, registrando el recuento de uso por aplicación y por destinatario. El objetivo es permitir que el teclado 'aprenda' los hábitos del usuario; por ejemplo, reconociendo que un usuario podría usar una palabra malsonante con un amigo cercano en una aplicación de mensajería, pero debería ser guiado hacia una alternativa 'limpia' al escribir un correo electrónico a un colega. Sin embargo, el mecanismo exacto de cómo se puebla esta información sigue siendo algo opaco; en algunas pruebas, la entrada de texto estándar no activó nuevas entradas en la base de datos, lo que sugiere que el registro puede estar restringido a aplicaciones o configuraciones específicas.
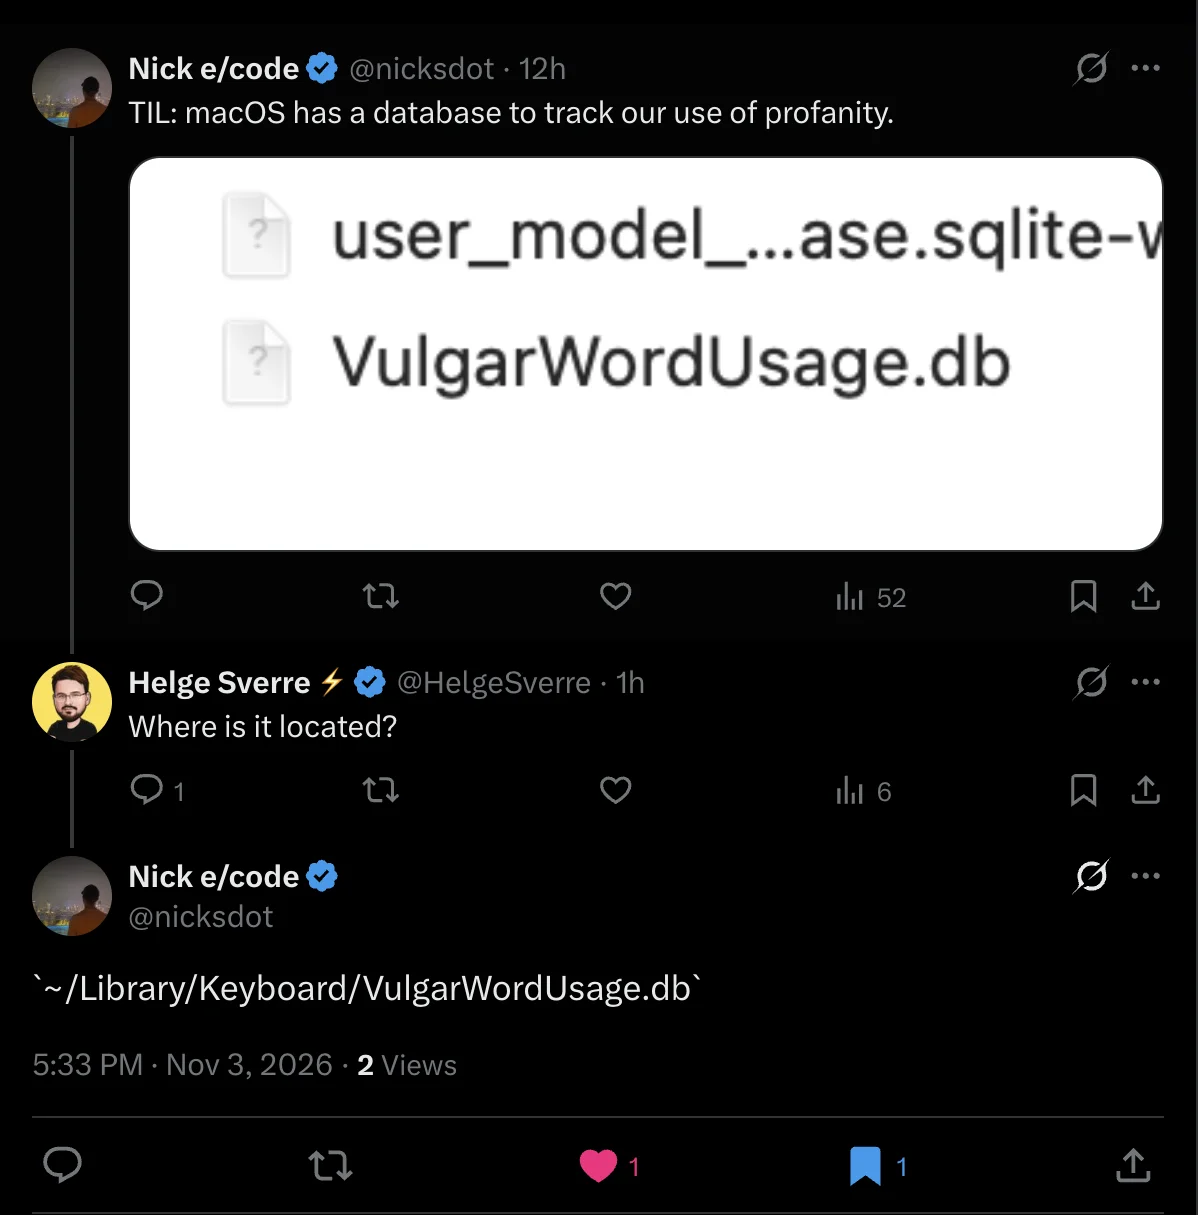
La imagen muestra la ruta de archivo específica y el nombre de la base de datos mencionados en la discusión del artículo sobre el seguimiento de palabras locales.
Debido a que estos frameworks son privados, no existe documentación oficial sobre la lógica específica utilizada para determinar estas clasificaciones. Los resultados del volcado muestran que algunas entradas parecen haber sido seleccionadas manualmente en lugar de basarse en reglas, como la inclusión de 'Oedipus' en el nivel vulgar o 'niggardly' en el nivel ofensivo. Esto resalta un compromiso donde Apple prioriza una experiencia curada de autocorrección 'segura' sobre un enfoque puramente algorítmico, incluso si esto resulta en algunas rarezas lingüísticas o clasificaciones subjetivas de nombres y términos comunes. El objetivo final del sistema es asegurar que, si un usuario escribe una palabra vulgar, el teclado solo la sugiera si el usuario ha establecido un patrón de uso en ese contexto específico.