A medida que el ritmo de desarrollo de OpenAI se aceleró, el monorepo de la empresa enfrentó desafíos significativos de escalabilidad. La integración de Codex y otras herramientas de IA permitió a los ingenieros realizar más trabajo en paralelo, lo que provocó un aumento en las cargas, fusiones y extracciones concurrentes desde trabajos de investigación y entornos de CI. Estas demandas eventualmente causaron que los sistemas de control de versiones existentes tuvieran dificultades, con una fiabilidad que ocasionalmente caía por debajo del 90% debido a extracciones lentas y fusiones fallidas. Para abordar esto, los ingenieros de OpenAI construyeron Pando, un nuevo backend para repositorios Git diseñado para manejar el trabajo a 'escala de agentes', donde tanto los ingenieros humanos como los agentes de IA interactúan con la base de código simultáneamente.
Pando está diseñado para ser transparente para el usuario; impulsa el monorepo sin requerir que los ingenieros cambien sus flujos de trabajo o herramientas de Git existentes. El sistema logra la escalabilidad horizontal al repensar dos limitaciones centrales de los servicios de Git tradicionales. Primero, coordina las actualizaciones de las ramas de forma independiente. En muchos sistemas estándar, se impone un único orden a todas las escrituras en un repositorio, lo que significa que una carga a una rama podría esperar a una carga en una rama no relacionada. Pando elimina este cuello de botella permitiendo que las ramas no relacionadas se actualicen en paralelo. Segundo, Pando optimiza el rendimiento de lectura al reutilizar 'packfiles' —el formato comprimido de Git para múltiples objetos— a través de diferentes clientes. En lugar de generar un packfile único para cada extracción, el servidor sirve los mismos bytes a múltiples clientes, reduciendo significativamente el uso de CPU y la E/S de disco.
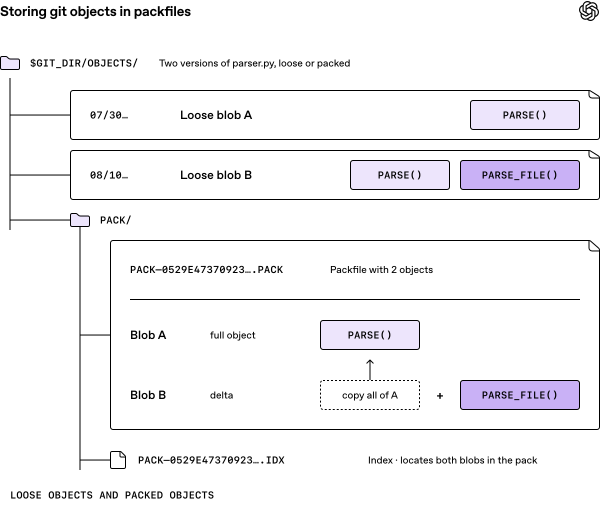
El artículo explica cómo Pando optimiza el rendimiento de lectura al reutilizar archivos pack, que son el formato comprimido de Git para múltiples objetos.
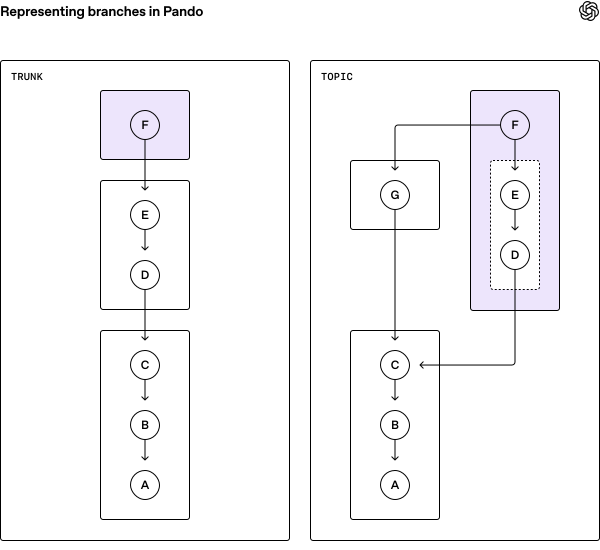
El artículo describe cómo Pando coordina las actualizaciones de las ramas de forma independiente para eliminar los cuellos de botella en los servicios de Git tradicionales.
Para lograr esta escala, Pando adopta un modelo de 'consistencia causal', que implica un compromiso específico con respecto al estado general del repositorio. Debido a que Pando coordina las ramas de forma independiente, no proporciona una instantánea única y consistente en un momento dado de todas las referencias en todo el repositorio. Por ejemplo, si un cliente realiza un clon completo mientras se actualizan dos ramas diferentes, el cliente podría ver una rama en la versión A y la otra en la versión B, incluso si técnicamente se actualizaron 'simultáneamente'. Sin embargo, Pando mantiene la serializabilidad para referencias individuales, asegurando que las actualizaciones de una sola rama permanezcan consistentes. En producción, esta arquitectura ha reducido la latencia mediana de carga en casi 5 veces y actualmente maneja casi un petabyte de datos de Git por día. Si bien el sistema proporciona un alto rendimiento, el número específico de agentes de IA concurrentes que utilizan actualmente el sistema no ha sido revelado.