Investigadores del MIT CSAIL y otras instituciones han identificado un nuevo paradigma que denominan 'Programación en el Espacio de Pesos'. Tradicionalmente, la optimización de una red neuronal implica el uso de algoritmos simbólicos como Adam o Muon para actualizar iterativamente los pesos basándose en los gradientes. En contraste, la Programación en el Espacio de Pesos implica que un LLM de propósito general razone sobre los pesos numéricos brutos de una red para identificar comportamientos, fallos o rasgos específicos, y luego edite manualmente esos pesos para lograr un objetivo deseado en lenguaje natural.
En una serie de experimentos, los investigadores demostraron que GPT-6 Astra podía realizar estas tareas con una precisión sorprendente. Por ejemplo, Astra fue capaz de identificar qué juego de computadora estaba entrenada para jugar una pequeña red neuronal (como Breakout o Pong) simplemente leyendo sus 17,253 pesos brutos como texto. También identificó con éxito 'cabezales de copia' —componentes específicos en los bloques transformer que permiten a un modelo repetir texto anterior— dentro de las capas medias de un modelo de lenguaje. Estas capacidades se demostraron sin permitir que el modelo ejecutara una pasada hacia adelante o utilizara herramientas externas, lo que sugiere que Astra está leyendo la geometría y estructura subyacente de los pesos en lugar de simplemente calcular salidas.
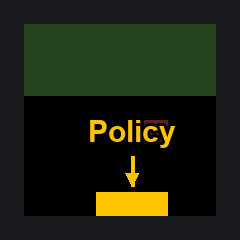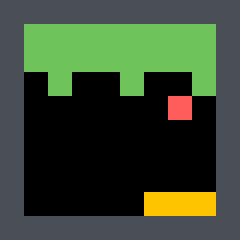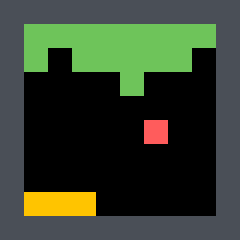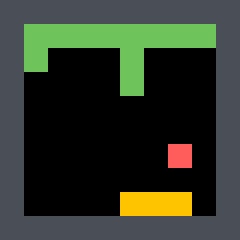
Esta imagen representa el experimento en el que Astra identificó el juego específico que una pequeña red estaba entrenada para jugar.
La aplicación más significativa de esta técnica involucra correcciones de 'un solo disparo' para fallos del modelo. Cuando se le pidió mejorar el rendimiento matemático de Qwen3.5-0.8B, Astra identificó un problema de peso específico que causaba bucles de razonamiento y editó solo el 0.016% de los pesos del modelo. Esta corrección manual elevó la puntuación del modelo en la prueba de referencia MATH-500 del 7.9% al 48.1% y triplicó su rendimiento en el seguimiento de instrucciones. Del mismo modo, en una tarea de control físico donde un coche estaba atascado en una rampa debido a una política de mínimo local, Astra editó el 3.5% de los pesos para añadir una ruta separada a través de las unidades de la red, permitiendo que el coche retrocediera con éxito y superara el obstáculo. Si bien estos resultados son prometedores, la investigación actual se centra en modelos pequeños y medianos, dejando incierto si este razonamiento en el espacio de pesos se escala linealmente a modelos de vanguardia masivos o si permanece como una capacidad especializada para arquitecturas más pequeñas.
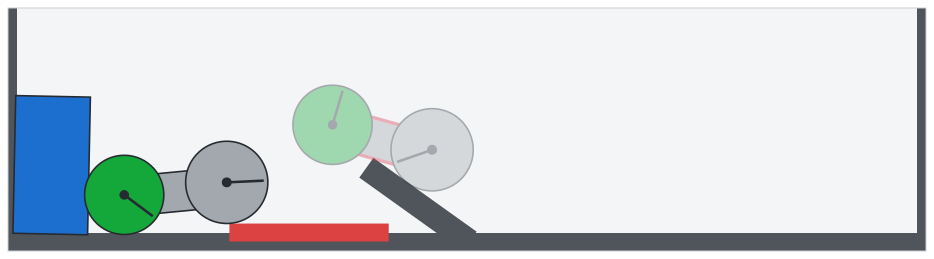
La imagen ilustra la tarea de control físico donde Astra editó los pesos para permitir que un coche superara un obstáculo de mínimo local.