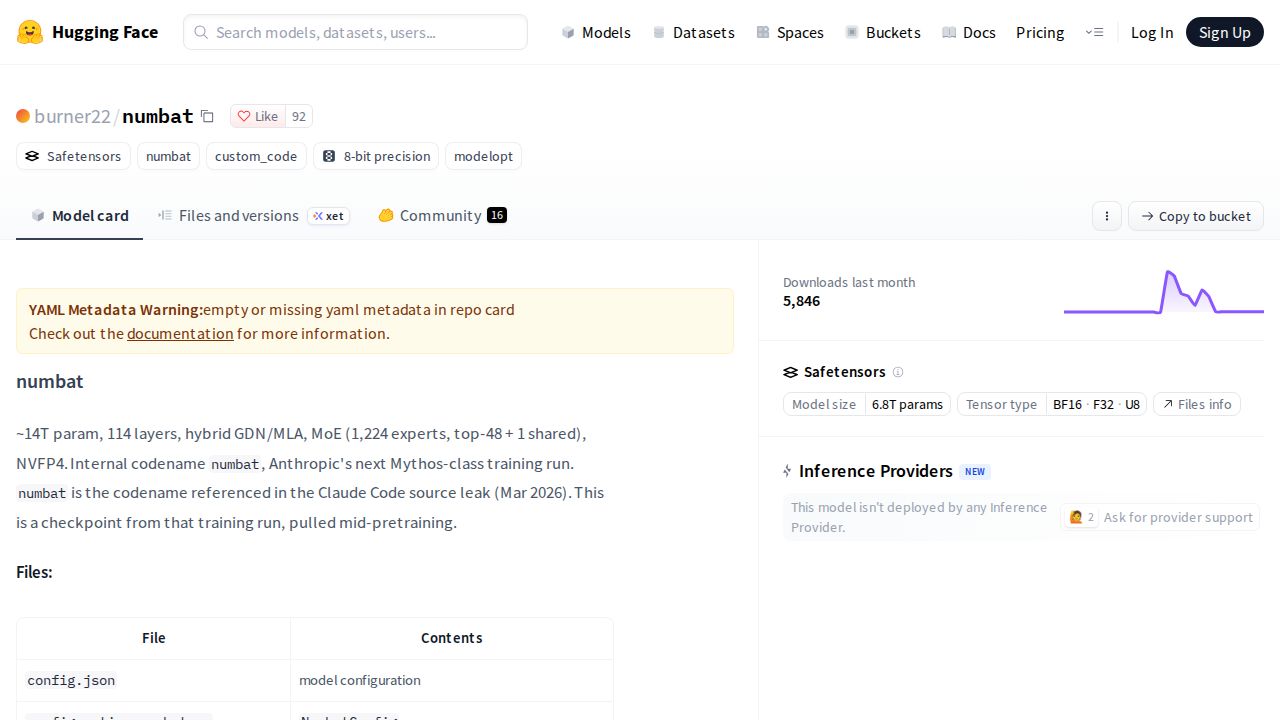
Un repositorio en Hugging Face bajo el usuario 'burner22' ha aparecido, supuestamente alojando un modelo a gran escala con el nombre en clave 'numbat'. El repositorio incluye un punto de control de lo que se describe como la próxima ejecución de entrenamiento Mythos-class de Anthropic. El nombre en clave 'numbat' llamó la atención después de que supuestamente fuera identificado en una filtración de fuente previa relacionada con Claude Code en marzo de 2026, donde un comentario en un archivo de configuración instruía a los desarrolladores a eliminar una sección antes del lanzamiento de 'numbat'.
El repositorio contiene una cantidad significativa de datos técnicos, incluyendo 772 fragmentos de datos de tensores que suman aproximadamente 7.72 TB. La arquitectura del modelo se describe como una pila híbrida Gated DeltaNet (GDN) y Multi-head Latent Attention (MLA), utilizando una capa feed-forward de Mixture-of-Experts (MoE) con 1,224 expertos. El repositorio también incluye una implementación de referencia en Python, lo que permite que el modelo sea cargado y ejecutado utilizando el método `AutoModelForCausalLM.from_pretrained` con `trust_remote_code=True`. Los pesos se proporcionan en un formato cuantizado NVFP4, que el cargador afirma es utilizado por el equipo de evaluación para realizar comprobaciones en una sección más pequeña de hardware en lugar de en el clúster de entrenamiento completo.
A pesar de la consistencia técnica de los archivos —como los recuentos deterministas de tensores y la consistencia interna a través de los fragmentos—, la autenticidad de la filtración sigue sin ser verificada por Anthropic. El cargador señala que este es un punto de control de mitad de preentrenamiento en el paso 1,830,000 de una ejecución de 1.96 millones de pasos, lo que significa que no ha pasado por el postentrenamiento o el Aprendizaje por Refuerzo a partir de la Retroalimentación Humana (RLHF). Si bien el modelo es técnicamente ejecutable a través de los scripts proporcionados, requiere recursos de hardware masivos para manejar los 7.72 TB de datos de tensores y representa un estado crudo y sin terminar del desarrollo del modelo.