La demoscena es una subcultura centrada en llevar al límite los gráficos por computadora y el audio bajo restricciones técnicas estrictas, como tamaños de archivo pequeños o hardware limitado. Un proyecto reciente de un desarrollador en la plataforma Datavorous explora este espacio utilizando el aprendizaje automático para navegar la naturaleza 'productiva' de los lenguajes de programación. Al tratar la peculiar sintaxis de 'golf' de los Dweets —demos de JavaScript de 140 caracteres alojados en Dwitter.net— como un sistema lingüístico, el autor buscó utilizar un modelo autorregresivo para muestrear continuaciones plausibles de código inacabado, creando efectivamente un 'autocompletado' para la programación creativa.
Para lograr esto, el desarrollador utilizó Qwen2.5-Code-7B como modelo base. Debido a que los Dweets dependen en gran medida de abreviaturas matemáticas y trucos de 'code-golfing' que difieren de la programación estándar, el modelo base tuvo dificultades iniciales con la sintaxis. El autor realizó un preentrenamiento continuo (CPT) en un conjunto de datos de 25,000 Dweets recuperados a través de la API de Dwitter. Este proceso redujo significativamente el 'surprisal' del modelo —la probabilidad logarítmica negativa asignada a un token— y disminuyó la perplejidad de los Dweets retenidos de 28.63 a 8.57. Esto indicó que el modelo había internalizado con éxito los modismos y estructuras específicos del ecosistema de Dwitter.
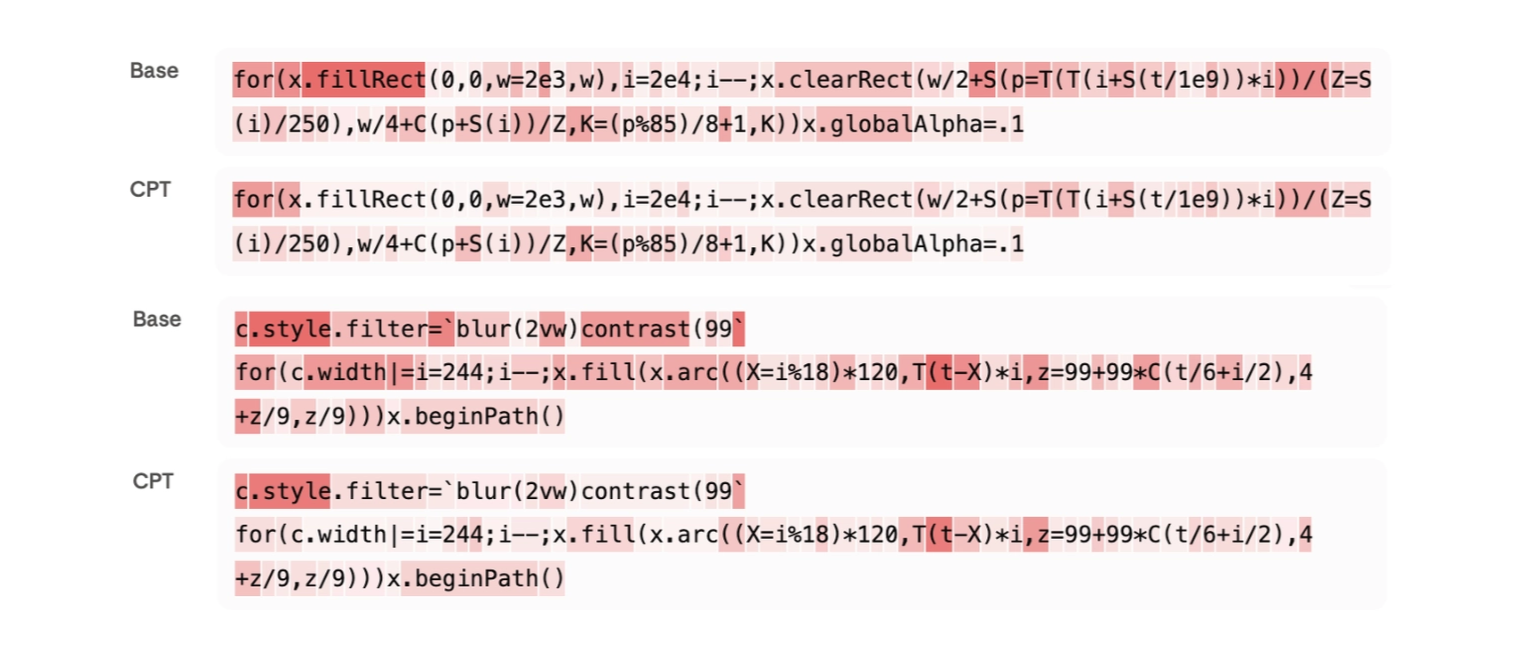
Esta figura ilustra la reducción significativa en la perplejidad y el surprisal lograda mediante el preentrenamiento continuo en el conjunto de datos de Dweets.
Para ir más allá de la mera corrección sintáctica hacia la calidad estética, el autor implementó una estrategia de entrenamiento por currículo. Utilizando las puntuaciones internas de 'awesomeness' de Dwitter, el proceso de entrenamiento ponderó progresivamente los programas de mayor rango, favoreciendo finalmente los 1,000 Dweets más populares para aproximadamente el 67% de la probabilidad de muestreo. Esto fue seguido por un Aprendizaje por Refuerzo a partir de la Retroalimentación Humana (RLHF) utilizando el algoritmo GRPO. El autor actuó como la función de recompensa, inspeccionando y clasificando manualmente aproximadamente 40,000 animaciones para refinar la política del modelo. El resultado final es una herramienta que permite a los usuarios generar múltiples continuaciones visuales a partir de un solo prefijo de código, proporcionando una forma de ramificarse y explorar diferentes direcciones artísticas en el espacio de la demoscena.
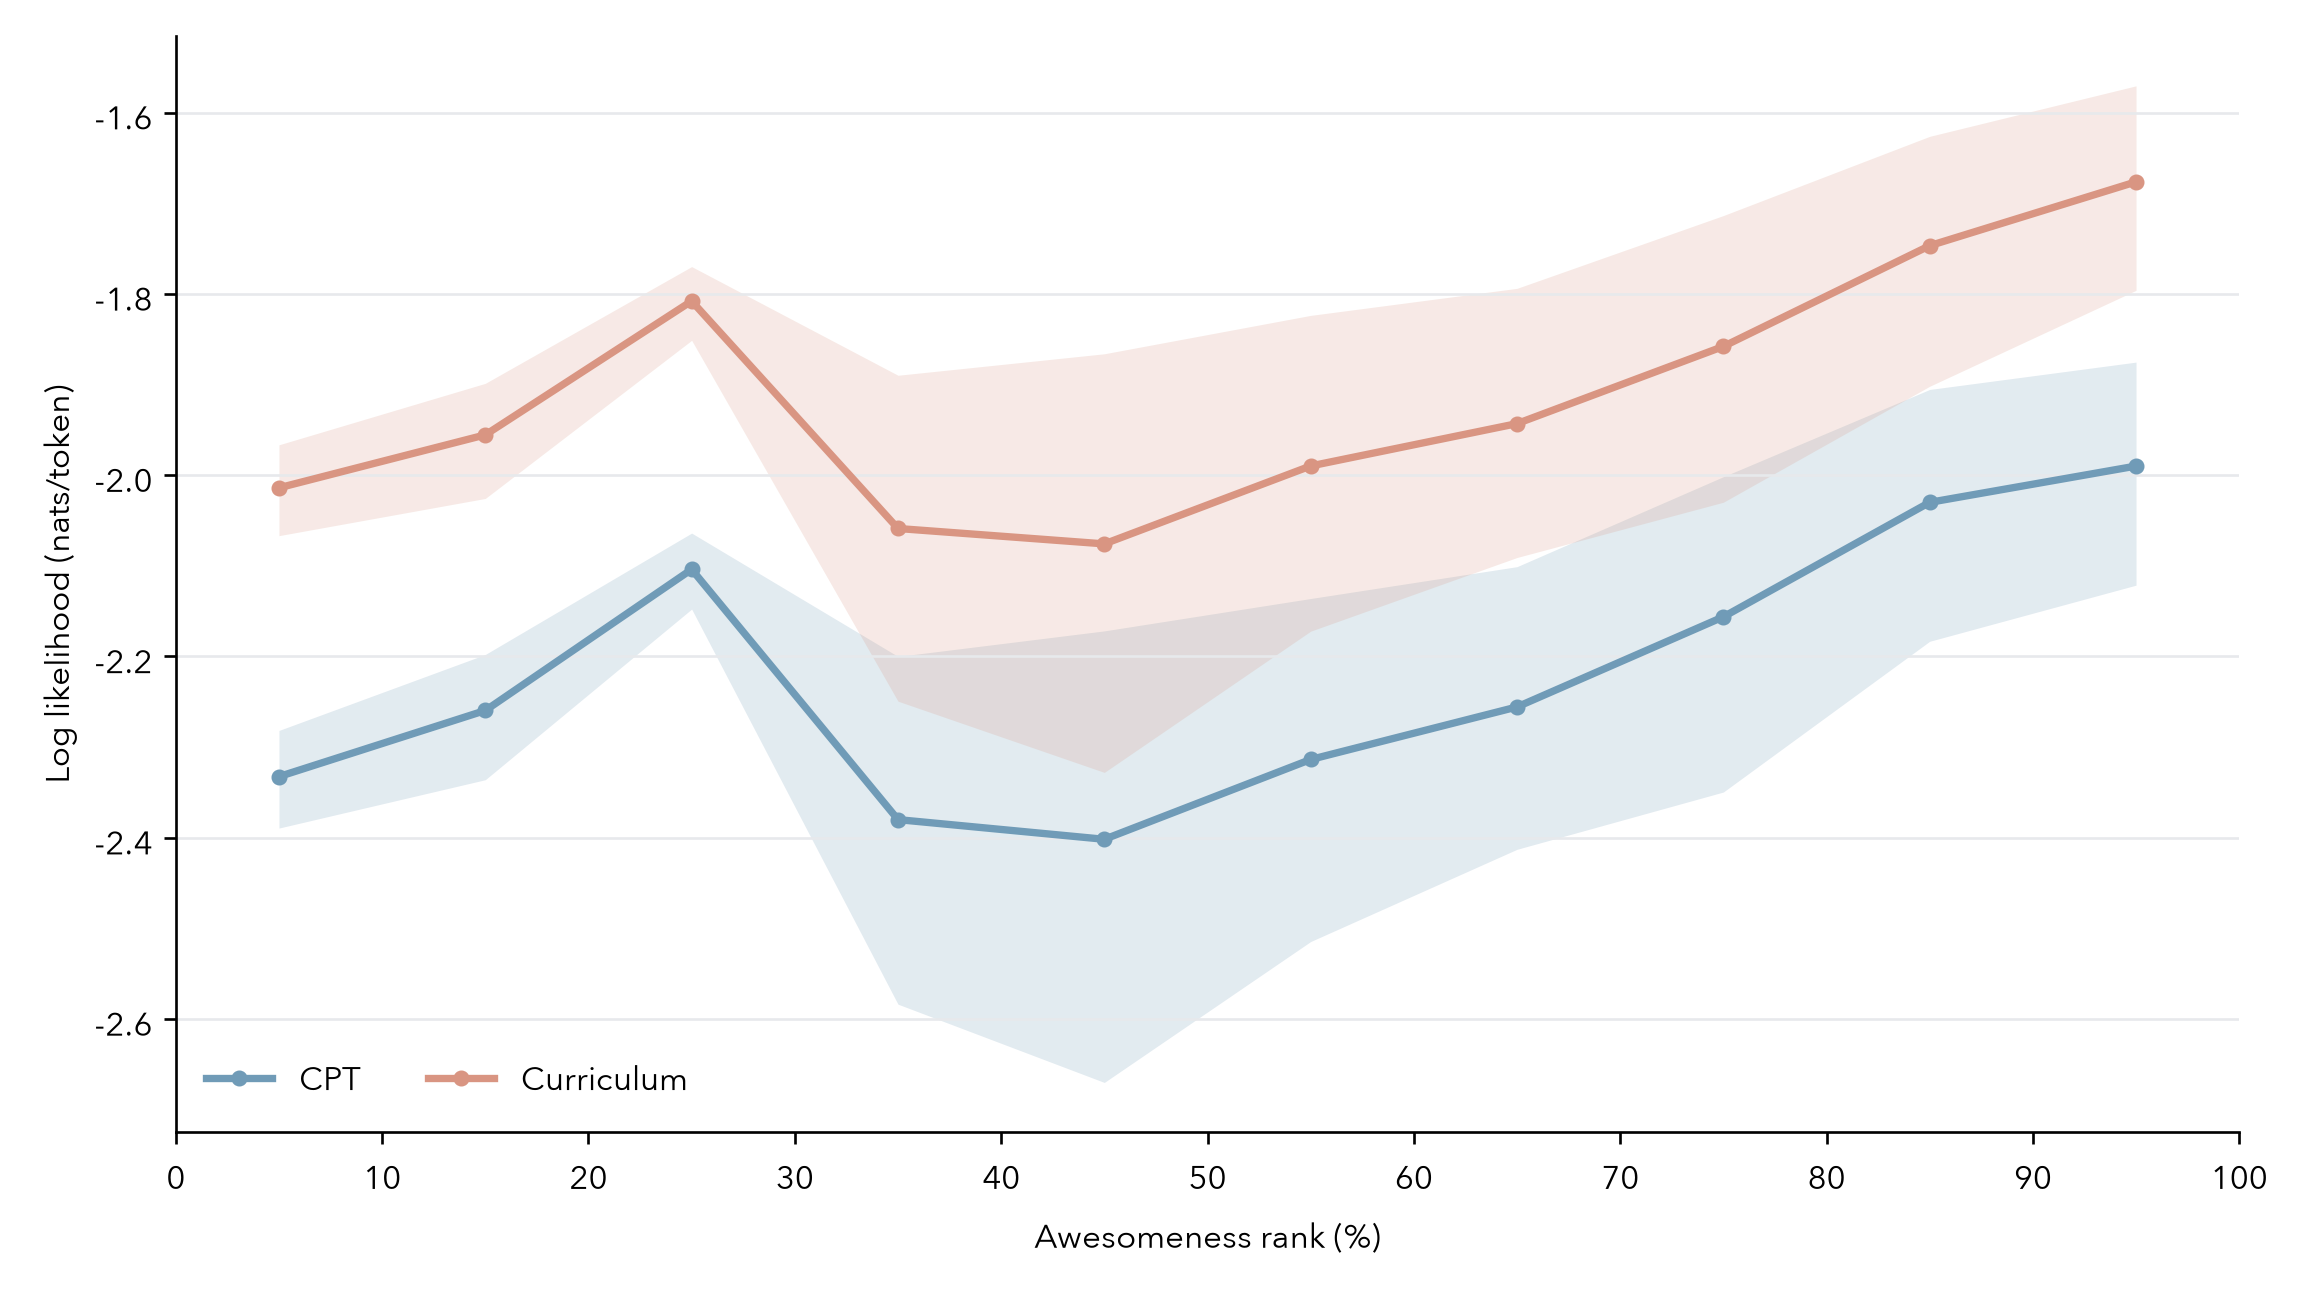
El gráfico visualiza cómo la estrategia de entrenamiento influyó en la capacidad del modelo para generar código de alta calidad en varios niveles de popularidad.
Si bien el modelo mejoró con éxito la probabilidad de código 'bello', el autor señaló que las ganancias se distribuyeron en todos los rangos de awesomeness, incluidos aquellos que nunca se vieron durante la fase de currículo. El proyecto destaca un cambio de la generación de código puramente funcional hacia una síntesis impulsada por la estética, donde el modelo sirve como un socio colaborativo en el proceso creativo. El autor ha lanzado el modelo 'Demoscener-7B' y el conjunto de datos asociado en HuggingFace para una mayor exploración.
Una limitación de este enfoque es la naturaleza subjetiva de la función de recompensa. Aunque el gusto personal del autor se inyectó en el modelo a través de RLHF, los resultados de una prueba de preferencia ciega realizada por un tercero confirmaron que las salidas del modelo eran favorables, pero la estética 'correcta' sigue siendo un objetivo móvil. Además, la dependencia del modelo de las peculiaridades específicas del entorno JavaScript de Dwitter significa que su producción creativa está actualmente atada a las limitaciones y capacidades de esa plataforma específica.
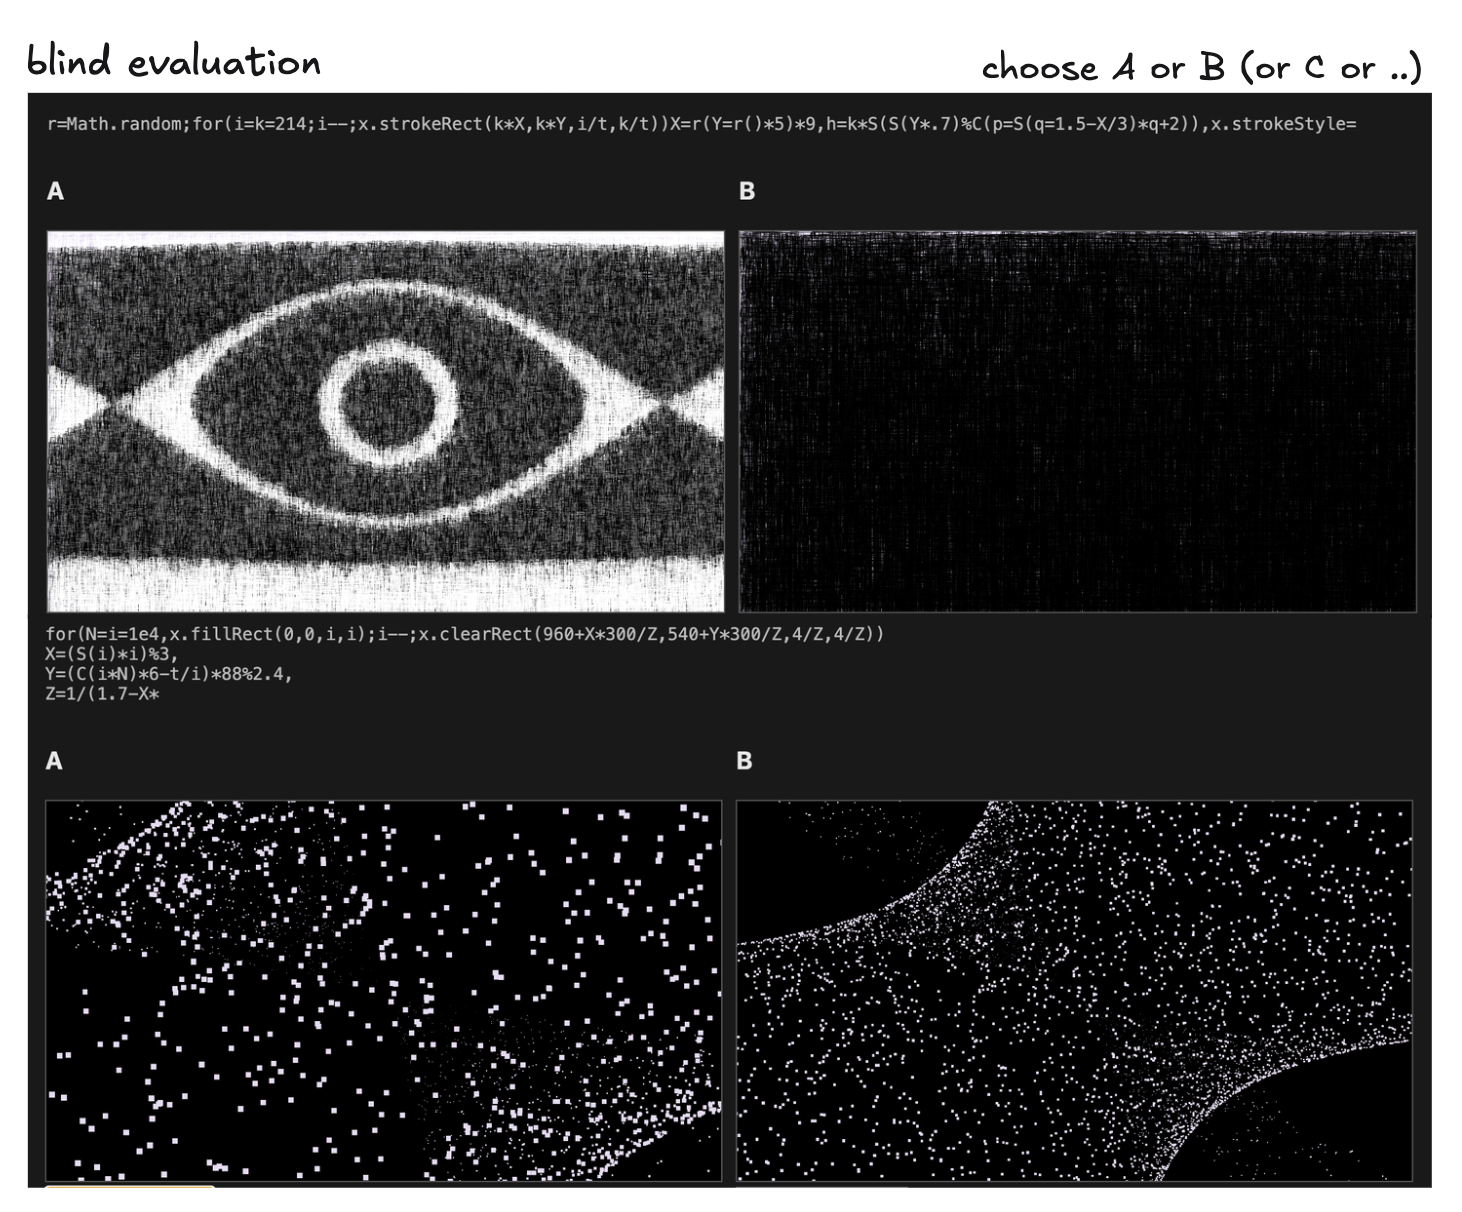
Este gráfico proporciona evidencia de que la retroalimentación humana y el entrenamiento por currículo orientaron con éxito al modelo hacia estéticas preferidas.
En última instancia, el proyecto demuestra cómo los conjuntos de datos especializados y la retroalimentación humana pueden orientar a los modelos de lenguaje de gran tamaño hacia dominios creativos de nicho y altamente restringidos. Al tratar el código como un lenguaje productivo, el autor convirtió un desafío técnico —terminar un demo complejo y optimizado— en un proceso exploratorio donde la IA sugiere la siguiente rama visual posible, permitiendo al creador humano curar y refinar el resultado final.