La traducción de fans de 'The Legend of Xanadu' tardó más de una década en completarse porque el motor del juego fue construido de una manera que mezclaba código ejecutable y cadenas de texto de forma desordenada, convirtiéndolo en uno de los títulos más difíciles de hackear en la biblioteca de PC Engine. El proyecto, que comenzó en 2011, requirió la creación de herramientas completamente nuevas para descompilar y recompilar el guion del juego antes de que se pudiera insertar una sola línea en inglés.
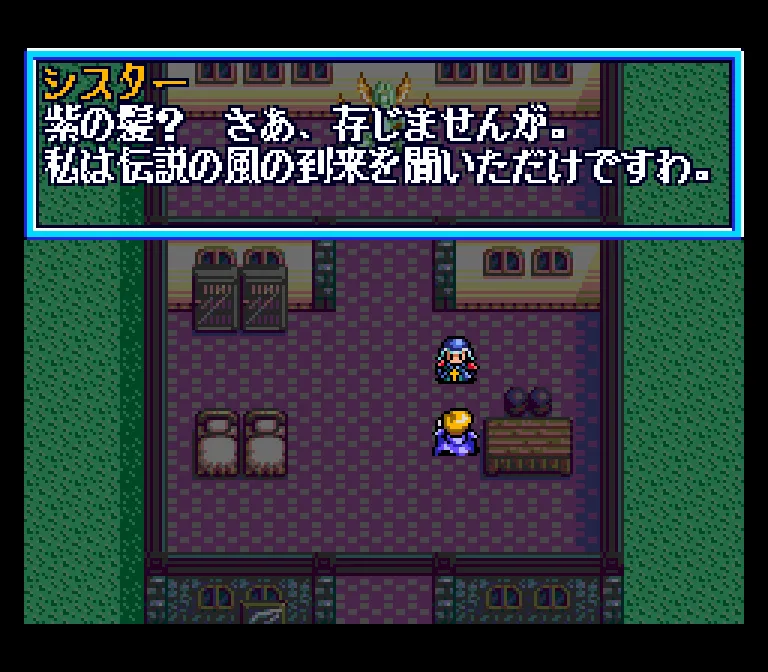
Esta imagen muestra el estado original del juego antes de que comenzara el proyecto de traducción de 15 años.
Superando un motor no estándar
A diferencia de muchos RPG de PC Engine que almacenaban el texto en bloques de memoria grandes y separados, 'The Legend of Xanadu' utilizaba una estructura compleja donde los guiones estaban mezclados con funciones de lenguaje ensamblador. Esto significaba que simplemente encontrar un bloque de texto y reemplazarlo rompería la ejecución del juego.
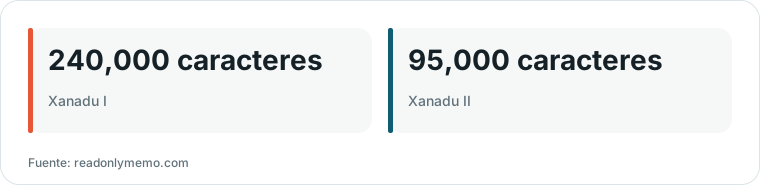
Gráfico elaborado por HN Digest a partir de cifras reportadas por readonlymemo.com; los valores se muestran como aparecen en la fuente.
Para resolver esto, el programador retirado Elmer desarrolló un descompilador de guiones completo y un recompilador correspondiente. Estas herramientas permitieron al equipo aislar los datos del guion del código ejecutable, permitiéndoles modificar el texto sin que el motor del juego fallara.
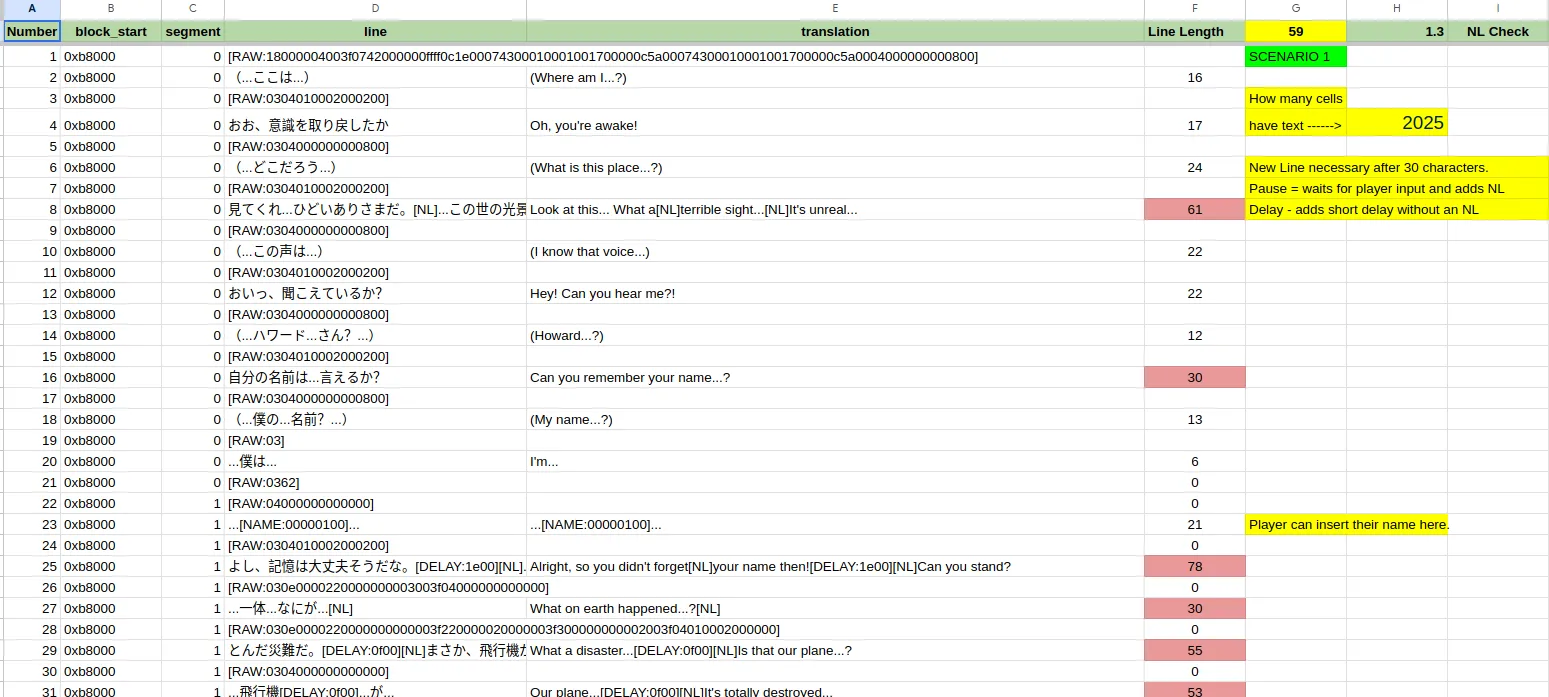
Esta imagen proporciona un ejemplo visual de los datos del guion que requirieron un descompilador personalizado para aislarse del código ejecutable.
“Parece que todo fue armado en un ensamblador. Por lo tanto, mezcla código y cadenas de forma desordenada.”
— Finding Xanadu: Inside a JRPG classic translation 15 years in the making
Gestión de memoria y compresión
Las traducciones al inglés a menudo requieren significativamente más espacio que el texto original en japonés. En este proyecto, algunos segmentos en inglés eran hasta un 50% más voluminosos que los guiones originales, creando un grave déficit de memoria en el hardware limitado de PC Engine.
Elmer abordó esto implementando un método de compresión personalizado (SWD5) que era más eficiente que el utilizado por los desarrolladores originales. Al recomprimir los bloques de datos del juego, el equipo liberó suficiente espacio 'precioso' para albergar el diálogo expandido en inglés.
La solución de los subtítulos
El juego presentaba escenas con voces que carecían de texto acompañante, lo que creaba un dilema para los traductores. Si bien un doblaje completo en inglés era la solución ideal, el equipo encontró que era técnicamente difícil coordinar a suficientes actores voluntarios para completar el proyecto.
El equipo finalmente optó por una solución técnica 'difícil': descubrieron que la VRAM del juego tenía entradas de paleta no utilizadas que podían usarse para mostrar sprites. Utilizaron estas entradas para mostrar subtítulos, lo que requirió que el equipo contara manualmente los fotogramas y ajustara el tiempo de las escenas para asegurar que el texto apareciera en sincronía con la actuación de voz en japonés.