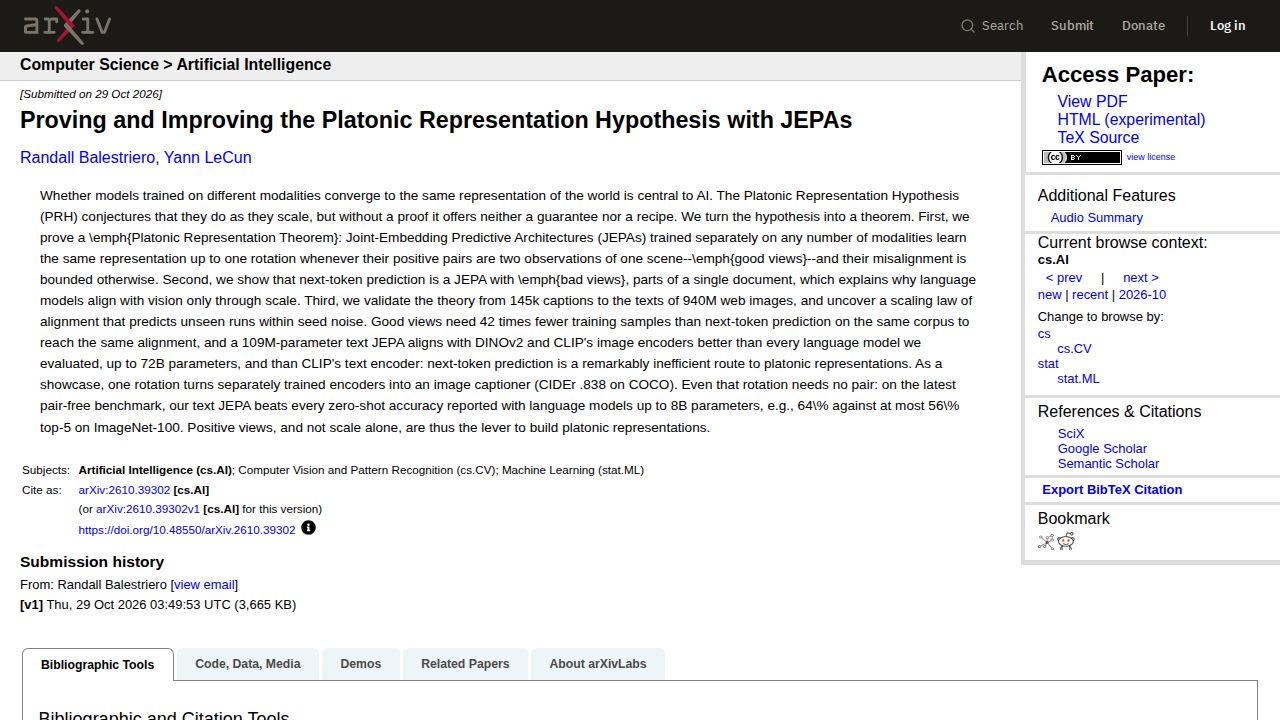
La Hipótesis de la Representación Platónica (PRH) postula que, a medida que los modelos de inteligencia artificial escalan, eventualmente convergerán en una representación compartida y universal del mundo, independientemente de si fueron entrenados originalmente en texto, imágenes u otras modalidades. Si bien esto ha sido una conjetura central en la investigación de IA, carecía de una prueba formal. Una investigación reciente de Randall Balestriero y Yann LeCun aborda esto estableciendo un 'Teorema de la Representación Platónica'. Este teorema demuestra que las Arquitecturas Predictivas de Incrustación Conjunta (JEPAs) entrenadas en diferentes modalidades aprenderán la misma representación —hasta una rotación única— siempre que sus pares positivos consistan en 'buenas vistas', que son múltiples observaciones de la misma escena donde el desajuste entre las vistas está acotado.
Los autores contrastan esto con el método estándar de 'predicción del siguiente token' utilizado para entrenar la mayoría de los modelos de lenguaje modernos. Categorizan la predicción del siguiente token como una JEPA entrenada en 'malas vistas', específicamente, fragmentos de un solo documento. Debido a que estos fragmentos son menos consistentes que múltiples vistas de una sola escena, los modelos de lenguaje requieren una escala masiva para alinear sus representaciones internas con las de los modelos de visión. El estudio revela una ley de escala específica de alineación, mostrando que las 'buenas vistas' son significativamente más eficientes: requieren 42 veces menos muestras de entrenamiento que la predicción del siguiente token para alcanzar el mismo nivel de alineación entre modalidades.
En pruebas prácticas, los investigadores demostraron que una JEPA de texto relativamente pequeña de 109M de parámetros superó a cada modelo de lenguaje que evaluaron hasta 72B de parámetros en su capacidad para alinearse con codificadores de imágenes como DINOv2 y CLIP. Esto sugiere que la dependencia actual en la escala masiva para cerrar la brecha entre el texto y la visión es un subproducto del uso de estructuras de datos ineficientes. Si bien las 'buenas vistas' ofrecen una ruta mucho más rápida hacia un modelo de mundo compartido, requieren emparejamientos de datos específicos —múltiples observaciones de una sola escena— en lugar de los datos secuenciales ubicuos que actualmente impulsan el desarrollo de los modelos de lenguaje grandes. Este hallazgo cambia el enfoque de simplemente aumentar el tamaño del modelo a mejorar la calidad y estructura de las vistas de entrenamiento para lograr una alineación más rápida y eficiente.