Figma está cambiando su estrategia de IA hacia el post-entrenamiento especializado para abordar los matices del trabajo de diseño iterativo. Si bien los modelos de frontera son capaces de realizar tareas amplias, a menudo tienen dificultades con las ediciones pequeñas y no verificables que los diseñadores realizan a diario, como ajustar el espaciado de un botón, cambiar un color específico o reformular un diseño basado en comentarios. Para resolver esto, Figma desarrolló un agente de diseño que utiliza un modelo de edición de primera parte entrenado específicamente para comprender la sintaxis interna de Figma y los activos del sistema de diseño. Esto permite que el agente realice iteraciones precisas directamente en el lienzo, donde la velocidad y la precisión son fundamentales para mantener el flujo de trabajo del diseñador.
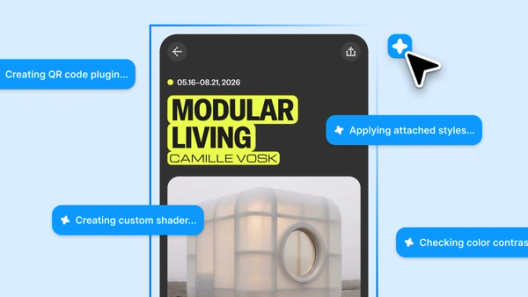
Esta imagen ilustra la capacidad del agente de diseño para realizar iteraciones precisas directamente en el lienzo, como ajustar espacios y colores.
El núcleo técnico de este enfoque implica el ajuste fino supervisado (SFT) utilizando el formato de archivo nativo de Figma. Al representar los diseños en su estructura nativa, el modelo aprende a producir cambios que pueden aplicarse directamente de nuevo en el lienzo. Figma construyó un flujo de generación de 'autocuración' donde modelos 'maestros' más grandes intentan realizar ediciones, las cuales son luego verificadas por validadores deterministas y jueces de modelos visuales. Si una edición falla en una comprobación —como causar texto superpuesto o iconos recortados—, el flujo utiliza la retroalimentación del evaluador para revisar la salida. Este método permitió que un modelo Llama 3.3 70B anterior, entrenado con más de 250,000 ejemplos, se volviera competitivo con modelos de primer nivel en tareas de edición específicas.
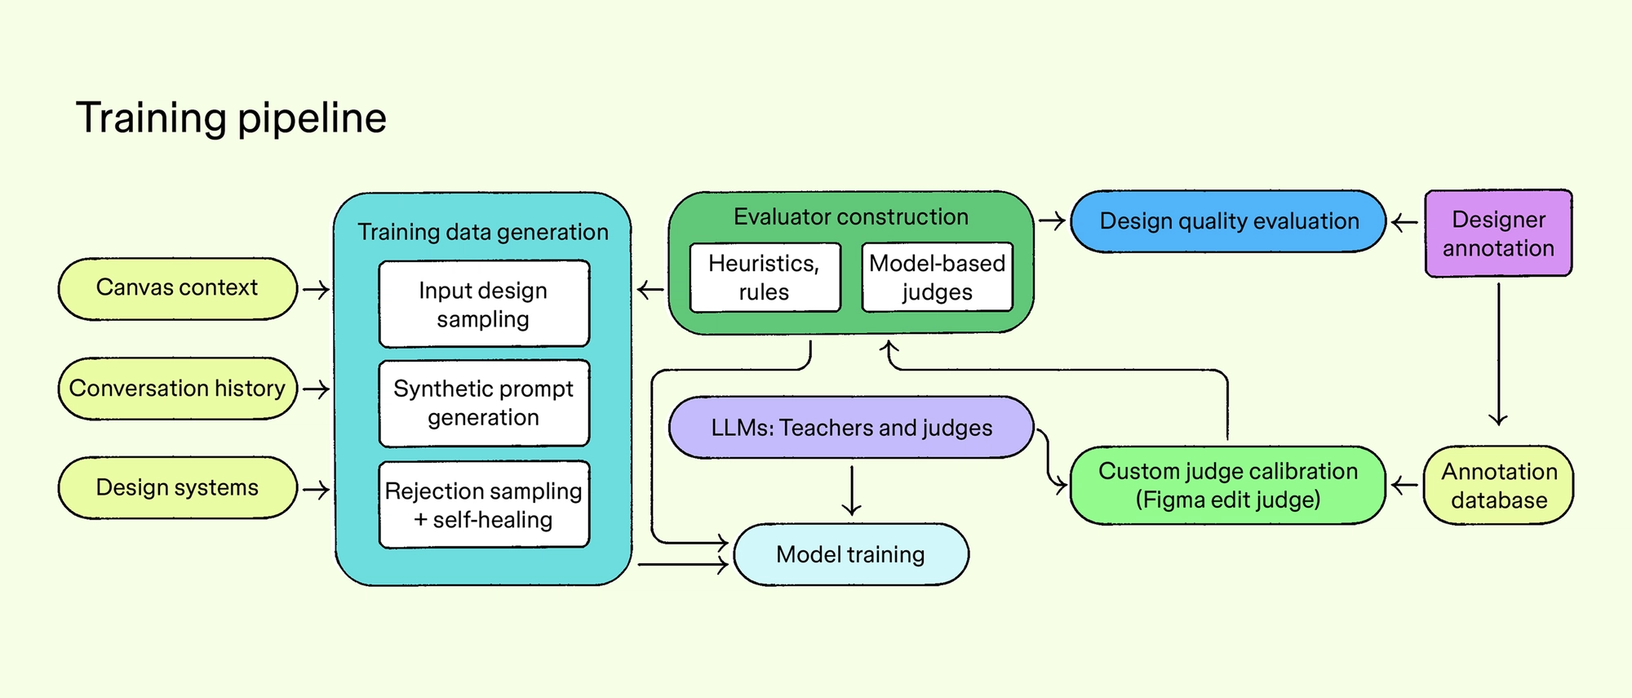
Este diagrama explica el núcleo técnico del enfoque, incluyendo el flujo de generación de autocuración y la construcción del evaluador.
Sin embargo, Figma señaló que el SFT por sí solo tiene limitaciones, específicamente con respecto al 'aprendizaje por imitación', que puede causar que un modelo imite los datos de entrenamiento demasiado de cerca a expensas de la generalización. Para contrarrestar esto, la empresa está integrando el Aprendizaje por Refuerzo (RL) en su receta de entrenamiento. Este cambio se centra en mejorar la diversidad de los ejemplos de entrenamiento y dar forma a los modelos de recompensa basados en criterios escritos por expertos que reflejen las prioridades reales de los diseñadores. Los resultados iniciales indican que este enfoque especializado es eficaz: en pruebas directas, el nuevo agente igualó o superó a las versiones de producción anteriores el 62% de las veces, al tiempo que redujo el costo promedio por mensaje y mejoró las velocidades de las tareas típicas en aproximadamente un 20%%.
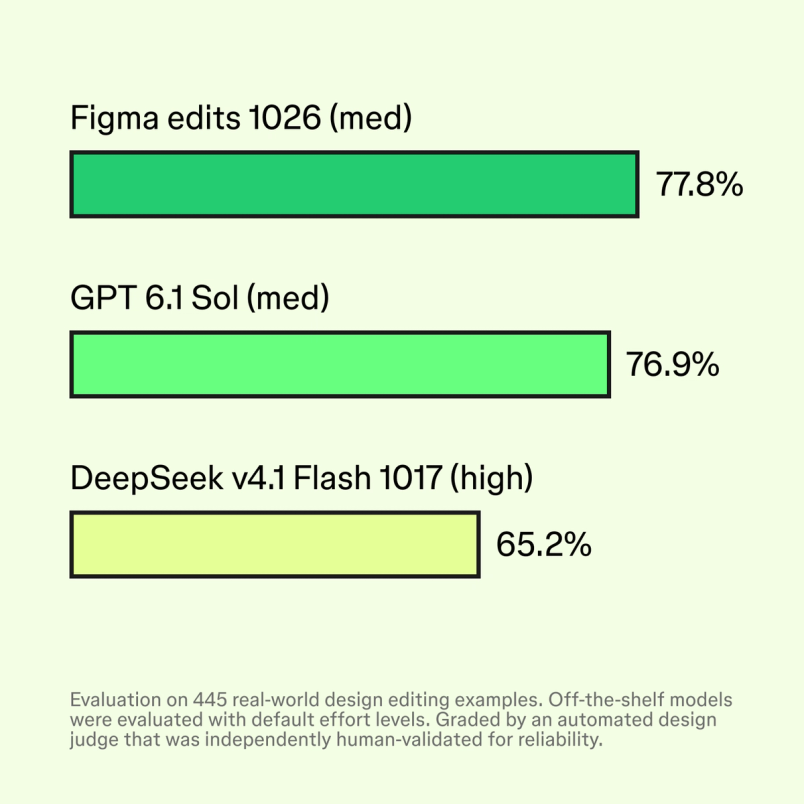
Este gráfico respalda la afirmación de que el nuevo agente igualó o superó a las versiones de producción anteriores en pruebas directas.