Muchos sistemas de software dependen del mapeo de cadenas a valores específicos, como la identificación de métodos HTTP (GET, POST), el reconocimiento de nombres de encabezados o el análisis de palabras clave de compiladores. En C++, el enfoque estándar suele ser el uso de `std::unordered_map`. Sin embargo, este método incurre en costos de ejecución porque las claves a menudo se conocen en tiempo de compilación. Las tablas hash estándar deben manejar posibles colisiones mediante el hashing de toda la cadena, la selección de un cubo y, potencialmente, el recorrido de una lista enlazada, todo lo cual introduce una sobrecarga que puede evitarse si el conjunto de claves es estático.
Para resolver esto, la biblioteca utiliza una función de hashing perfecto, una función diseñada específicamente para un conjunto fijo de claves para garantizar que ninguna de las dos claves se mapee en la misma ranura. El mecanismo sigue un diseño similar a la herramienta `gperf`: calcula una ranura sumando la longitud de la clave a valores pequeños de una tabla de asociación indexada por caracteres en posiciones específicas. Este proceso se ejecuta en tiempo de compilación utilizando funciones `constexpr`, lo que garantiza que el costo de ejecución sea mínimo. Por ejemplo, buscar una clave implica unas pocas cargas y una operación AND a nivel de bits para determinar la ranura, seguidas de una sola comparación. Esto elimina la necesidad de sondeo o de recorrer cadenas de colisión.
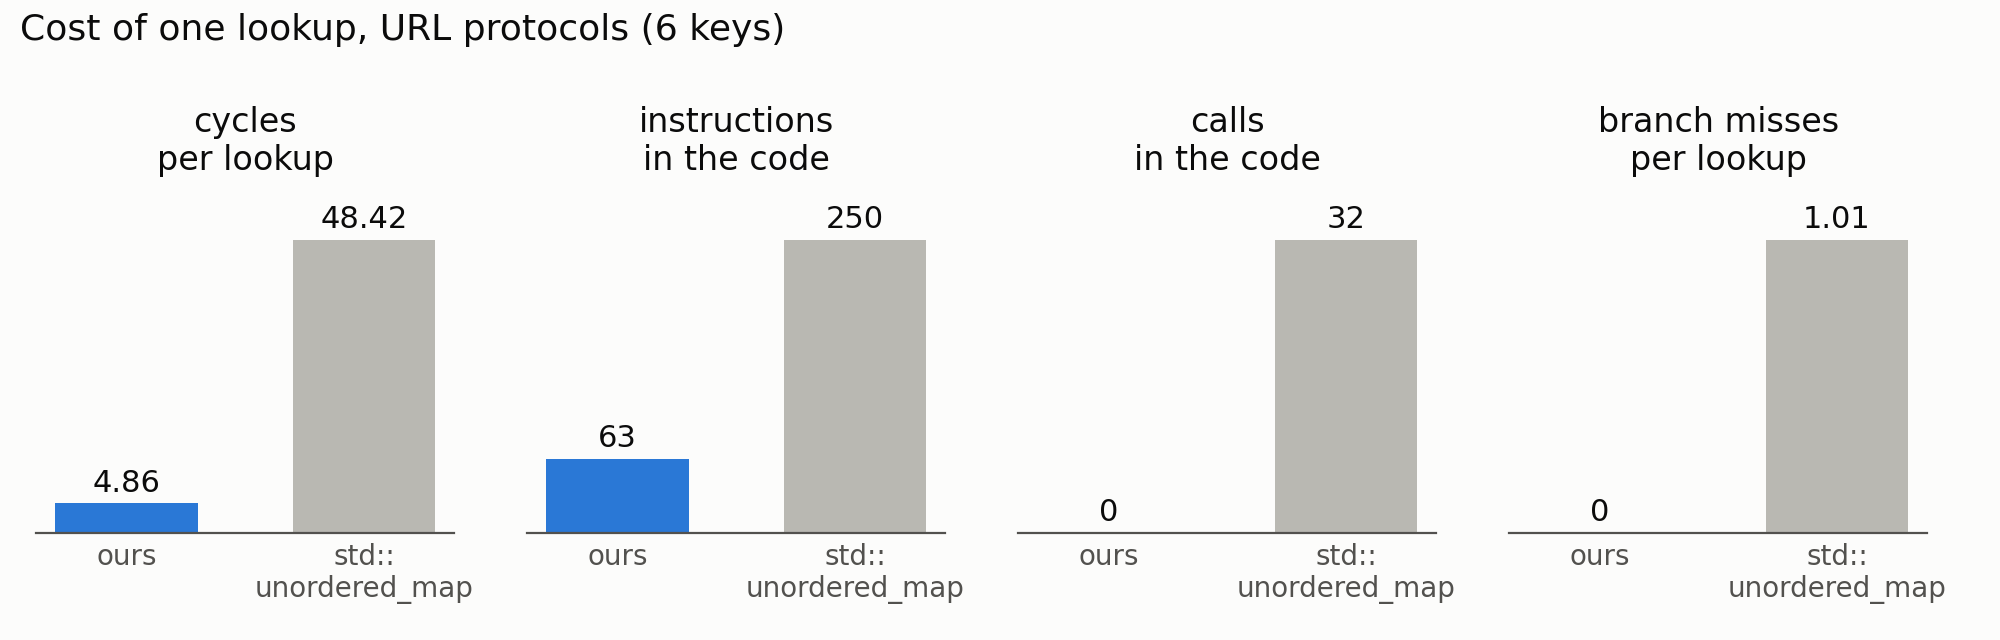
La imagen explica el costo mínimo de ejecución del proceso de búsqueda, que involucra solo unas pocas cargas y una operación a nivel de bits.
Más allá del hashing, la biblioteca optimiza la comparación de cadenas utilizando instrucciones SIMD (Single Instruction, Multiple Data). En lugar de iterar sobre los bytes con múltiples ramificaciones, el sistema carga la clave en un registro de 16 bytes y utiliza una instrucción de mezcla (como `tbl` en ARM NEON) para poner en cero los bytes que superan el final de la clave. Esto permite que una sola comparación vectorial valide la clave completa en solo unas pocas instrucciones. Las pruebas de rendimiento en un Apple M3 Max muestran que la biblioteca logra aproximadamente 1.3 ns por búsqueda para encabezados HTTP, lo que la hace hasta trece veces más rápida que `std::unordered_map`. Si bien este enfoque es altamente eficiente para claves conocidas, es menos adecuado para conjuntos dinámicos donde las claves se agregan o eliminan en tiempo de ejecución, ya que la función de hashing perfecto debe recalcularse para cualquier cambio en el conjunto de claves.
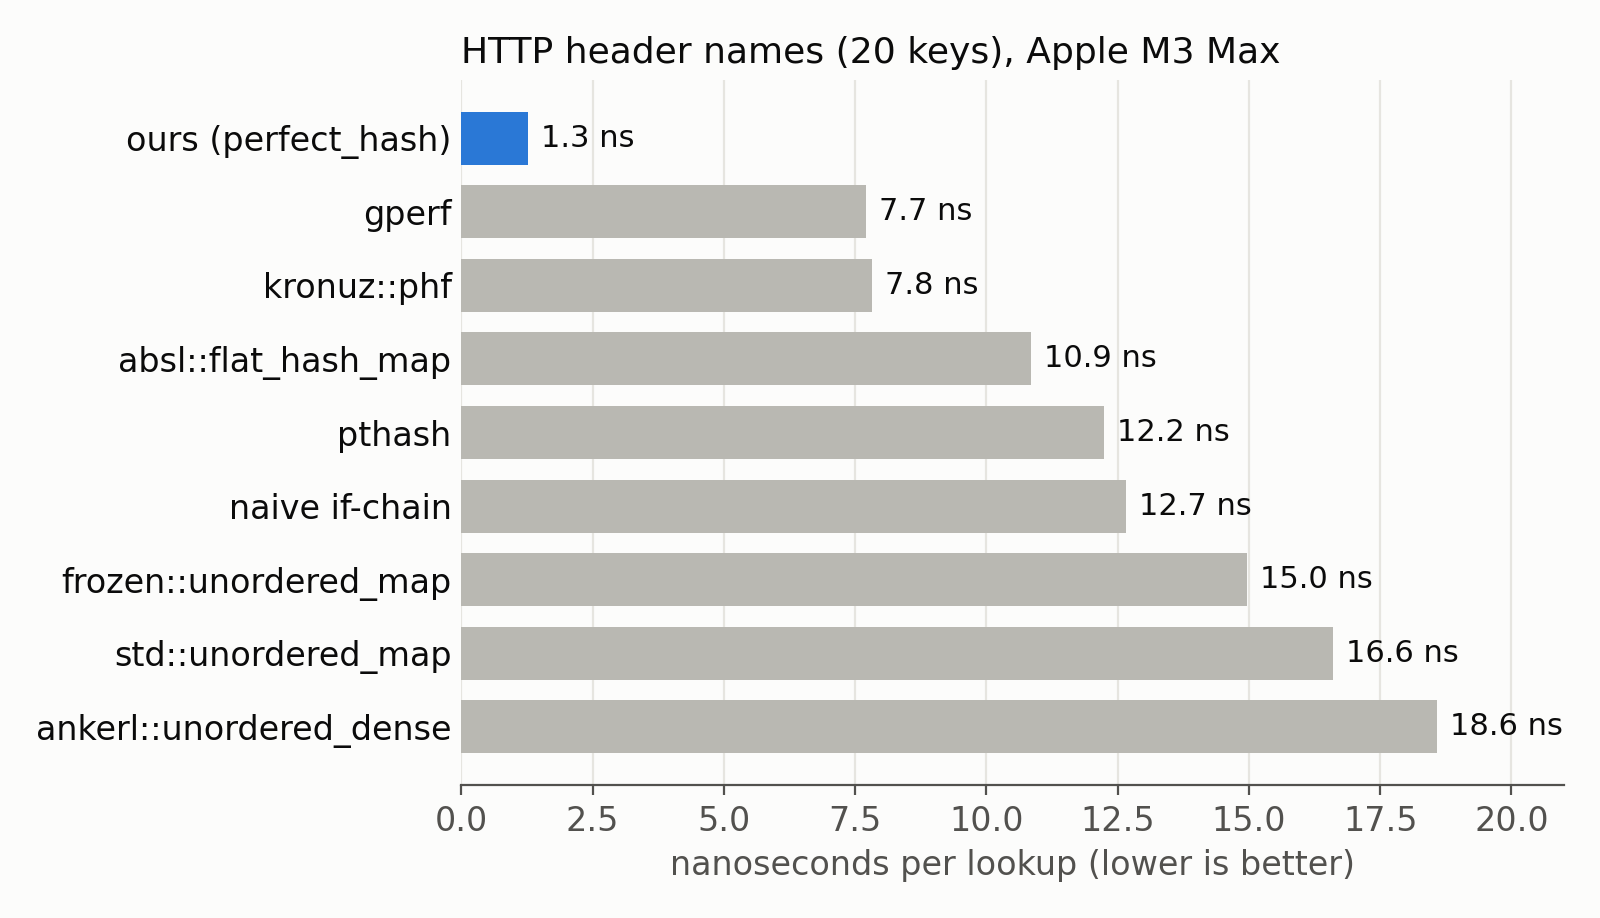
El gráfico ilustra la significativa ventaja de velocidad de la biblioteca de hashing perfecto sobre las implementaciones estándar para encabezados HTTP comunes.
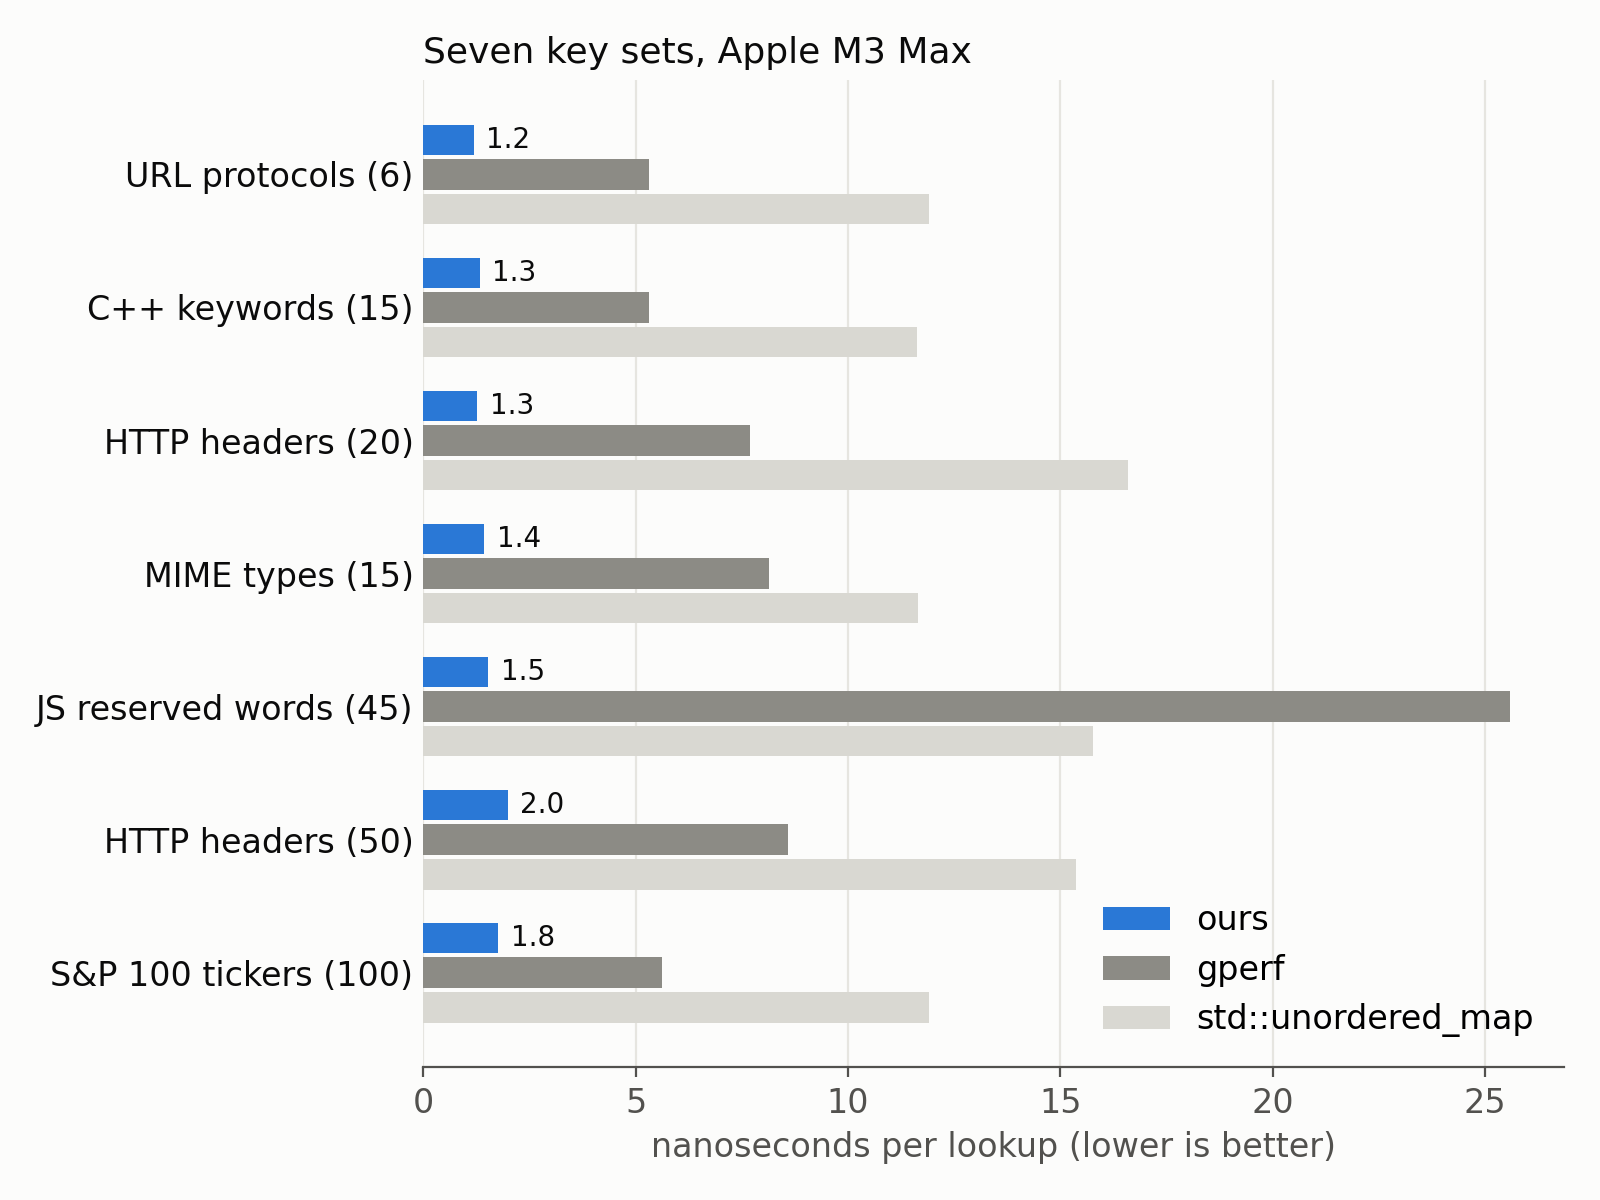
Esta figura demuestra la eficiencia de la biblioteca en diferentes tipos de conjuntos de claves estáticas, destacando su alto rendimiento de velocidad.