El panorama de la generación de imágenes por IA ha evolucionado rápidamente desde las primeras redes generativas antagónicas (GANs) hasta sofisticados sistemas multimodales. Mientras que los modelos iniciales tenían dificultades con detalles específicos como la anatomía humana y el texto legible, las iteraciones modernas han resuelto en gran medida estos problemas. Por ejemplo, la dificultad con las manos a menudo era el resultado de modelos que aprendían las manos como una textura en lugar de un componente estructural. Del mismo modo, la renderización de texto mejoró significativamente cuando se les dio a los modelos acceso a caracteres individuales en lugar de solo tokens basados en palabras. Hoy en día, la distinción principal en el campo reside entre los modelos de difusión —que suelen ser más rápidos y repetibles— y los modelos multimodales, que ofrecen un seguimiento de instrucciones superior y una renderización de texto nativa al procesar el lenguaje y las imágenes dentro de la misma arquitectura.
Para los desarrolladores y creadores, elegir la herramienta adecuada depende de los requisitos específicos del proyecto. Los modelos de difusión como Flux o SDXL suelen preferirse para la ejecución local, el procesamiento por lotes y resultados consistentes mediante 'seeds' (el ruido aleatorio inicial utilizado para iniciar la generación). En contraste, los modelos multimodales como los integrados en ChatGPT o Gemini destacan en la edición conversacional y las instrucciones de diseño complejas. Sin embargo, estos modelos a menudo ofrecen menos control sobre las dimensiones específicas de salida o las semillas. Una conclusión práctica clave para la producción es que los usuarios a menudo 'pagan por el lienzo' en lugar del contenido; una mesa de madera sencilla y una pintura al óleo compleja del mismo tamaño suelen costar lo mismo en términos de créditos de generación o tiempo de computación.
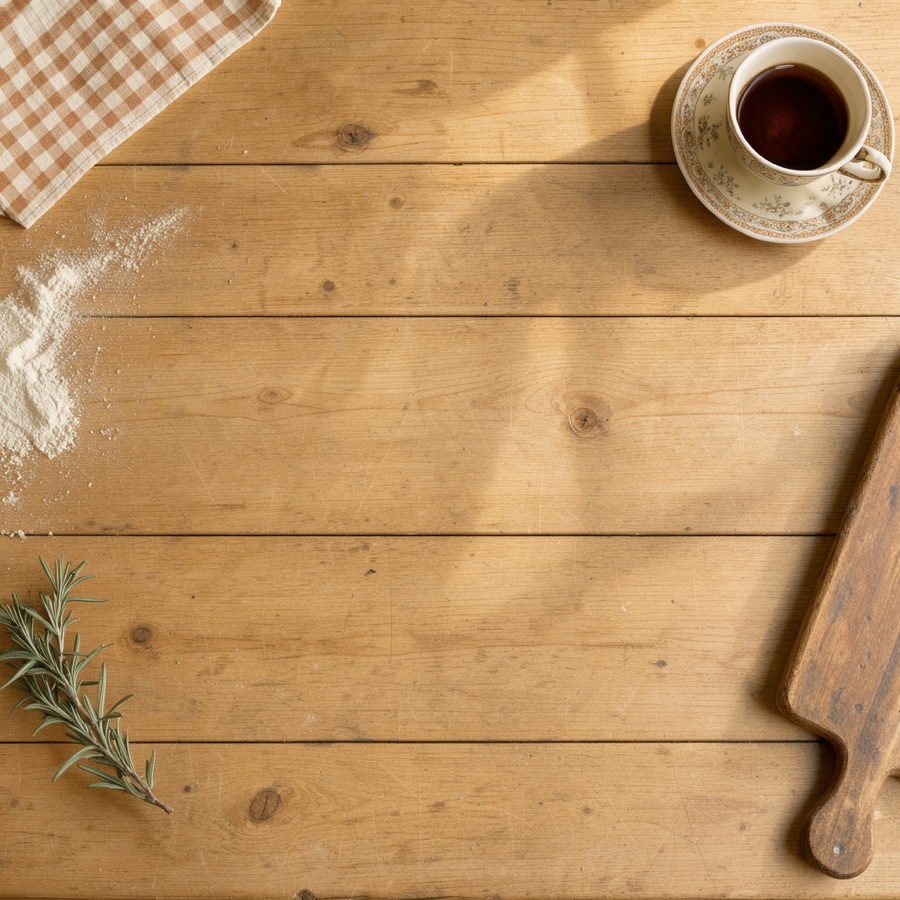
Esta imagen sirve como un ejemplo práctico de la salida de un modelo de difusión, ilustrando los resultados consistentes que se pueden lograr mediante semillas específicas y la selección del modelo.
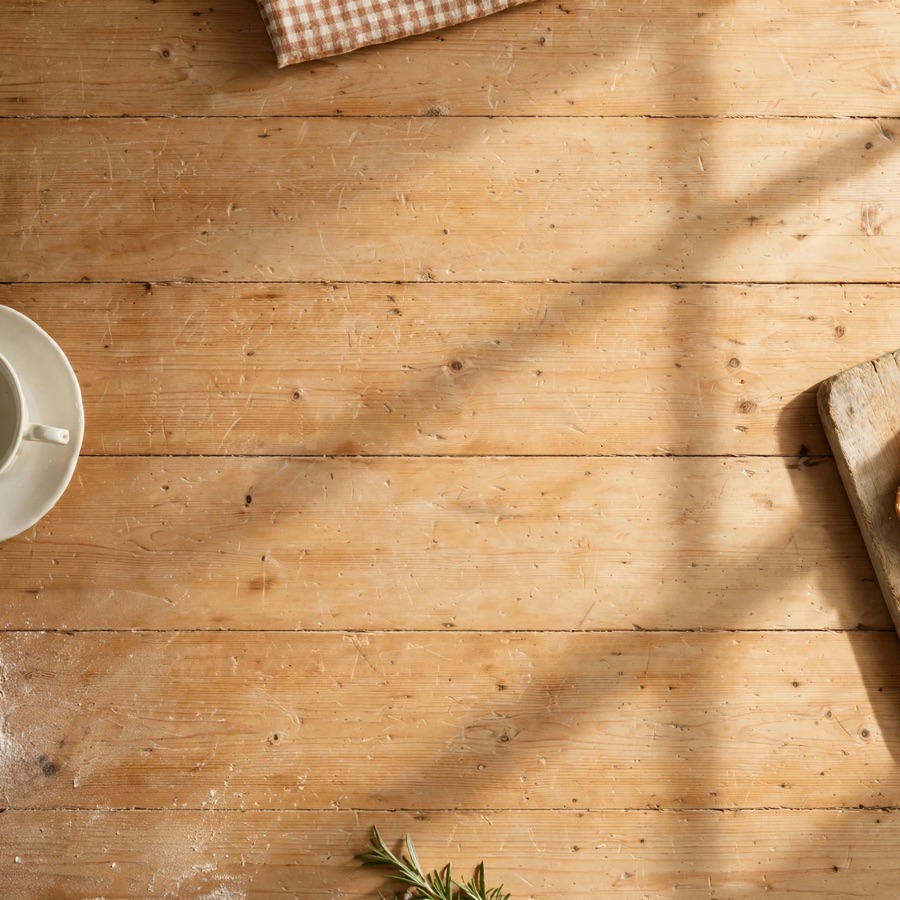
Esta imagen proporciona una comparación directa con el modelo FLUX, mostrando cómo un modelo multimodal interpreta el mismo prompt para una mesa de cocina.
Integrar la generación de imágenes en el código de producción requiere un cambio en la forma en que los desarrolladores manejan los fallos y la consistencia. Debido a que la generación de imágenes es un 'trabajo lento y propenso a fallos', es mejor manejarla tratando la salida como una tarea asíncrona. Se anima a los desarrolladores a utilizar una interfaz delgada frente a varios proveedores para tener en cuenta el hecho de que las APIs evolucionan rápidamente, con modelos que se retiran o actualizan con frecuencia. Para tareas de alta precisión como el diseño de UI o diseños específicos, un enfoque híbrido suele ser el más eficaz: utilizar la IA para la generación creativa de activos mientras se utiliza código tradicional para manejar requisitos exactos como el tamaño, la transparencia y la aplicación de paletas. Esto asegura que el 'gusto' de la IA se equilibre con la precisión de la ingeniería de software estándar.
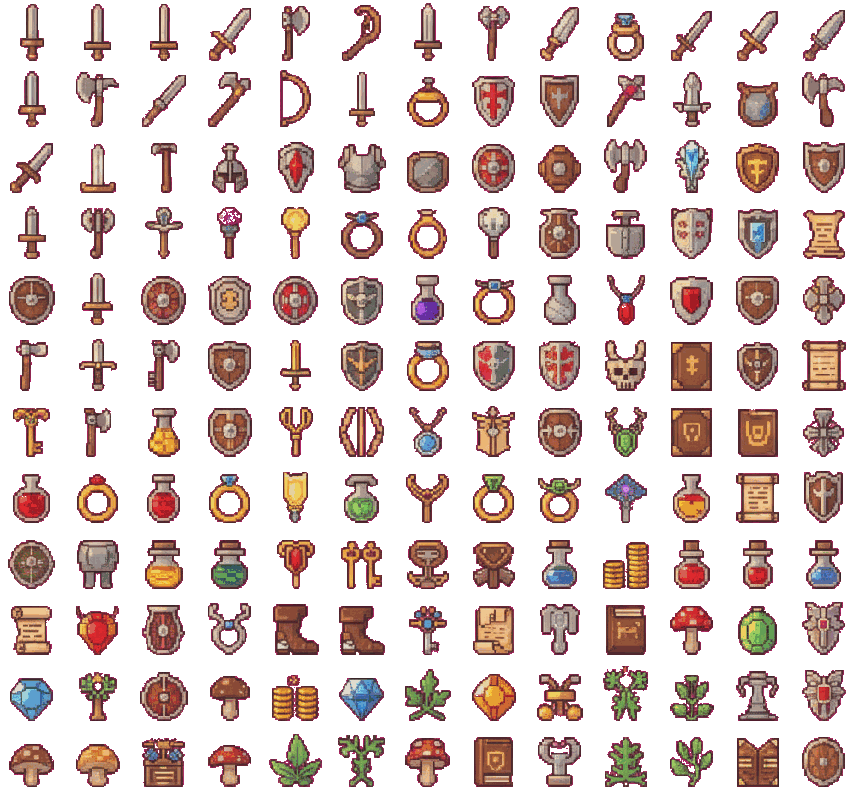
Esta imagen ilustra el enfoque híbrido de utilizar la IA para la generación creativa mientras se utiliza el código tradicional para el dimensionamiento preciso y la transparencia.
Una alternativa emergente a los modelos generativos estándar, particularmente para estilos como el pixel art, son los gráficos procedimentales. En lugar de generar un mapa de bits completo, este método implica el uso de LLMs para generar una secuencia de instrucciones de dibujo simples para recrear una escena. Este enfoque puede evitar problemas comunes de la generación, como el desalineamiento de la cuadrícula, las elecciones de paleta inconsistentes y el ruido de alta frecuencia, ofreciendo una vía diferente para lograr objetivos estéticos específicos sin la imprevisibilidad de la difusión pura.
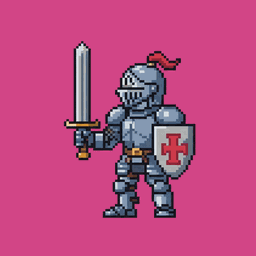
Esta imagen ilustra la estética específica del pixel art, que el artículo discute como un caso de uso para los gráficos procedimentales sobre los modelos generativos estándar.
El costo y la accesibilidad también varían significativamente en todo el ecosistema. Los precios para la generación basada en API pueden oscilar desde una fracción de un centavo hasta más de 15 centavos por imagen, dependiendo del modelo y el proveedor. Si bien la ejecución local elimina estos costos, requiere hardware significativo, como una GPU con al menos 7GB de memoria de video para modelos como Stable Diffusion. En última instancia, las tuberías más eficaces combinan las fortalezas creativas de la IA con la fiabilidad determinista del código tradicional para producir resultados pulidos y utilizables.