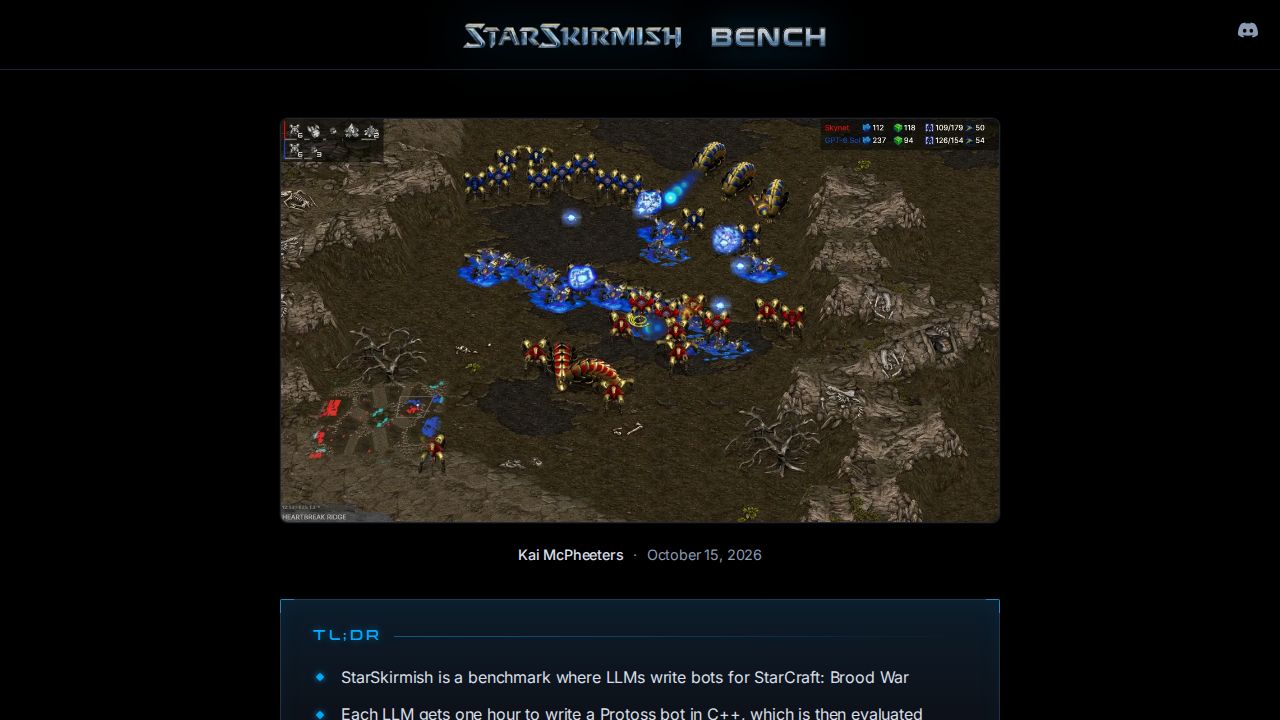
StarSkirmish Bench v0.2 es un marco de evaluación especializado diseñado para probar las capacidades de los modelos de lenguaje de gran tamaño (LLMs) en un entorno de estrategia en tiempo real complejo. A diferencia de los benchmarks de acción directa donde una IA podría controlar unidades directamente, este benchmark requiere que el LLM escriba código funcional para jugar StarCraft: Brood War. El proceso implica que el modelo genere un bot capaz de gestionar las intrincadas mecánicas del juego, tales como la recolección de recursos, la ubicación de construcciones y la gestión de unidades. El benchmark ofrece una visión única de cómo los modelos manejan el razonamiento de múltiples pasos y la traducción de estrategias de alto nivel en lógica ejecutable.
Resultados recientes del benchmark muestran un rendimiento variable entre los modelos insignia de los principales proveedores. Por ejemplo, el modelo Gemini 4 Argon fue probado junto con modelos de OpenAI, Anthropic y Muse. Un detalle técnico clave del benchmark es el uso de la biblioteca de simulación de combate FastApproximation. Esta biblioteca permite que los bots generados por el LLM realicen mejores predicciones de combate que algunos bots de menor nivel escritos por humanos, permitiéndoles ganar mediante el intercambio efectivo de ejércitos. Sin embargo, el benchmark también revela limitaciones; mientras que algunos modelos pueden dominar rápidamente la logística básica —como establecer una estrategia de 'una base Dragoon + Observer'— pueden tener dificultades contra bots de alto nivel (como Locutus o BananaBrain) que poseen una ejecución superior y tácticas especializadas.
El benchmark ha generado debate sobre la naturaleza del 'razonamiento' frente a la 'recuperación' de los LLMs. Debido a que StarCraft tiene una vasta historia de implementaciones de bots en plataformas como GitHub, algunos observadores cuestionan si los modelos simplemente están recuperando código existente de sus conjuntos de entrenamiento. No obstante, algunas pruebas sugieren que el código producido por estos modelos no siempre se asemeja a los bots específicos encontrados en los datos de entrenamiento. Además, se han observado correlaciones entre el rendimiento en StarSkirmish y otros benchmarks, como los rankings de Go 9x9 y diversas tareas de programación de aprendizaje automático. Estos paralelismos sugieren que la capacidad de navegar por la 'tediosa' logística de StarCraft puede ser un indicador fiable de la capacidad general de un modelo para resolver problemas de programación complejos y multivariables.
Una variable significativa en estos resultados es el 'harness' o entorno en el que operan los modelos. El rendimiento puede cambiar drásticamente según la CLI (Interfaz de Línea de Comandos) específica utilizada, los niveles de pensamiento habilitados y las herramientas disponibles para el modelo. En StarSkirmish Bench, a menudo se restringe a los modelos el uso de búsqueda web o herramientas de obtención externa, obligándolos a depender totalmente de su conocimiento interno y del entorno proporcionado para navegar por la documentación y las mecánicas del juego. Esto crea una prueba controlada de las capacidades inherentes del modelo en lugar de su capacidad para buscar soluciones durante la tarea.