La decodificación especulativa es una técnica utilizada para acelerar la generación de texto por parte de los Modelos de Lenguaje de Gran Escala (LLM). En un proceso de decodificación estándar, un modelo genera un token a la vez, lo cual es una operación 'limitada por memoria'. Esto significa que la GPU pasa más tiempo esperando a que los parámetros del modelo se carguen desde la memoria global a la memoria local que realizando los cálculos matemáticos reales (operaciones de punto flotante, o FLOPs). Debido a que la GPU no se utiliza plenamente durante estos pasos, existe una capacidad de cómputo 'desperdiciada' disponible.
La decodificación especulativa aborda esto utilizando un modelo de 'borrador' pequeño y rápido para proponer una secuencia de varios tokens a la vez. Luego, un modelo más grande y capaz verifica toda esta secuencia en un solo paso hacia adelante. Si bien esto en realidad aumenta el número total de FLOPs ejecutados —ya que el modelo grande debe procesar los tokens del borrador—, cambia la naturaleza del trabajo. Al procesar múltiples tokens simultáneamente, la operación se vuelve 'limitada por cómputo', donde la potencia de procesamiento de la GPU se emplea por completo. En tamaños de lote bajos (donde el sistema no está ya saturado con múltiples solicitudes simultáneas), esto permite que el modelo complete una sola secuencia mucho más rápido al utilizar el cómputo 'libre' que de otro modo estaría inactivo.
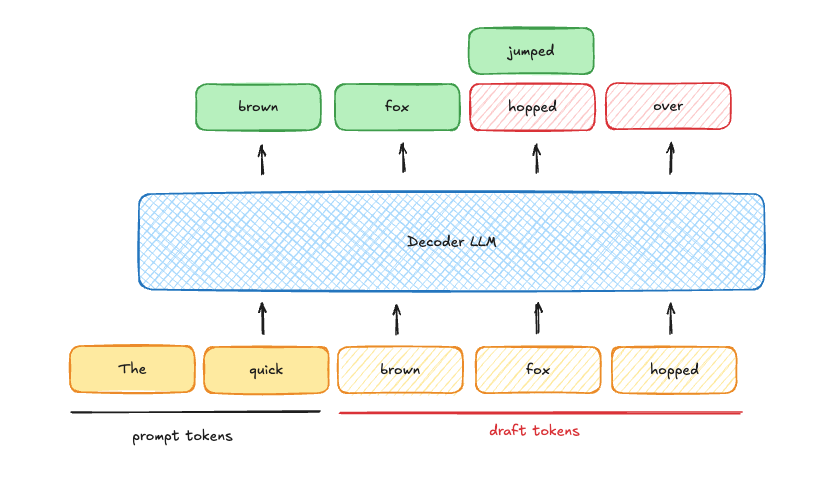
Esta figura ilustra el mecanismo central de la decodificación especulativa donde un modelo grande verifica múltiples tokens de borrador simultáneamente.
Sin embargo, esta eficiencia no es absoluta y depende en gran medida de la 'tasa de aceptación' de los tokens del borrador. Cada token rechazado representa un trabajo desperdiciado, ya que el modelo grande gastó ciclos de cómputo en una propuesta que finalmente fue descartada. Esto crea un equilibrio entre la 'amplitud' (procesar más secuencias a la vez) y la 'profundidad' (especular más tokens para una sola secuencia). Con un alto rendimiento, si el tamaño del lote es lo suficientemente grande como para saturar el cómputo de la GPU, la decodificación especulativa puede volverse contraproducente. Es por esto que algunos marcos de servicio, como vLLM, ofrecen opciones para desactivar automáticamente la decodificación especulativa cuando el tamaño del lote alcanza un cierto umbral. La investigación en especulación dinámica busca resolver esto ajustando la 'profundidad' de la especulación por secuencia basándose en el cómputo disponible actual, en lugar de usar un número fijo de tokens para cada paso. (Fuente: https://jbarrow.ai/2026-10-08-why-is-speculative-decoding-fast/)
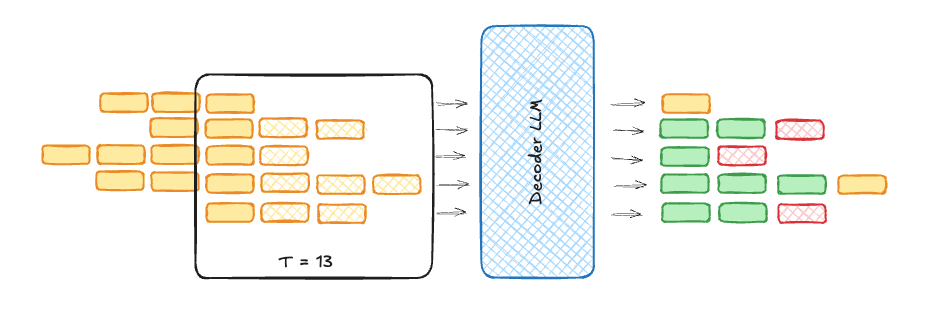
Esta imagen demuestra la especulación dinámica, donde la profundidad de la especulación se ajusta por secuencia para optimizar el rendimiento.
El principio subyacente de intercambiar la latencia limitada por memoria por el rendimiento limitado por cómputo también se observa en otros campos, como la robótica. En los modelos de Acción-Lenguaje-Visión (VLA), se utiliza el 'agrupamiento de acciones' (action chunking) para agrupar múltiples acciones futuras en un solo paso de inferencia. Esto ayuda a superar la lenta latencia de los modelos de alta dimensión, asegurando que el robot pueda ejecutar una secuencia coherente de movimientos en lugar de reaccionar a puntos aislados en el tiempo. (Fuente: https://news.ycombinator.com/item?id=50152539)
En última instancia, la velocidad de la decodificación especulativa es una cuestión de orquestación de hardware. Al alinear la carga de trabajo con las fortalezas de la GPU —realizando más cálculos mientras los datos ya están cargados— el sistema logra resultados más rápidos, incluso aunque el esfuerzo matemático total requerido para producir el texto final haya aumentado.