Un desarrollador ha lanzado una versión modificada del modelo Qwen3-4B-Instruct, denominada 'qwen3-4b-deslop', diseñada específicamente para eliminar las características estilísticas que a menudo se asocian con los modelos de lenguaje de gran tamaño (LLM). Estos 'tics' incluyen el uso frecuente de guiones largos, estructuras de listas repetitivas de tres elementos y frases de transición específicas como 'delve' o 'seamless'. Al utilizar una combinación de destilación y edición de neuronas, el desarrollador buscó producir un modelo que genere texto más cercano a los estilos de escritura humanos sin sacrificar su capacidad para proporcionar información fáctica correcta.
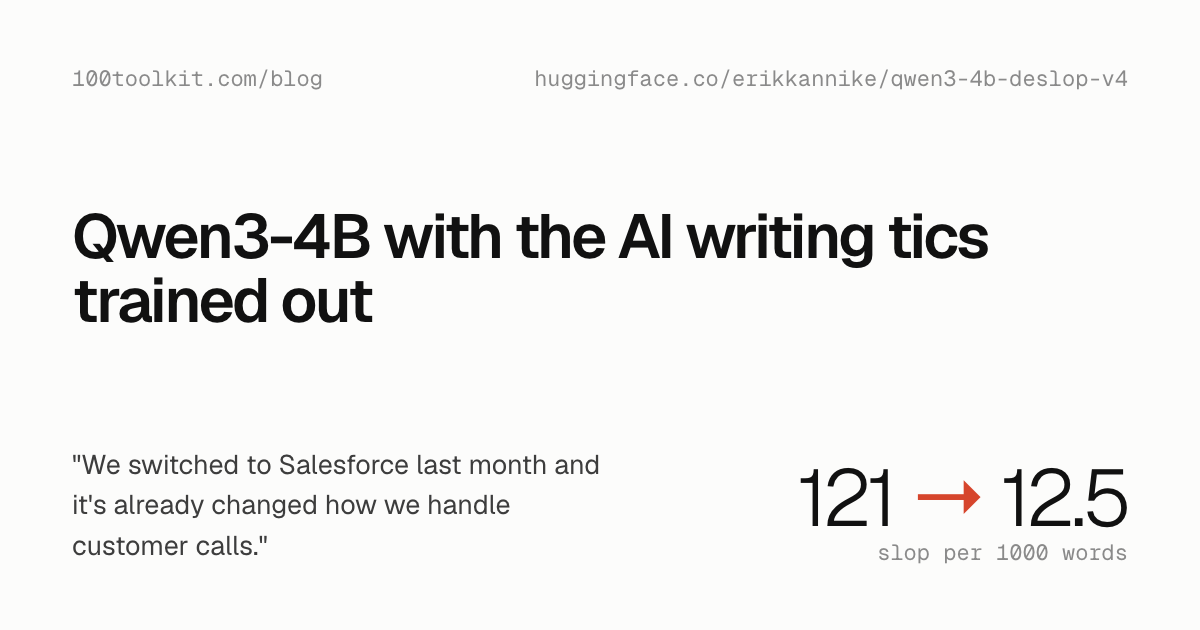
Esta imagen representa el objetivo del proyecto de eliminar el 'slop' de la producción del modelo Qwen3-4B-Instruct.
El proceso de entrenamiento involucró múltiples rondas de destilación. El desarrollador primero identificó comportamientos específicos de 'asistente' dentro de los pesos del modelo y utilizó un modelo 'maestro' para generar respuestas de alta calidad que superaron una serie de comprobaciones de estilo y adecuación a la tarea. Un paso técnico notable involucró una 'edición de neuronas', donde el signo de cuatro neuronas MLP (perceptrón multicapa) específicas se invirtió para eliminar hábitos lingüísticos específicos como la construcción 'no X, sino Y'. En la iteración final, el modelo fue entrenado con 161 respuestas de alta calidad que evitaron con éxito el 'slop', una métrica que el desarrollador creó para ponderar y contar estos hábitos estilísticos. El resultado fue una reducción significativa en la 'puntuación de slop' de 121 a 12.5 por cada 1000 palabras, con muchas salidas puntuando dentro del rango de la prosa escrita por humanos.
A pesar de la reducción en los artefactos estilísticos, el modelo enfrenta varias limitaciones. El desarrollador señaló que la prosa resultante puede ser 'plana' o excesivamente declarativa, y el modelo todavía alucina ocasionalmente nombres y lugares para proporcionar detalles concretos. Además, aunque el modelo funciona bien en prosa corta en inglés, su rendimiento en código, conversaciones de larga duración u otros idiomas permanece sin verificar. El desarrollador planea expandir esta metodología a modelos más grandes y, eventualmente, utilizar un modelo base —uno que no haya pasado por un entrenamiento de 'asistente'— para ver si se puede inculcar un 'gusto' más matizado en los pesos sin el tono plano de la iteración actual.
Los detalles técnicos para el modelo 'deslop' incluyen un adaptador LoRA (126 MB) y una lista de 175 bytes de columnas de pesos para la edición de neuronas. El modelo está disponible en formato cuantizado GGUF para su uso con herramientas como Ollama o llama.cpp, así como pesos de precisión completa para su uso con la biblioteca transformers de Hugging Face. El desarrollador enfatiza que los resultados actuales se basan en una guía de estilo de autoría propia y aún no han sido sometidos a una prueba humana ciega para determinar si el texto 'deslopped' es genuinamente preferido sobre el original.