Los filtros de Bloom son estructuras de datos probabilísticas utilizadas para determinar si un elemento existe dentro de un conjunto. Son altamente eficientes para sistemas de alto rendimiento porque utilizan una cantidad mínima de memoria y proporcionan una respuesta de 'definitivamente no' o 'probablemente', lo que permite a los sistemas omitir operaciones costosas como la E/S de disco. Por ejemplo, el backend de Bluesky los utiliza para filtrar millones de consultas por segundo contra su base de datos Scylla, logrando omitir con éxito los accesos a la base de datos en aproximadamente el 99% de las solicitudes.
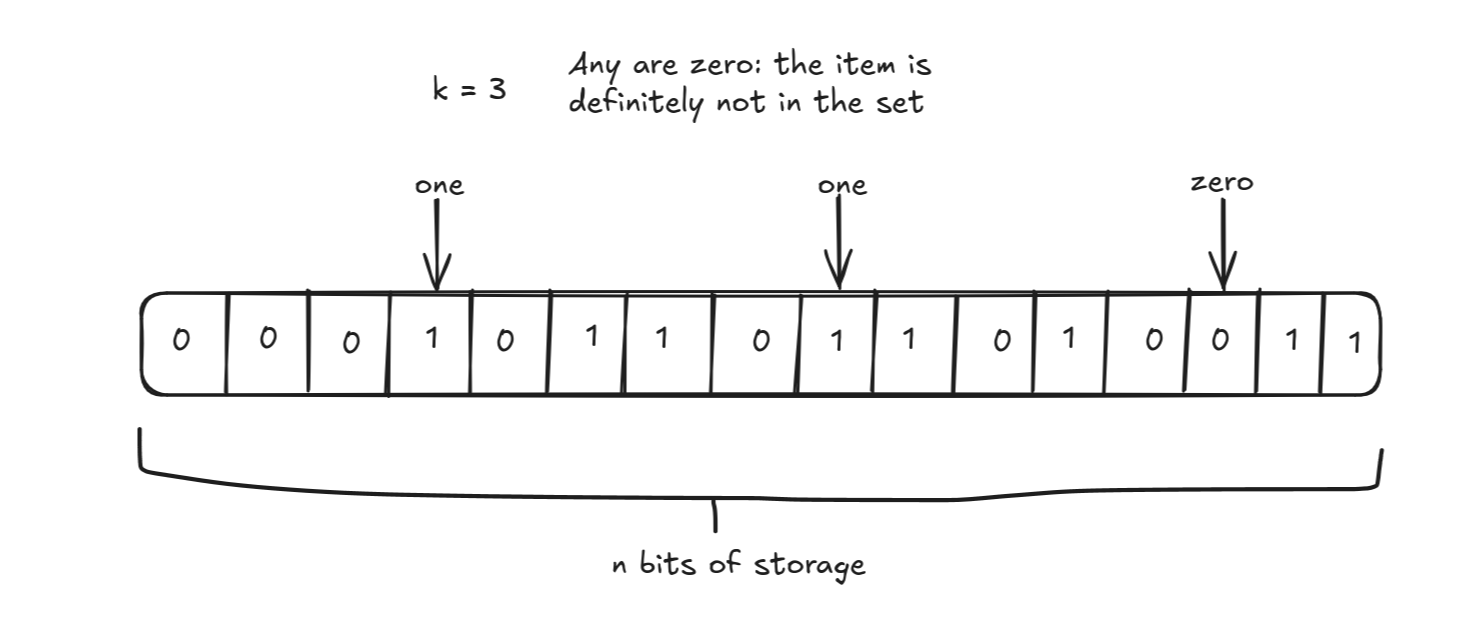
Esta figura ilustra la lógica fundamental de los filtros de Bloom donde un solo bit cero proporciona un resultado definitivo de 'no presente'.
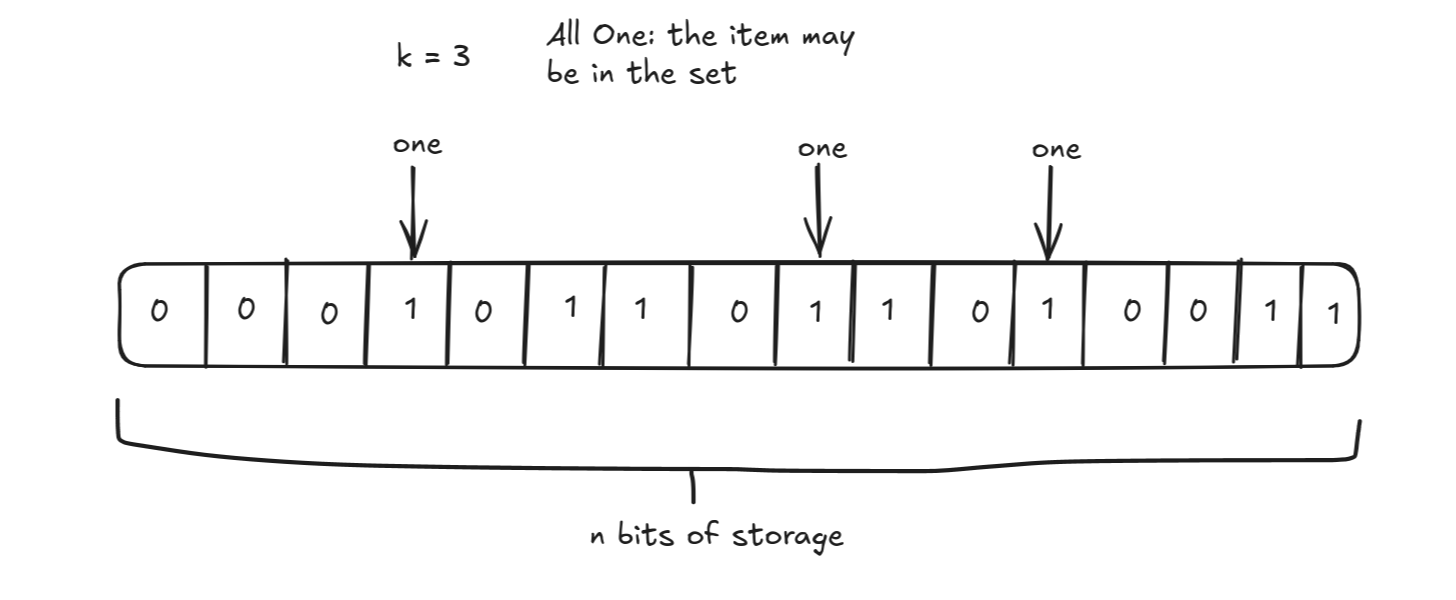
Esta figura demuestra la naturaleza probabilística de los filtros de Bloom, donde un conjunto de bits 'uno' sugiere que un elemento podría estar presente.
Los filtros de Bloom tradicionales dependen de una matriz de bits y $k$ funciones de hash diferentes. Para verificar una clave, el sistema calcula el hash de la clave $k$ veces y comprueba las ubicaciones de bits correspondientes. Aunque es eficaz, calcular múltiples hashes independientes puede ser computacionalmente costoso. Para mitigar esto, los desarrolladores a menudo utilizan el 'doble hashing', donde se usan dos hashes para derivar $k$ ubicaciones. Sin embargo, Calabro señala que incluso esto puede generar cuellos de botella en el rendimiento, como la contención de mutex en entornos multihilo. Bluesky abordó esto pasando a una implementación basada en atómicos, que reemplazó los mutex por instrucciones atómicas de la CPU, reduciendo significativamente los tiempos de despliegue de 90 minutos a 15 minutos.
Para optimizar aún más, Calabro implementó un 'Filtro de Bloom de un solo hash' (OHBF) basado en la investigación de Lu et al. Este método divide una gran matriz de bits en $k$ particiones de tamaños coprimos entre sí. Se utiliza un solo hash de una clave para determinar una posición de bit en cada partición. Este enfoque elimina la necesidad de múltiples cálculos de hash. La implementación también incorpora optimizaciones de bajo nivel, como la alineación de bloques de 64 bytes con las líneas de caché de la CPU para asegurar que las búsquedas resulten en, como máximo, una falla de caché. Si bien este método ofrece aceleraciones significativas, implica un compromiso en la eficiencia del espacio; la partición puede provocar una ocupación desigual en los segmentos, lo que potencialmente requiere un tamaño de filtro general más grande para mantener una baja tasa de falsos positivos.
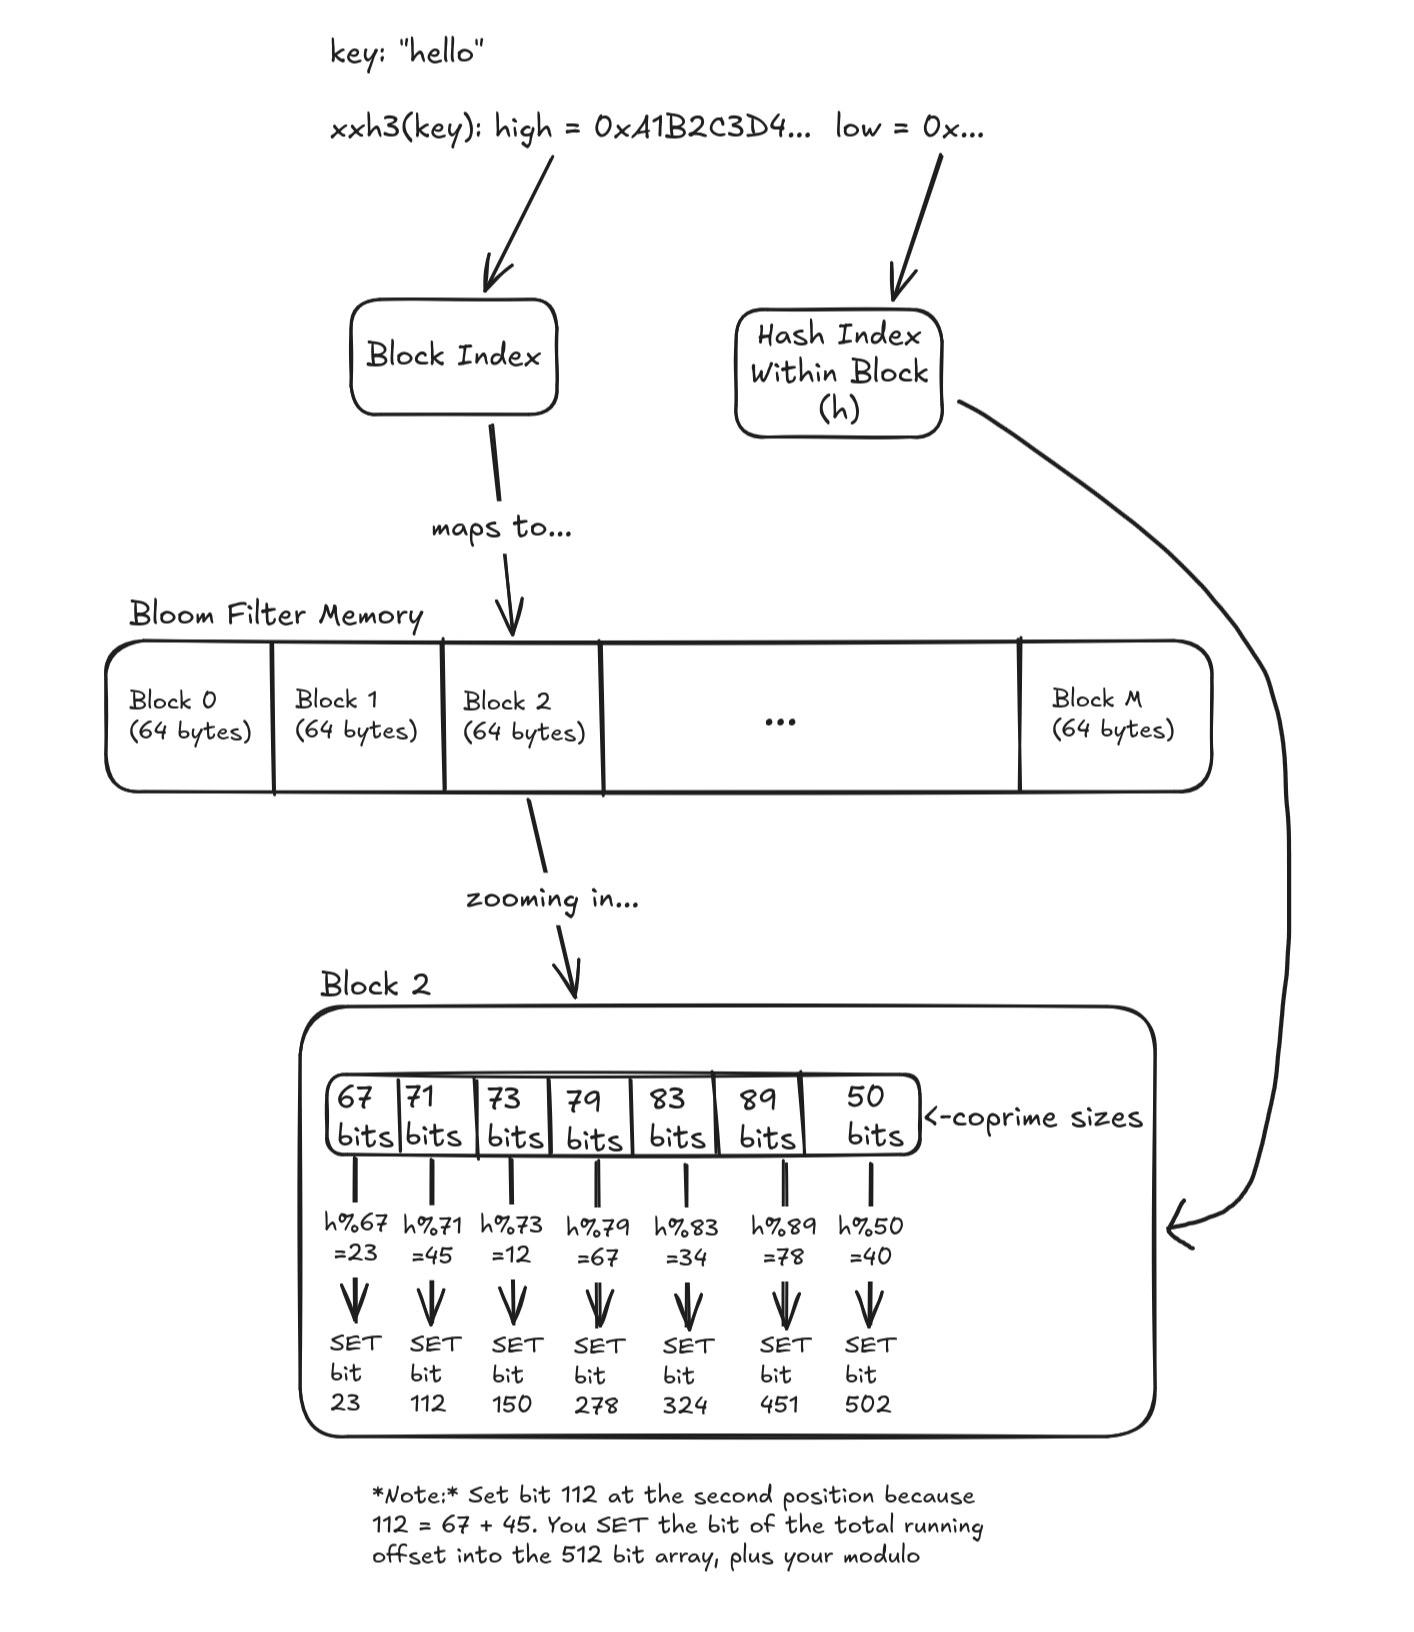
Este diagrama explica el método del Filtro de Bloom de un solo hash (OHBF) de usar un solo hash para determinar las posiciones de los bits en particiones coprimas.
Una optimización final consiste en reemplazar la operación de módulo —que requiere una costosa instrucción de división— con una sola instrucción de multiplicación (MUL) para seleccionar el bloque a verificar. Al combinar estas técnicas —lógica de un solo hash, alineación de caché e indexación basada en multiplicación— el sistema logra búsquedas de alto rendimiento que minimizan tanto los ciclos de la CPU como la latencia de memoria. La implementación de OHBF está actualmente activa en el backend de Bluesky y en su servicio de sincronización de alto rendimiento, Jetstream.