MiniMax ha lanzado oficialmente M3.1 Flash, un nuevo modelo de lenguaje de gran tamaño (LLM) diseñado para optimizar el equilibrio entre la eficiencia computacional y el rendimiento en tareas 'agentes': flujos de trabajo donde un modelo de IA debe planificar, utilizar herramientas y ejecutar acciones de múltiples pasos para lograr un objetivo. El modelo se posiciona como una alternativa de alta velocidad al estándar MiniMax M3, con el objetivo de proporcionar un salto generacional en capacidades para el desarrollo de software, el uso de computadoras y la ciberseguridad, reduciendo significativamente el costo de la inferencia en línea.
La imagen sirve como recurso visual principal para el anuncio del modelo M3.1 Flash y su propuesta de valor central de equilibrar velocidad y rendimiento.
Para lograr estas mejoras, MiniMax utilizó una dispersión agresiva para optimizar la eficiencia de la inferencia. Según la empresa, el modelo puede alcanzar velocidades de salida de más de 200 tokens por segundo (TPS), con velocidades medianas que alcanzan consistentemente más de 170 TPS. Estas mejoras de rendimiento se combinan con una reducción sustancial en los precios; la empresa afirma que, para tareas de agentes, el costo total de uso es un 70% inferior al de su predecesor. El modelo tiene un precio de $0.15 por millón de tokens de entrada y $0.60 por millón de tokens de salida, con una tarifa de $0.015 para entradas en caché.
Esta imagen ilustra las optimizaciones técnicas y las mejoras de rendimiento discutidas en el segundo párrafo con respecto a las velocidades de tokens y los precios.
MiniMax destaca varios puntos de referencia específicos para demostrar las capacidades del modelo en entornos complejos. Obtuvo una puntuación de 76.2 en BankerToolBench, que evalúa la planificación de múltiples pasos y el cumplimiento financiero, y un 73.7% en DeepSWE v1.1, un punto de referencia para tareas de ingeniería de software que requieren que los modelos comprendan el código de forma independiente y validen las correcciones mediante pruebas. En el ámbito del uso de computadoras, donde los modelos interactúan con sistemas operativos y tareas entre aplicaciones, M3.1 Flash obtuvo 61.7 en OSWorld V2 y 29.6 en Agents’ Last Exam (ALE). Aunque el modelo está disponible actualmente a través de API y el plan MiniMax M, la empresa ha declarado que los pesos del modelo se lanzarán en una fecha posterior.
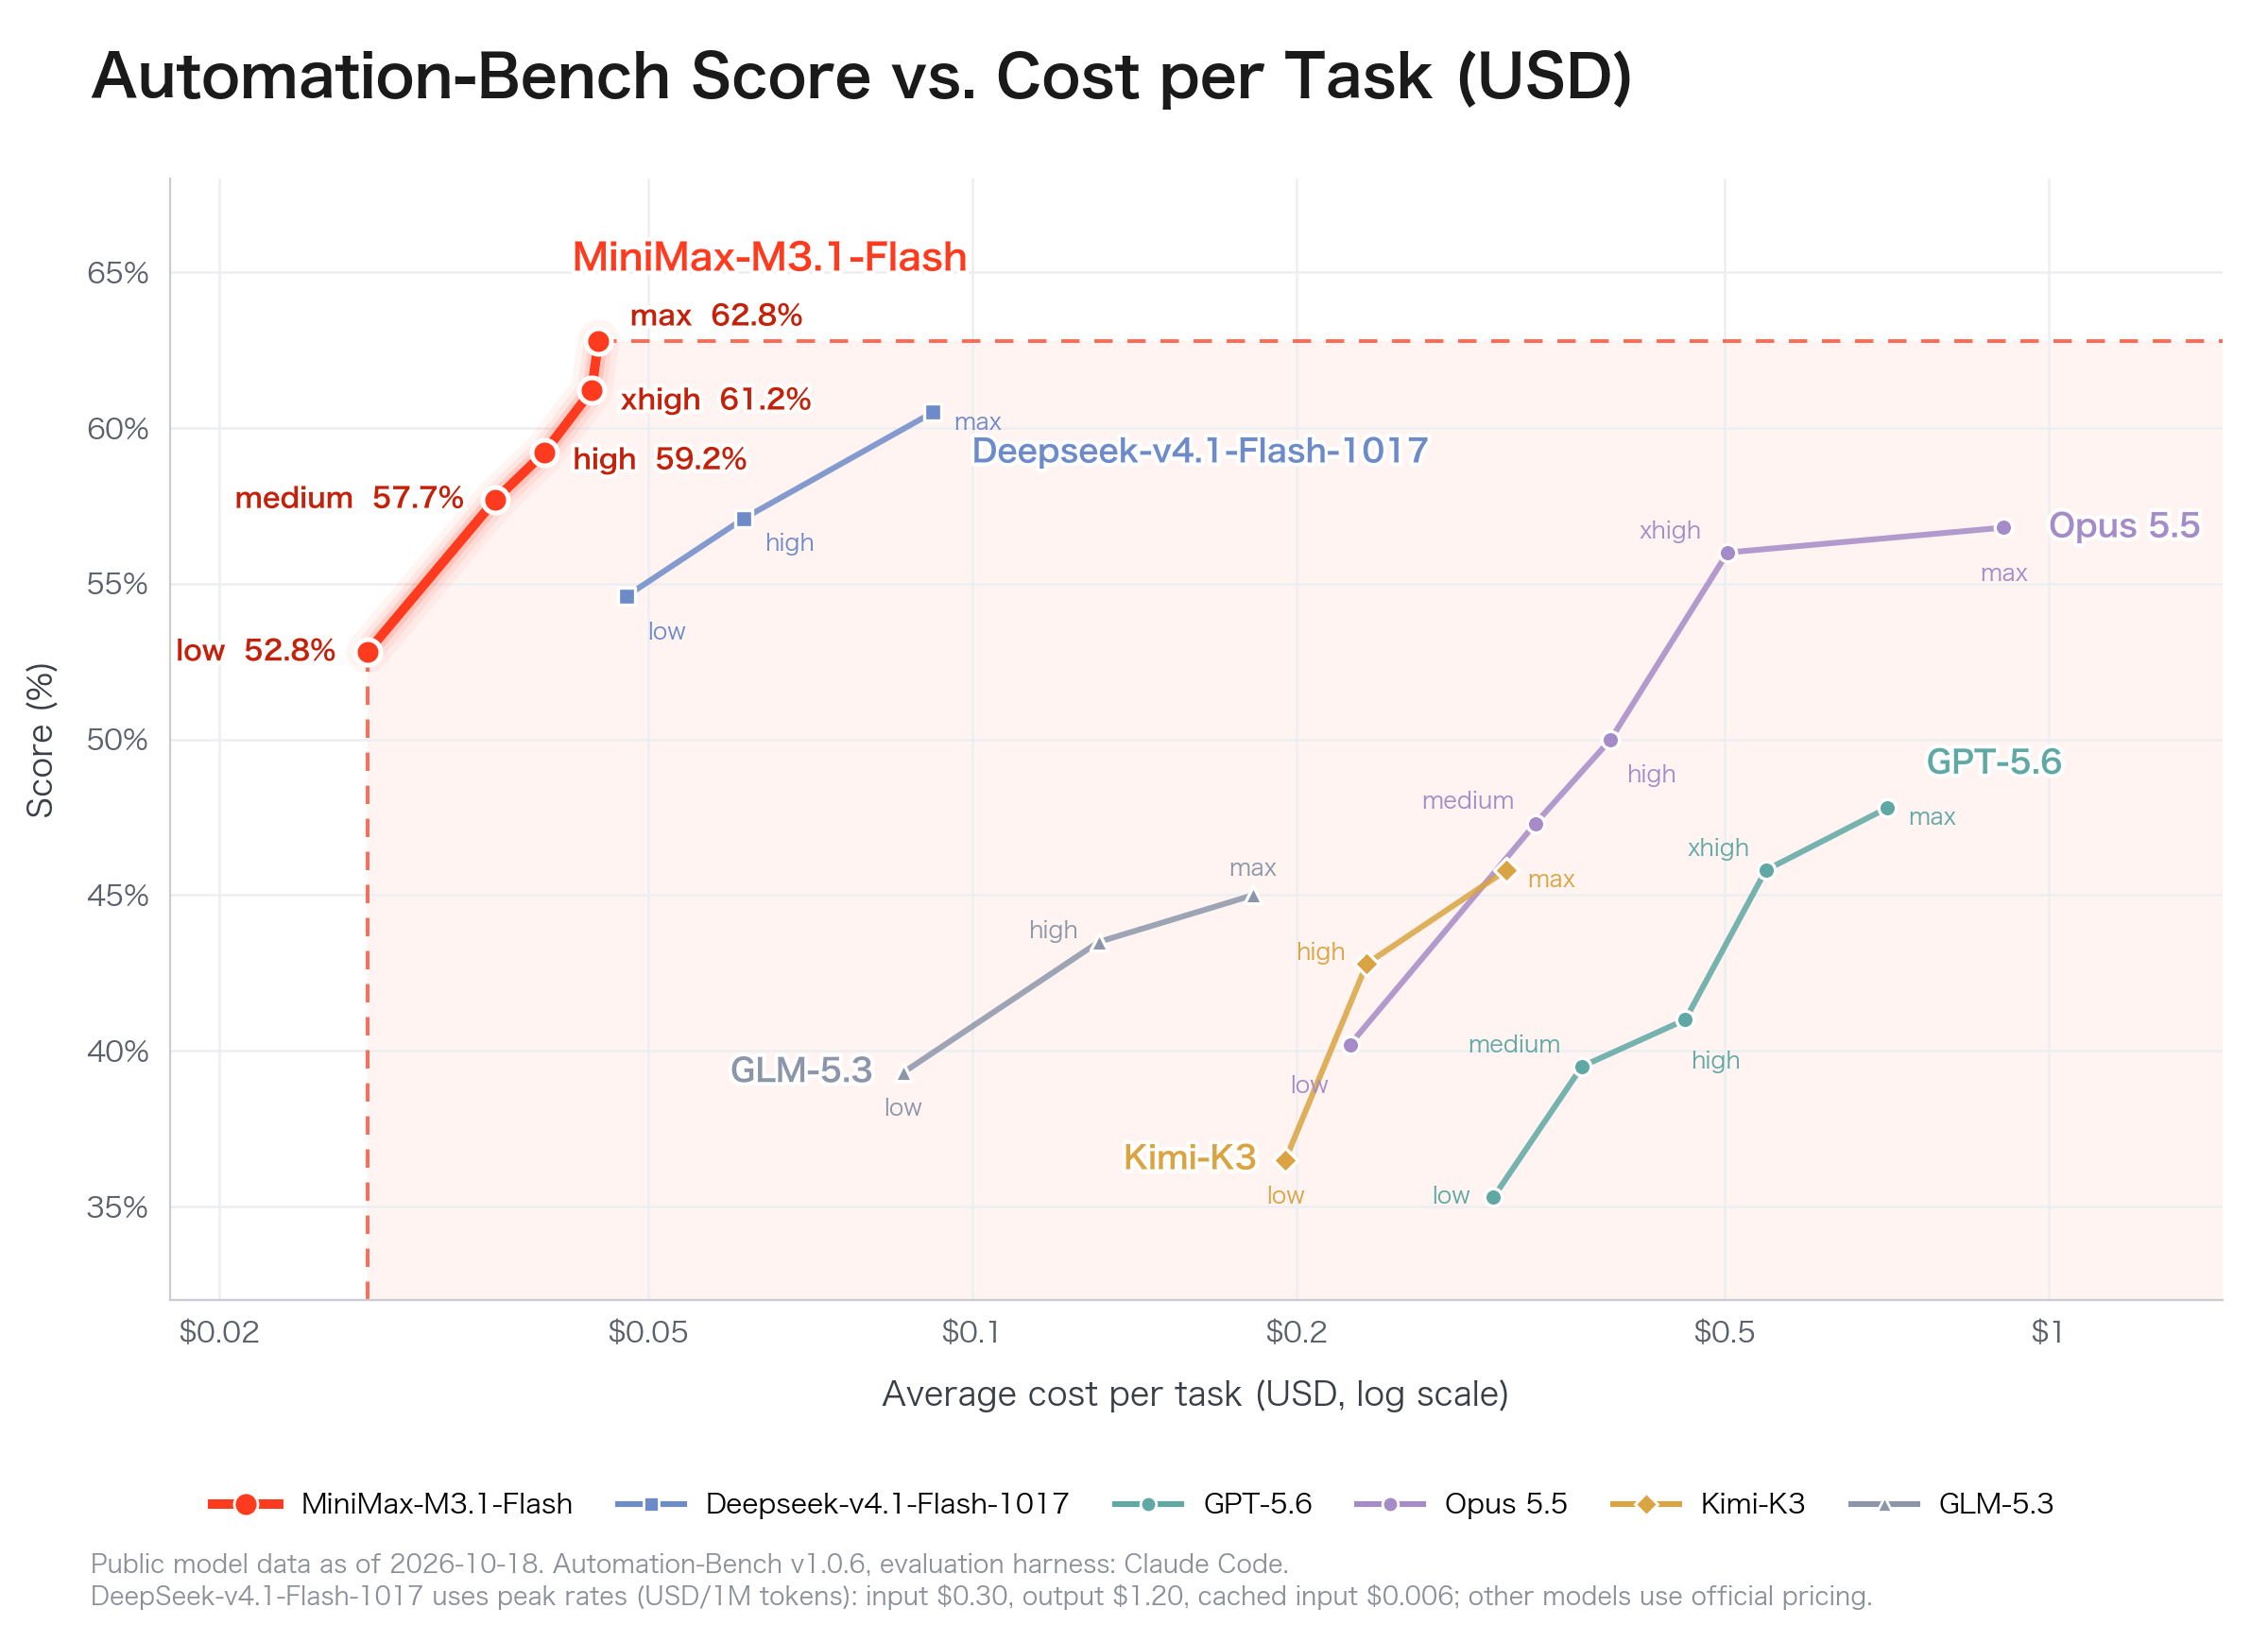
Este recurso visual respalda los datos específicos de los puntos de referencia proporcionados en el último párrafo sobre ingeniería de software y cumplimiento financiero.