En el contexto de la IA, un 'harness' se refiere a la infraestructura que rodea a un modelo de lenguaje grande (LLM) y que le permite actuar como un agente autónomo. Esto incluye componentes como prompts de sistema, protecciones (guardrails), memoria, guía de herramientas, subagentes, habilidades, scripts y complementos. Harness² es un marco desarrollado por Google Research para automatizar la optimización de estos componentes, un proceso que los investigadores denominan 'harnessing'. A diferencia del ajuste fino (fine-tuning) estándar, Harness² mantiene fijos los pesos del modelo subyacente y, en su lugar, se centra en mejorar iterativamente el sistema externo que guía el comportamiento del modelo.
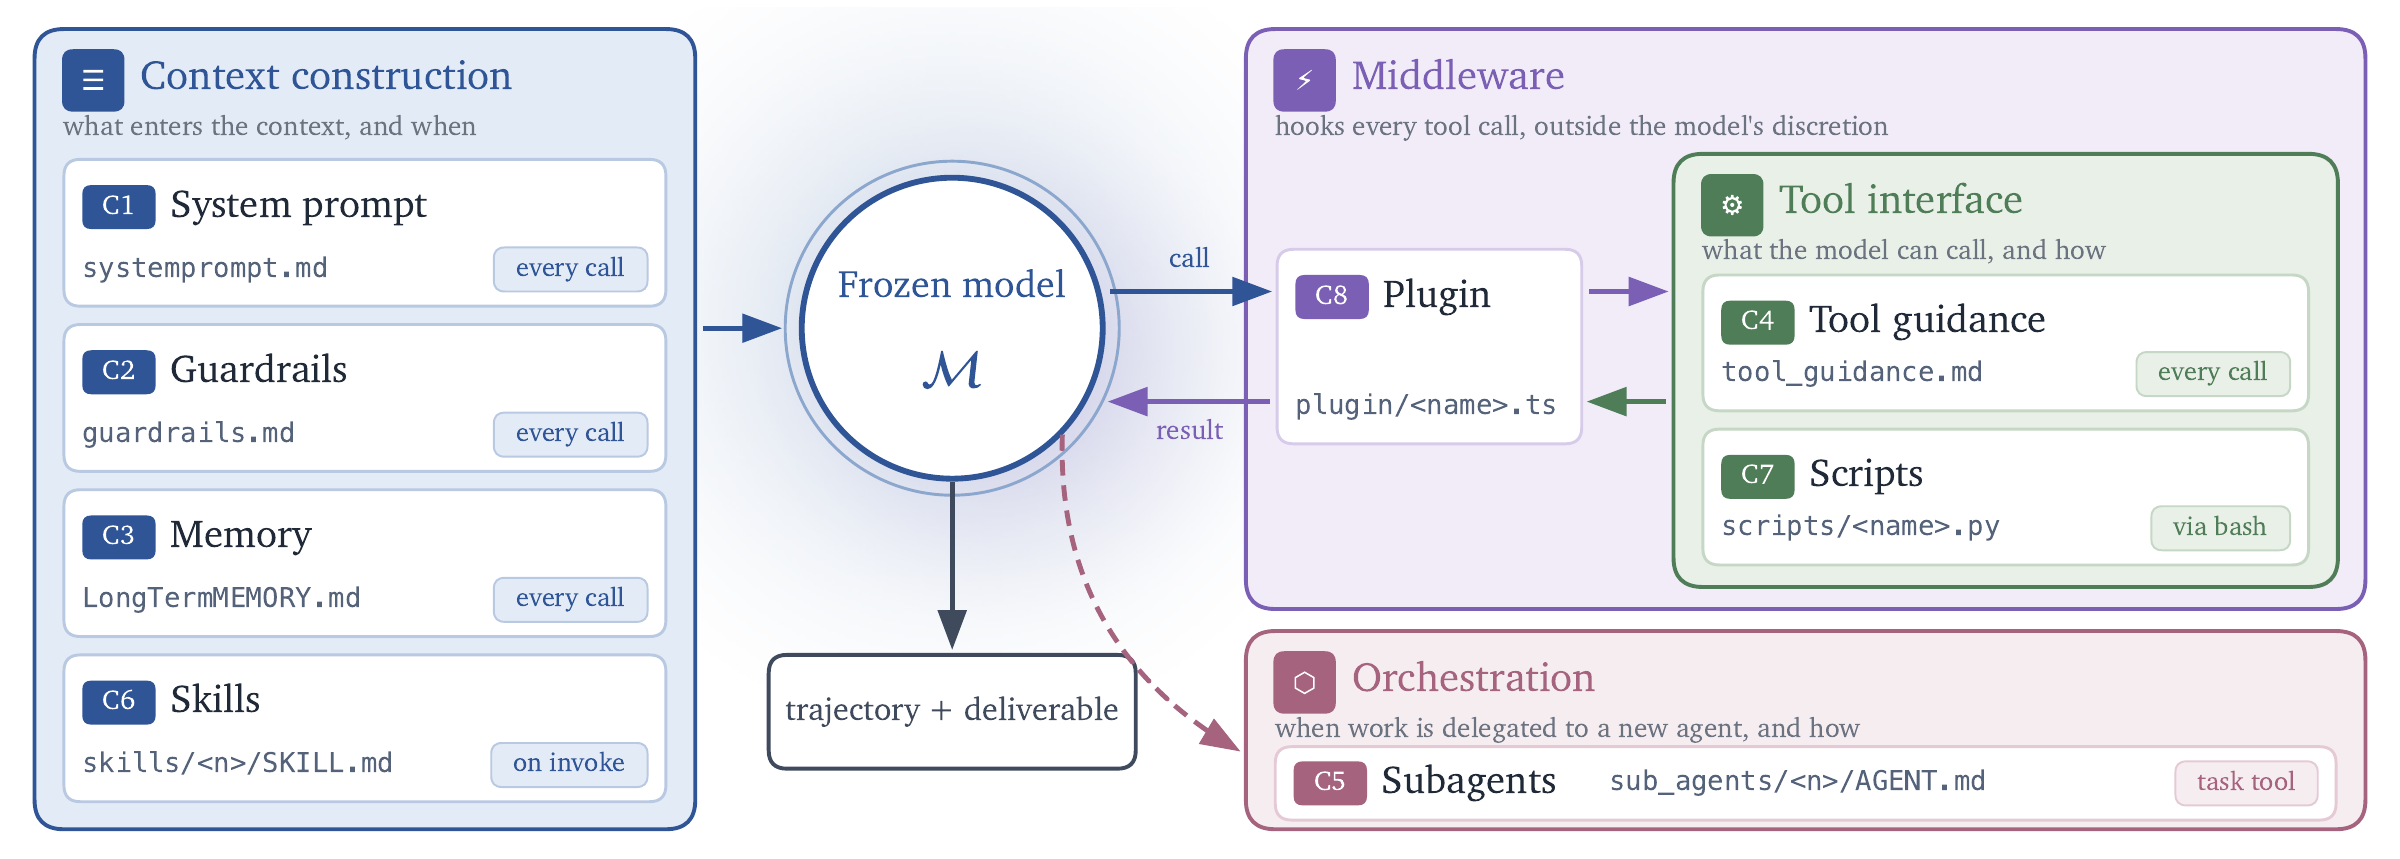
Esta imagen ilustra los componentes específicos de la infraestructura de 'harness' que el marco Harness² está diseñado para optimizar.
El marco opera a través de dos capas distintas de recursión para manejar escenarios de 'mundo abierto', donde los agentes enfrentan tareas que no fueron contempladas explícitamente durante la fase de diseño inicial. La primera capa es la 'recursión a nivel de tarea', que utiliza un ciclo de Propuesta-Sondeo-Composición (Propose–Probe–Compose). Un agente propone ediciones a su propio harness, sondea los efectos de esas ediciones en la tarea actual y compone una versión refinada basada en contrastes de comportamiento. La segunda capa es la 'recursión a nivel de harnessing', que mantiene un 'harness de mejora' persistente. Esta capa captura lecciones y mejoras respaldadas por evidencia de tareas completadas para guiar el refinamiento de tareas futuras, permitiendo que el sistema aprenda de la experiencia a lo largo del tiempo.
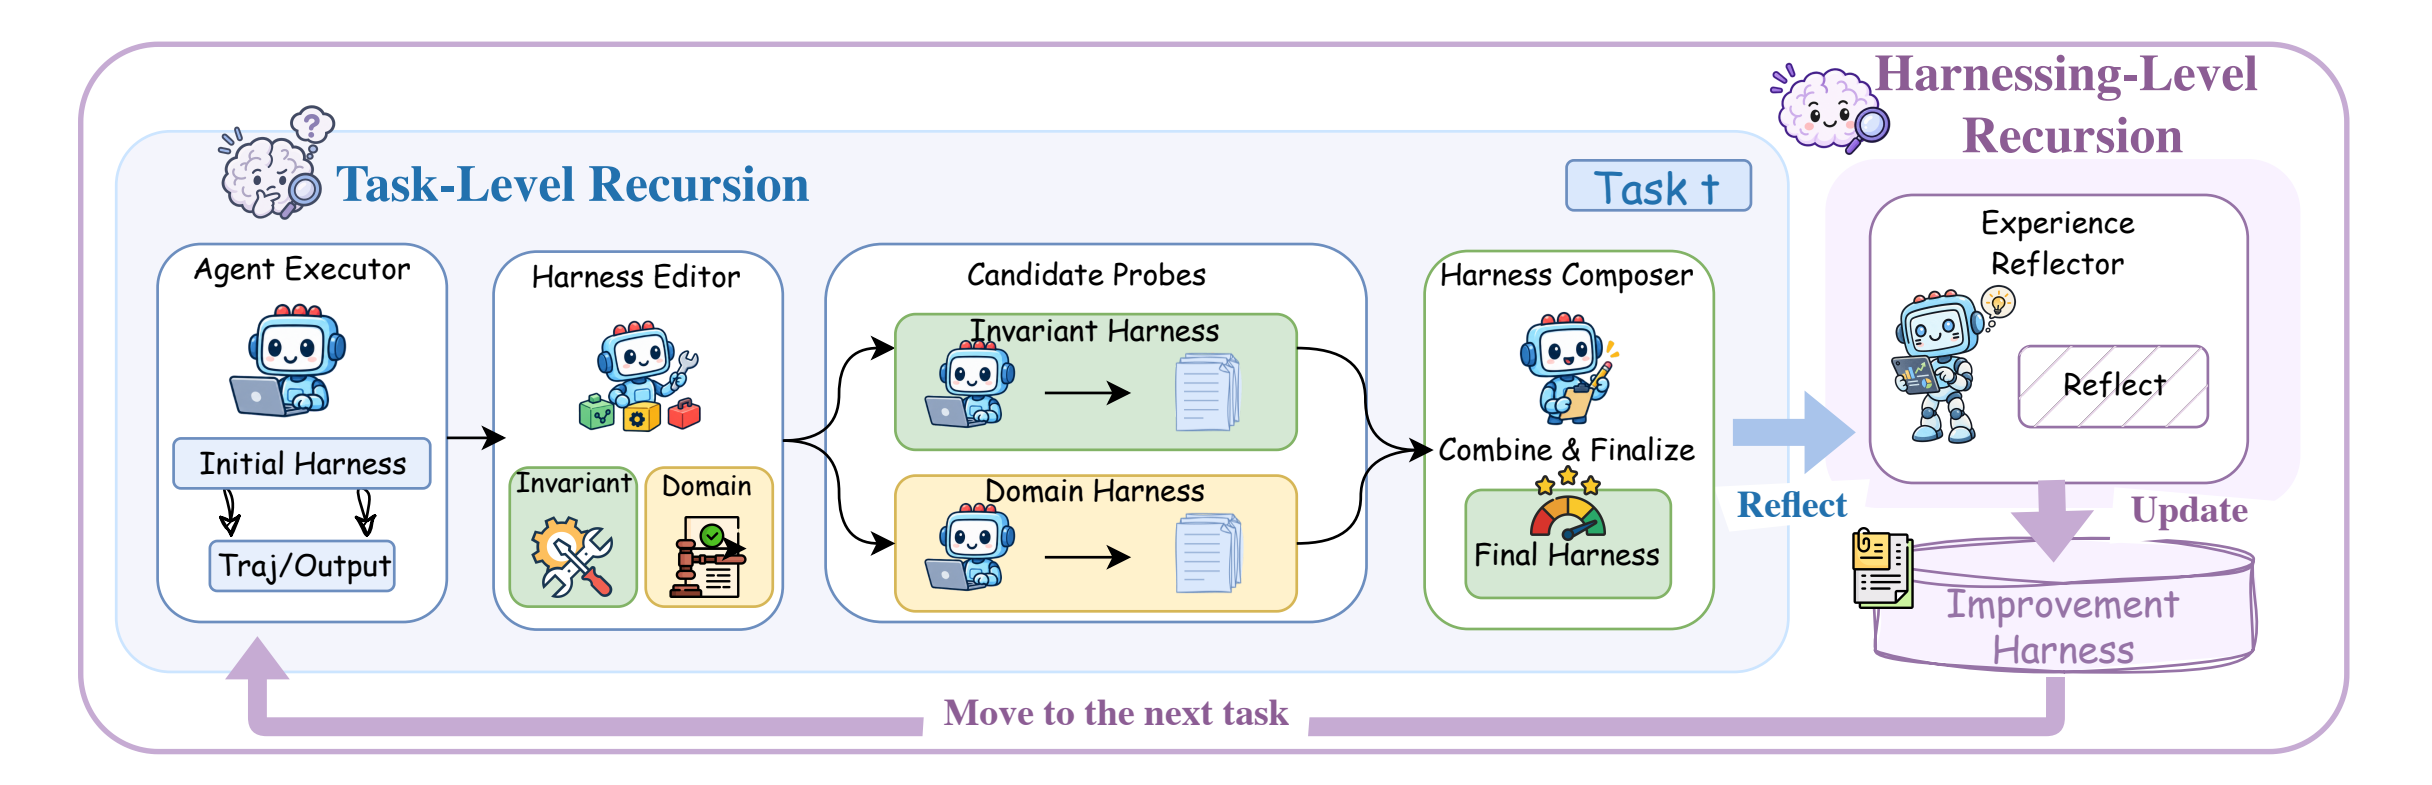
Este diagrama explica el proceso recursivo de doble capa (a nivel de tarea y a nivel de harnessing) descrito en el segundo párrafo.
Los resultados experimentales de los investigadores indican que Harness² puede proporcionar mejoras significativas de rendimiento en diversos puntos de referencia profesionales. Por ejemplo, un solo paso de Harness² mejoró los modelos GLM-5 y Gemini 3.5 Flash, obteniendo ganancias de hasta 11.5 puntos en WorkBuddy-Bench y 11.8 puntos porcentuales en la tasa de aprobación parcial de LAB. El marco admite tanto la recursión paralela, que explora múltiples candidatos de harness simultáneamente para encontrar la mejor composición, como la recursión secuencial, que traslada un harness refinado a través de pasos sucesivos para una optimización más profunda. Si bien el marco proporciona un método estructurado para la evolución de agentes, los investigadores señalan que la eficacia del sistema escala con el 'presupuesto de recursión', es decir, el número de pasos de Propuesta-Sondeo-Composición permitidos por tarea.
Una restricción técnica notable del marco involucra su entorno de ejecución. Aunque el marco admite varios ejecutores como OpenCode y Codex, los investigadores especifican que el ejecutor Codex funciona con su sandbox desactivado y el acceso a la red del ejecutor es sin restricciones. Para mitigar riesgos durante la evaluación, se aconseja a los usuarios configurar restricciones de red antes de ejecutar las pruebas de rendimiento para evitar que el agente acceda a rúbricas públicas o criterios de calificación que podrían comprometer la integridad de los resultados. El proyecto se publica bajo la licencia Apache 2.0 y está destinado como una herramienta plug-and-play para desarrolladores que buscan construir agentes autónomos más adaptables.
El logotipo del proyecto identifica el marco discutido a lo largo del artículo.
Una limitación de la implementación actual es la dependencia de la propia evidencia de ejecución del agente para juzgar el éxito de una edición del harness. Debido a que el sistema no depende de retroalimentación de verdad fundamental (etiquetas externas de 'correcto' o 'incorrecto'), debe basarse en los contrastes de comportamiento entre diferentes configuraciones de harness. Esto significa que la calidad de la optimización está intrínsecamente ligada a la capacidad del agente para sondear e interpretar con precisión las consecuencias de sus propios cambios propuestos. Además, aunque el marco está diseñado para tareas de 'mundo abierto', su rendimiento sigue dependiendo de la calidad de los componentes iniciales y de la profundidad del presupuesto de recursión proporcionado por el usuario.
Los usuarios pueden interactuar con el marco a través de una demostración local que ejecuta ambos modos de recursión con editores deterministas y ejecuciones reales de Python. Para las pruebas de rendimiento respaldadas por modelos, el marco se integra con Vertex AI y requiere dependencias específicas como Docker para WorkBuddy-Bench o Pandoc y Poppler para la prueba de referencia LAB. Los resultados de estas ejecuciones se guardan automáticamente en un directorio estructurado, proporcionando resúmenes de tareas, entregables y notas de reflexión que documentan la evolución de los componentes del harness a lo largo del tiempo.