DeepSeek ha lanzado en código abierto DeepInfer, un framework de inferencia de alto rendimiento diseñado específicamente para soportar servicios de producción a gran escala para los modelos de DeepSeek. Aunque el lanzamiento actual se centra en la inferencia fuera de línea (offline), incluye las características principales necesarias para el escalado. El framework está diseñado para funcionar con hardware específico, incluyendo las GPUs NVIDIA SM100 y las NPUs Huawei Ascend 950. Fue desarrollado inspirándose en frameworks existentes como vLLM, SGLang y TensorRT-LLM.
Esta imagen representa el repositorio oficial de DeepInfer donde se aloja el framework.
El framework introduce varias optimizaciones especializadas para mejorar el rendimiento (throughput) y la latencia. Estas incluyen kernels optimizados como FlashMLA, DeepGEMM y DeepEP, junto con técnicas avanzadas de paralelismo como Attention DP (Data Parallelism), balanced CP (Context Parallelism) y MoE (Mixture of Experts) EP (Expert Parallelism) con EPLB. También cuenta con DSpark y verificación con programación de confianza (confidence-scheduled verification), que utilizan tokens de borrador para acelerar la decodificación. Otras características técnicas incluyen la programación asíncrona para solapar el loteado de CPU con la ejecución en el dispositivo, la inferencia invariante al lote (para hardware NVIDIA) y el muestreo determinista para garantizar resultados consistentes para parámetros de entrada idénticos.
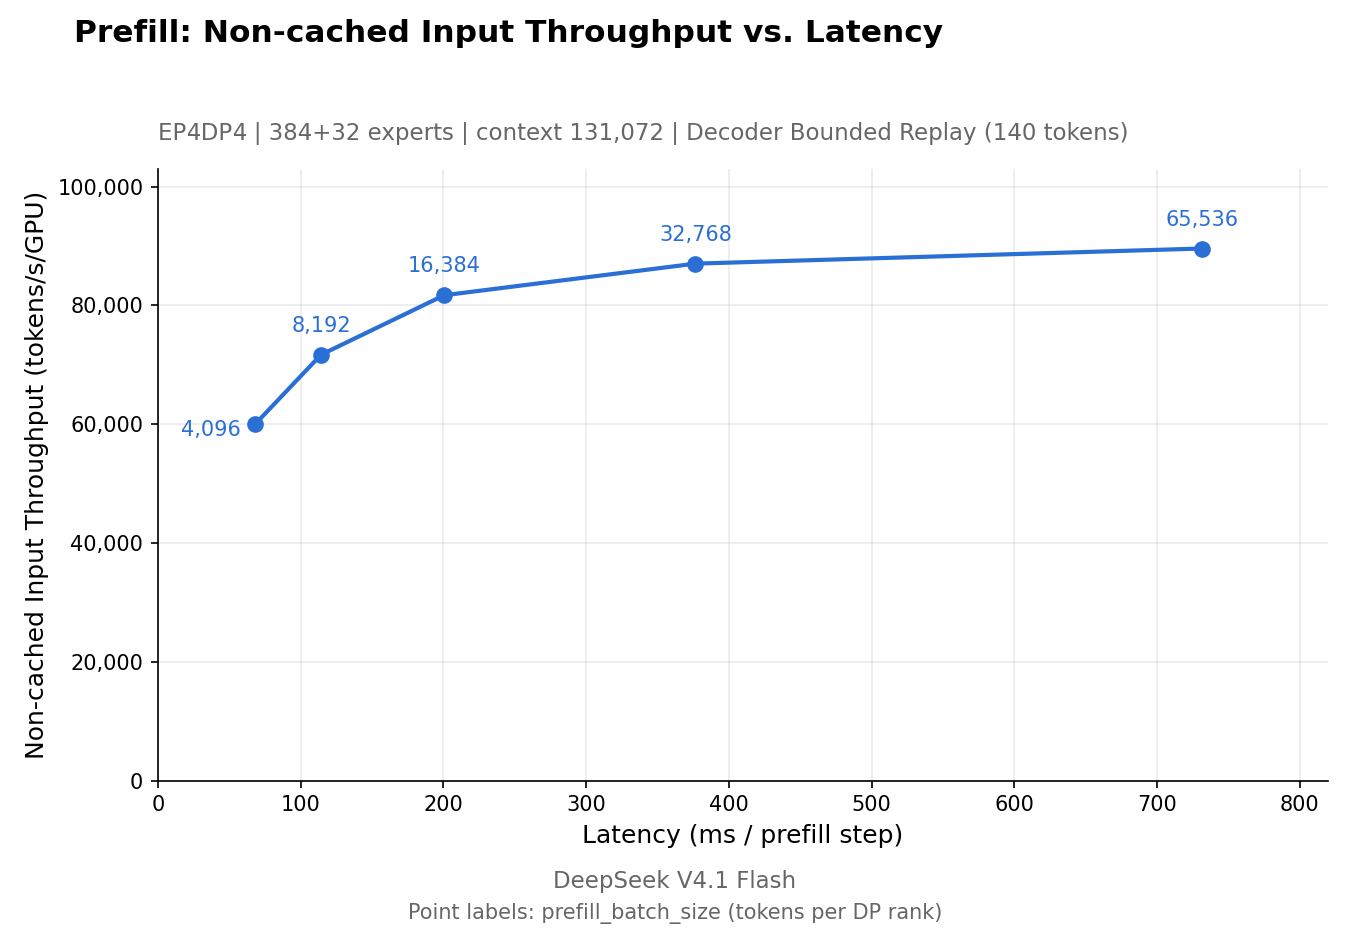
Esta figura visualiza las características de rendimiento del proceso de prefill mencionado en las optimizaciones técnicas.
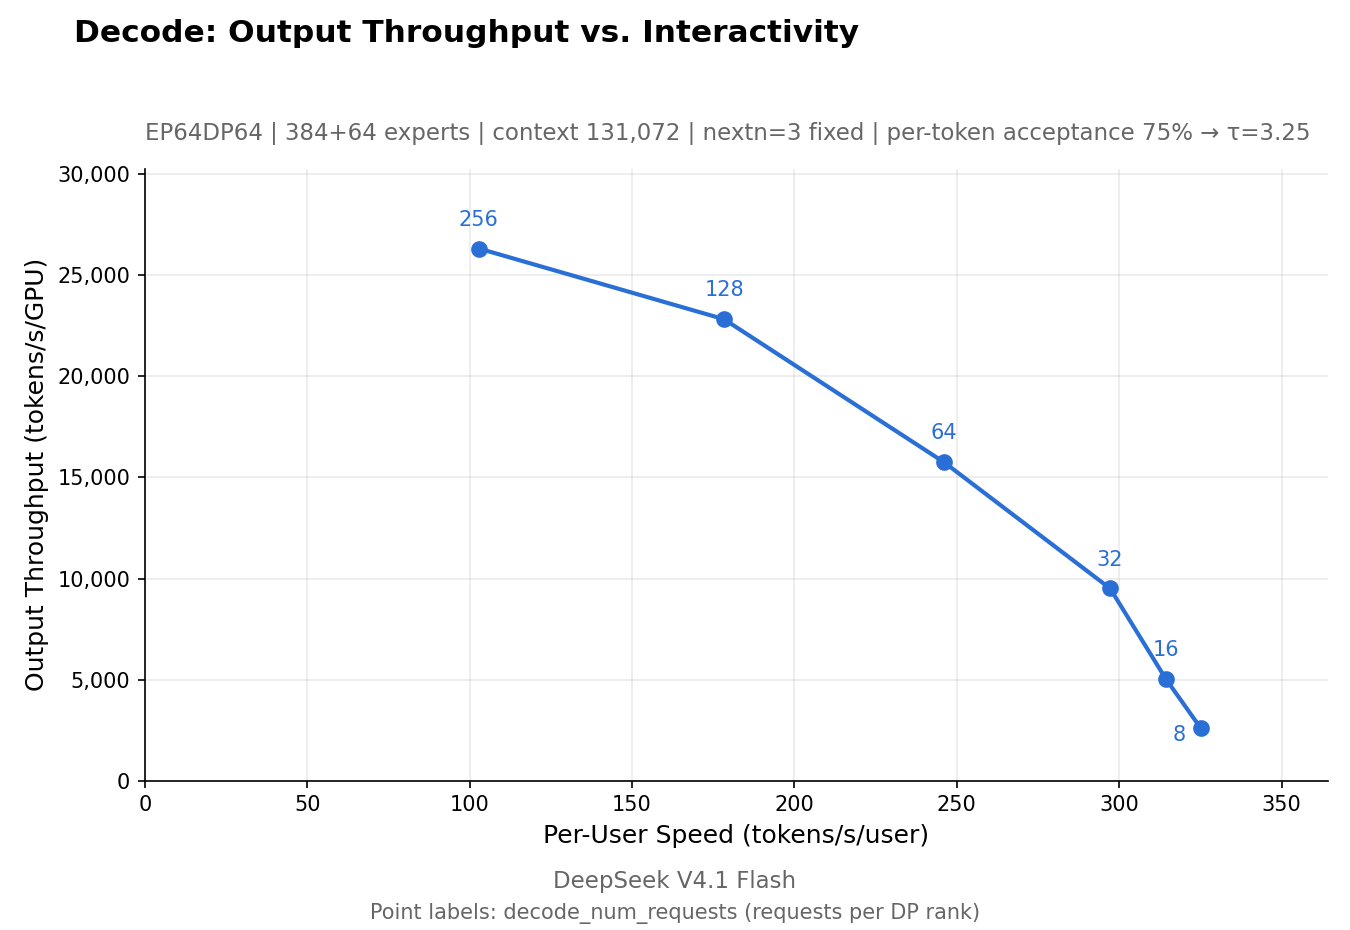
Este gráfico demuestra las métricas de rendimiento de decodificación soportadas por las optimizaciones del framework.
A pesar de sus capacidades de alto rendimiento, el lanzamiento actual en código abierto tiene algunas limitaciones con respecto a un servicio de inferencia de producción completo. Aún no incluye un sistema de caché KV (Key-Value) ni la desagregación VE/Prefill/Decode. Además, aunque proporciona la funcionalidad del motor principal, carece de equilibrado de carga integrado entre réplicas de paralelismo de datos para las etapas de prefill y decode. Los usuarios que busquen desplegar el framework deben tener en cuenta estos componentes faltantes al construir un servicio a gran escala.