PS5LM es un proyecto de código abierto diseñado para aprovechar el hardware de PlayStation 5 para la inferencia local de IA. Al utilizar la GPU RDNA 2 de la consola a través del backend Vulkan de llama.cpp, el software permite a los usuarios cargar y ejecutar modelos GGUF (GPT-Generated Unified Format) —un formato común para modelos de lenguaje de gran tamaño cuantizados— directamente en el dispositivo. El sistema utiliza aproximadamente 11.4 GB de la memoria compartida de la consola para el modelo y su contexto, admitiendo diversas arquitecturas y métodos de cuantización compatibles con el marco de trabajo de llama.cpp.
El proyecto funciona como un servidor de modelos privado que atiende solicitudes a otros dispositivos en una red local, como portátiles, teléfonos o herramientas de programación. Proporciona compatibilidad con APIs estándar, incluyendo /v1/chat/completions de OpenAI y /v1/messages de Anthropic, lo que le permite interactuar con software existente como Claude Code. Más allá del chat estándar, PS5LM admite 'modelos de decisión', que son modelos diseñados para producir decisiones tipográficas, puntuaciones y respuestas de sí o no en un único paso hacia adelante, en lugar de generar largas cadenas de texto. La interfaz de la consola muestra telemetría en tiempo real, incluyendo temperatura, consumo de energía y carga de GPU/CPU, mientras transmite las solicitudes y respuestas a través de la pantalla del televisor.
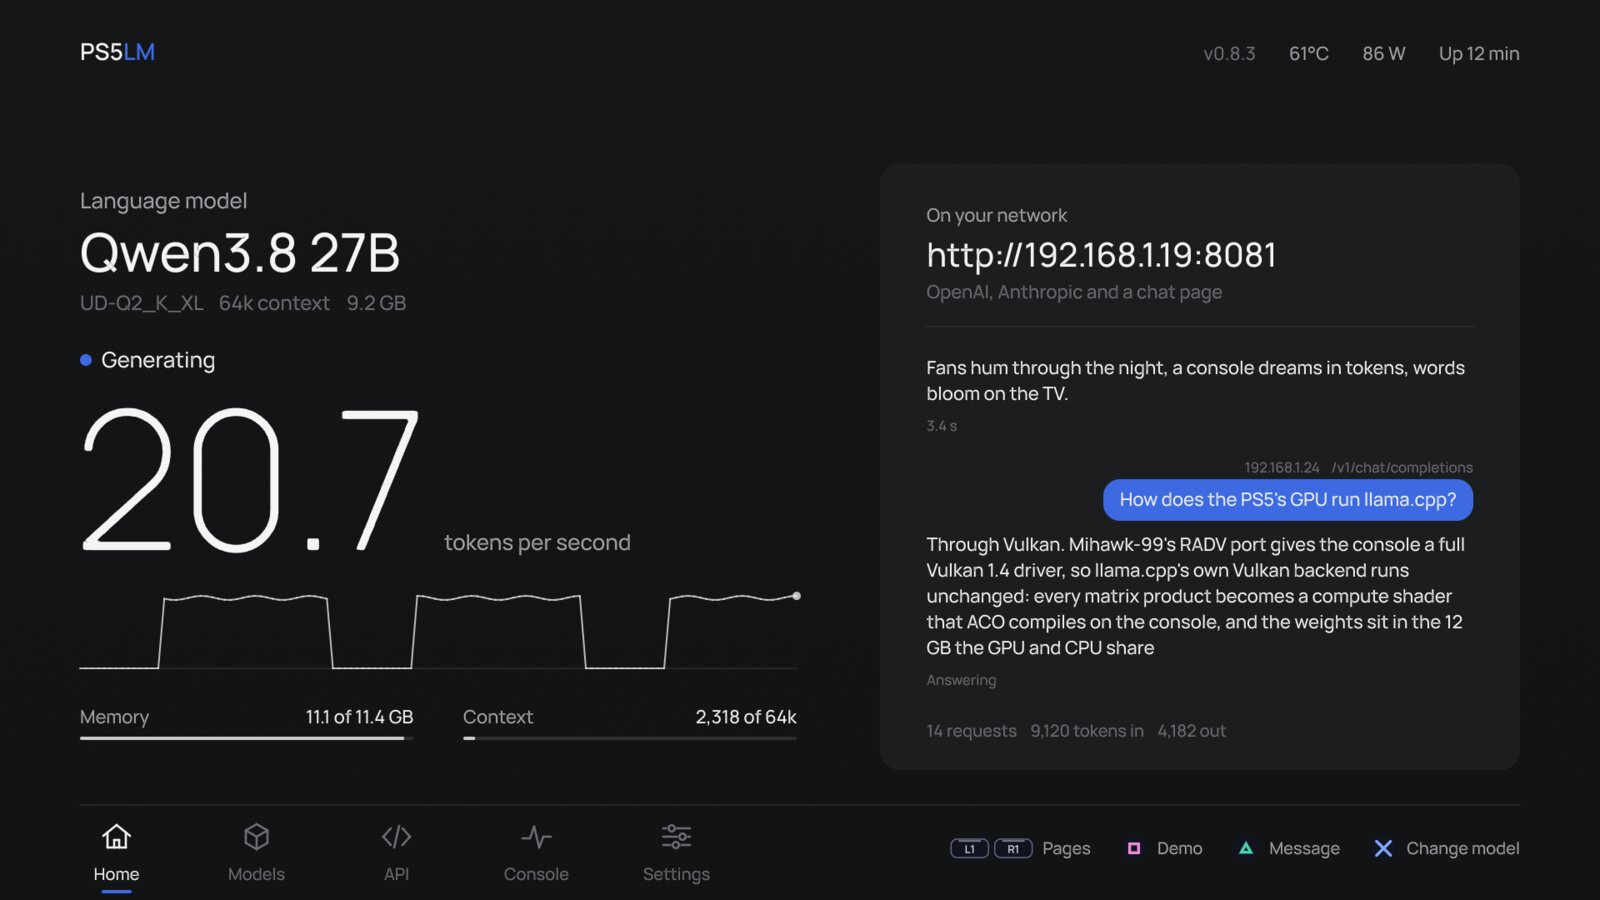
El proyecto proporciona una interfaz de usuario que muestra telemetría en tiempo real y solicitudes en streaming a través de la pantalla del televisor.
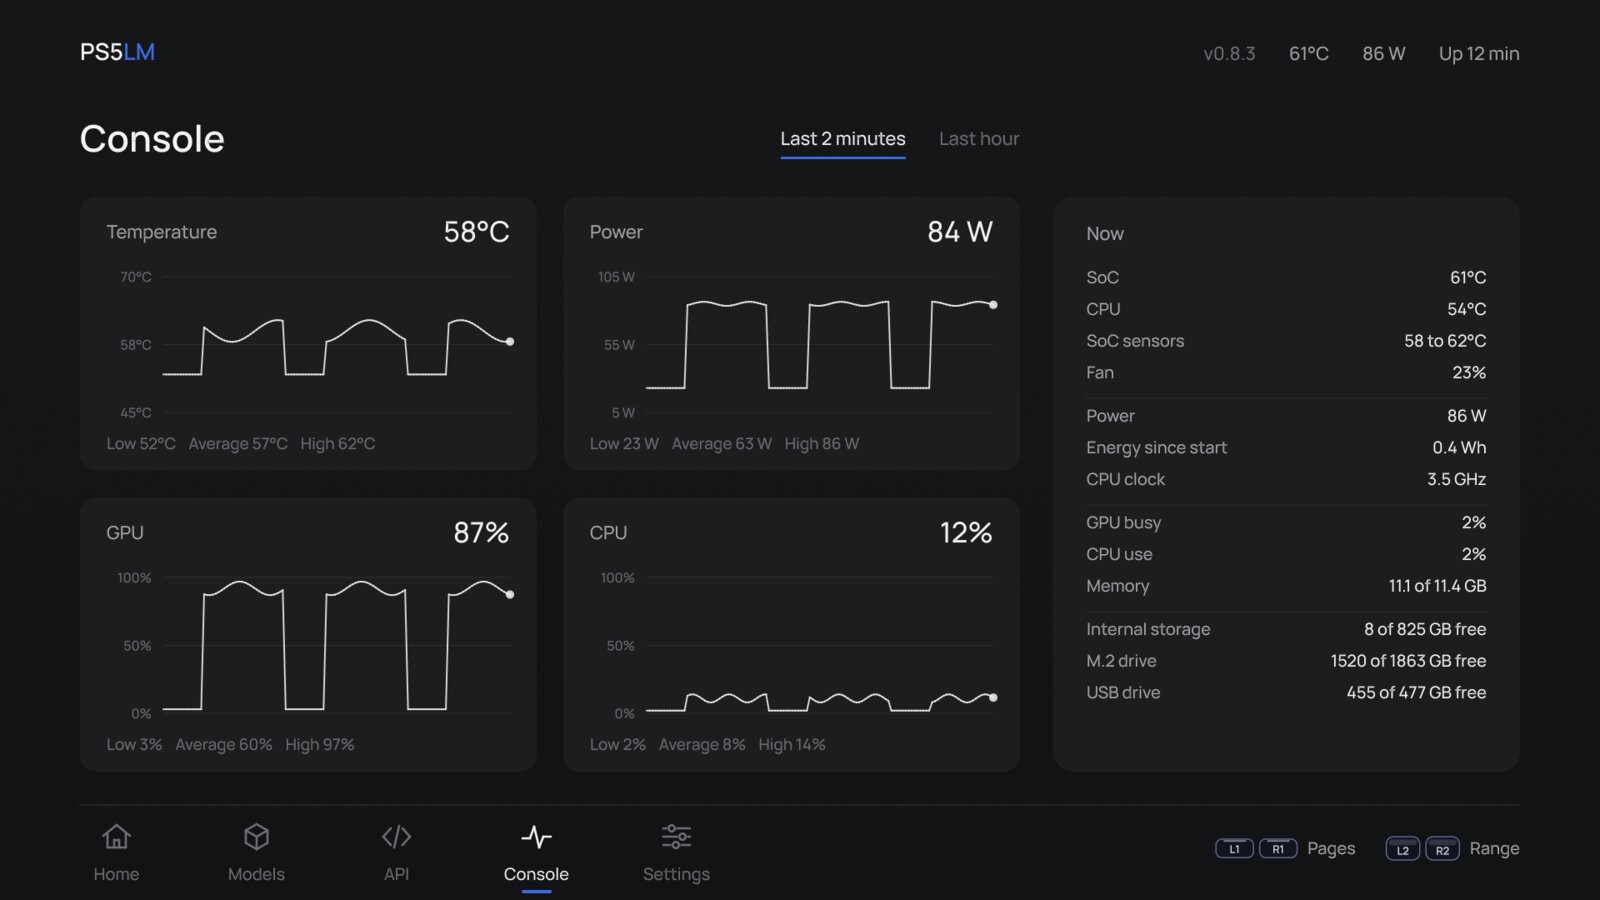
La interfaz de la consola muestra telemetría en tiempo real, incluyendo temperatura, consumo de energía y carga de GPU/CPU, mientras transmite las solicitudes y respuestas a través de la pantalla del televisor.
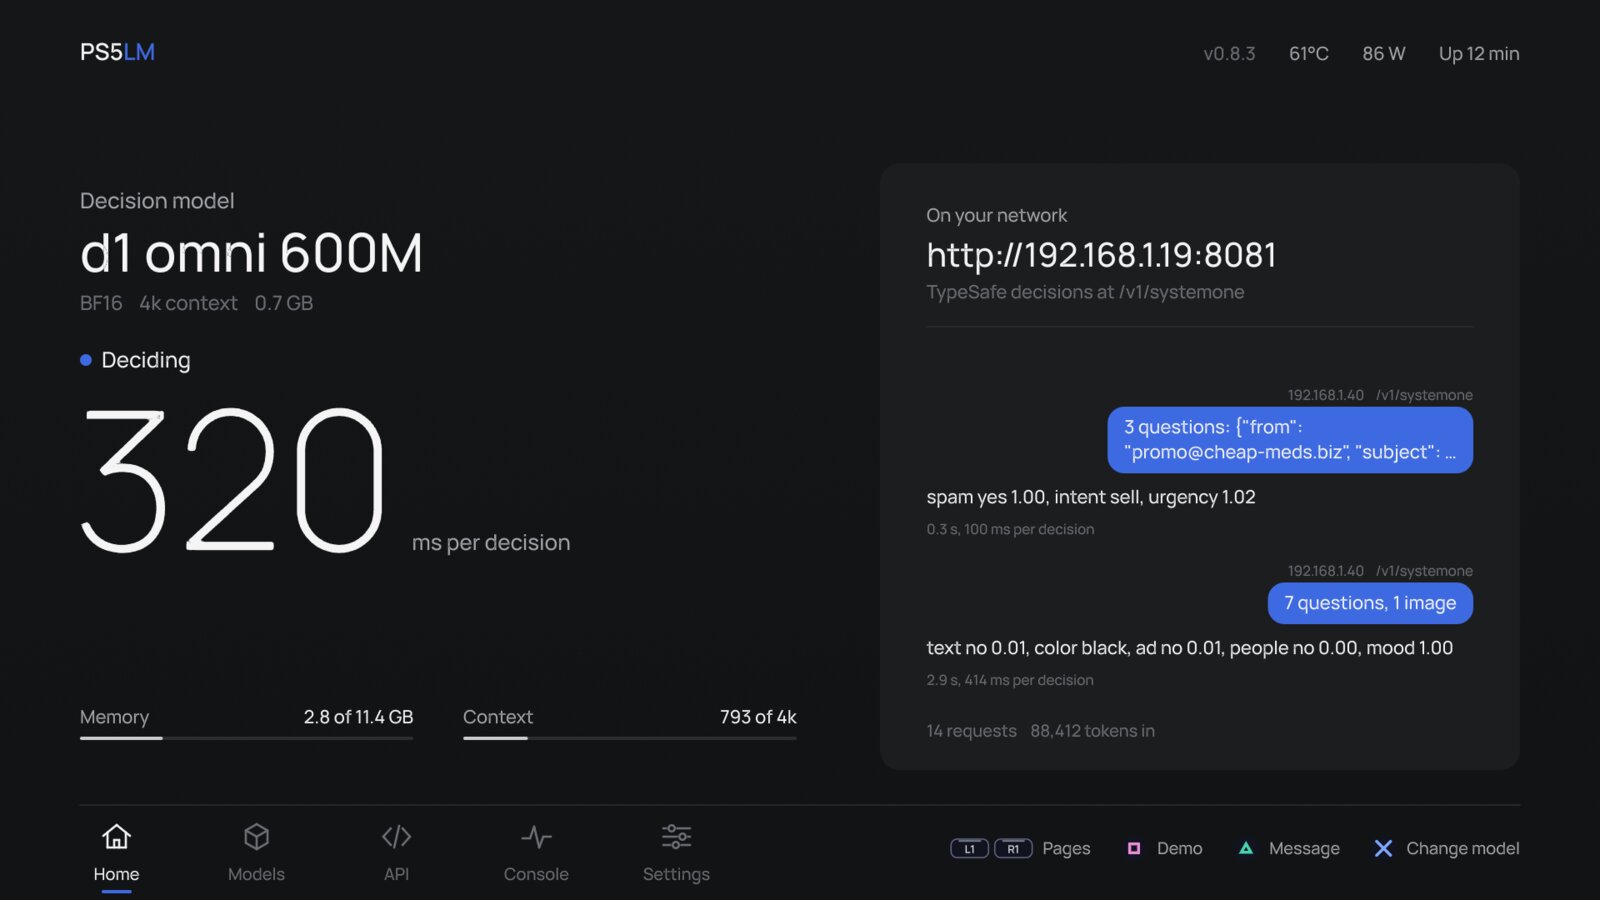
Más allá del chat estándar, PS5LM admite 'modelos de decisión', que son modelos diseñados para producir decisiones tipográficas, puntuaciones y respuestas de sí o no en un único paso hacia adelante, en lugar de generar largas cadenas de texto.
Aunque el proyecto ofrece una forma de ejecutar modelos como Qwen 3.5 y Qwen 3.8 de forma nativa, conlleva requisitos específicos de hardware y software. Los usuarios deben tener una PS5 con jailbreak ejecutando firmware entre las versiones 7.00 y 13.60, junto con varios payloads específicos (como etaHEN, ShadowMountPlus y elfldr) para habilitar el soporte de homebrew y el acceso al sistema de archivos. El rendimiento varía significativamente según el tamaño del modelo; por ejemplo, un modelo Qwen 3.5 9B puede alcanzar aproximadamente 55 tokens por segundo en una PS5 Slim, mientras que un modelo Qwen 3.8 27B más grande (con una cuantización de 2 bits) puede alcanzar unos 20 tokens por segundo con una ventana de contexto de 64k. Debido a que se ejecuta localmente, el sistema no requiere conexión a la nube ni cuentas externas, proporcionando una alternativa privada para el alojamiento de IA en el hogar.