Los agentes modernos de Modelos de Lenguaje de Gran Escala (LLM) suelen razonar e interactuar con el mundo a través de texto. Si bien esto permite la transparencia y una fácil integración con herramientas externas, puede resultar computacionalmente costoso y menos eficiente que el 'razonamiento latente', donde un modelo procesa la información en sus estados ocultos internos en lugar de generar cada palabra de un proceso de pensamiento. Los investigadores han introducido los Agentes de Razonamiento Híbrido (HybridAgents) para cerrar la brecha entre estos dos enfoques, permitiendo que un agente navegue entre los modos latente y de texto dentro de un único proceso de generación.
La arquitectura se basa en un componente llamado HybridLink, que mapea los estados ocultos de la última capa del modelo de vuelta al espacio de incrustación de entrada (input-embedding). Esto permite que el agente entre en un 'modo latente' para un pensamiento interno rápido que aún puede ser inspeccionado por humanos como pseudo-texto legible. Cuando el agente necesita realizar una llamada a una herramienta, proporcionar una respuesta final o interactuar con un entorno externo, vuelve al 'modo de texto'. Para asegurar que el agente mantenga el contexto a través de estos cambios, una memoria de trabajo continua preserva el historial tanto de las interacciones de texto como de los pensamientos latentes, garantizando que el razonamiento interno siga siendo relevante para las acciones externas.
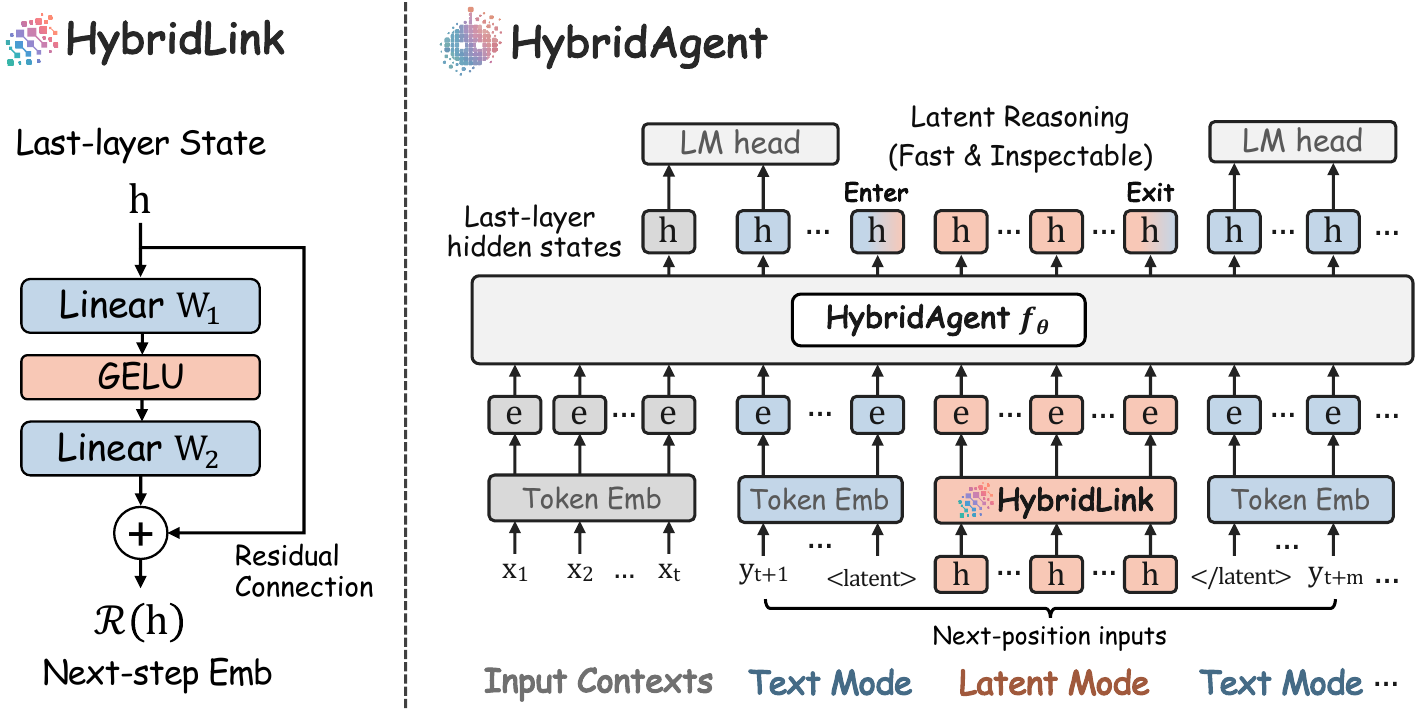
Este diagrama explica la arquitectura central de los HybridAgents, específicamente cómo transicionan entre los modos latente y de texto.
Para entrenar estos modelos, los investigadores desarrollaron dos algoritmos de post-entrenamiento: HybridSFT y HybridRL. HybridSFT estabiliza la capacidad del modelo para coordinarse con el HybridLink, mientras que HybridRL enseña al agente a decidir cuándo es más eficiente pensar en el espacio latente frente a cuándo debe actuar a través del texto. En evaluaciones realizadas en 11 bancos de pruebas, incluyendo matemáticas, ciencias y medicina, HybridAgent superó a los agentes de LLM de vanguardia en un promedio del 10.4%. Los investigadores también informaron ganancias significativas en eficiencia, incluyendo una reducción del 35.5% al 54.7% en el uso de tokens, velocidades de inferencia hasta 2.6 veces más rápidas y ahorros de costos de hasta 3.7 veces en comparación con los marcos de agentes tradicionales basados únicamente en texto.