Josephine Pfeiffer, una mantenedora de paquetes de Arch Linux, logró portar Arch Linux ARM a una laptop ASUS ProArt P16 (H7607BA-SE033W). El proyecto fue motivado por las especificaciones de gama alta de la laptop, que incluyen 128 GB de RAM y una GPU NVIDIA N1X con 6,144 núcleos CUDA, y el hecho de que el soporte oficial para este hardware está restringido a Windows. Pfeiffer eligió Arch Linux ARM para mantener un entorno de desarrollo local para modelos de pesos abiertos, ajuste fino y cuantización sin las concesiones de privacidad o la publicidad asociadas con el sistema operativo Windows.
La implementación técnica implicó integrar el trabajo de kernel de NVIDIA para Ubuntu como base. Pfeiffer abordó varios obstáculos específicos del hardware, incluyendo la corrección de asignaciones de anulación ACPI y el mapeo de framebuffer para lograr una consola funcional. La configuración requirió un controlador `hid-asus` parcheado para el soporte de teclado y un controlador de máquina personalizado para el audio. La configuración final soporta una pantalla de 3840 × 2400 a 120 Hz, utiliza NetworkManager y PipeWire, y ejecuta Podman sin privilegios de root con NVIDIA CDI. Pfeiffer también proporcionó scripts de compilación y parches para volcar tablas ACPI y extraer el firmware del altavoz, permitiendo que otros repliquen la instalación.
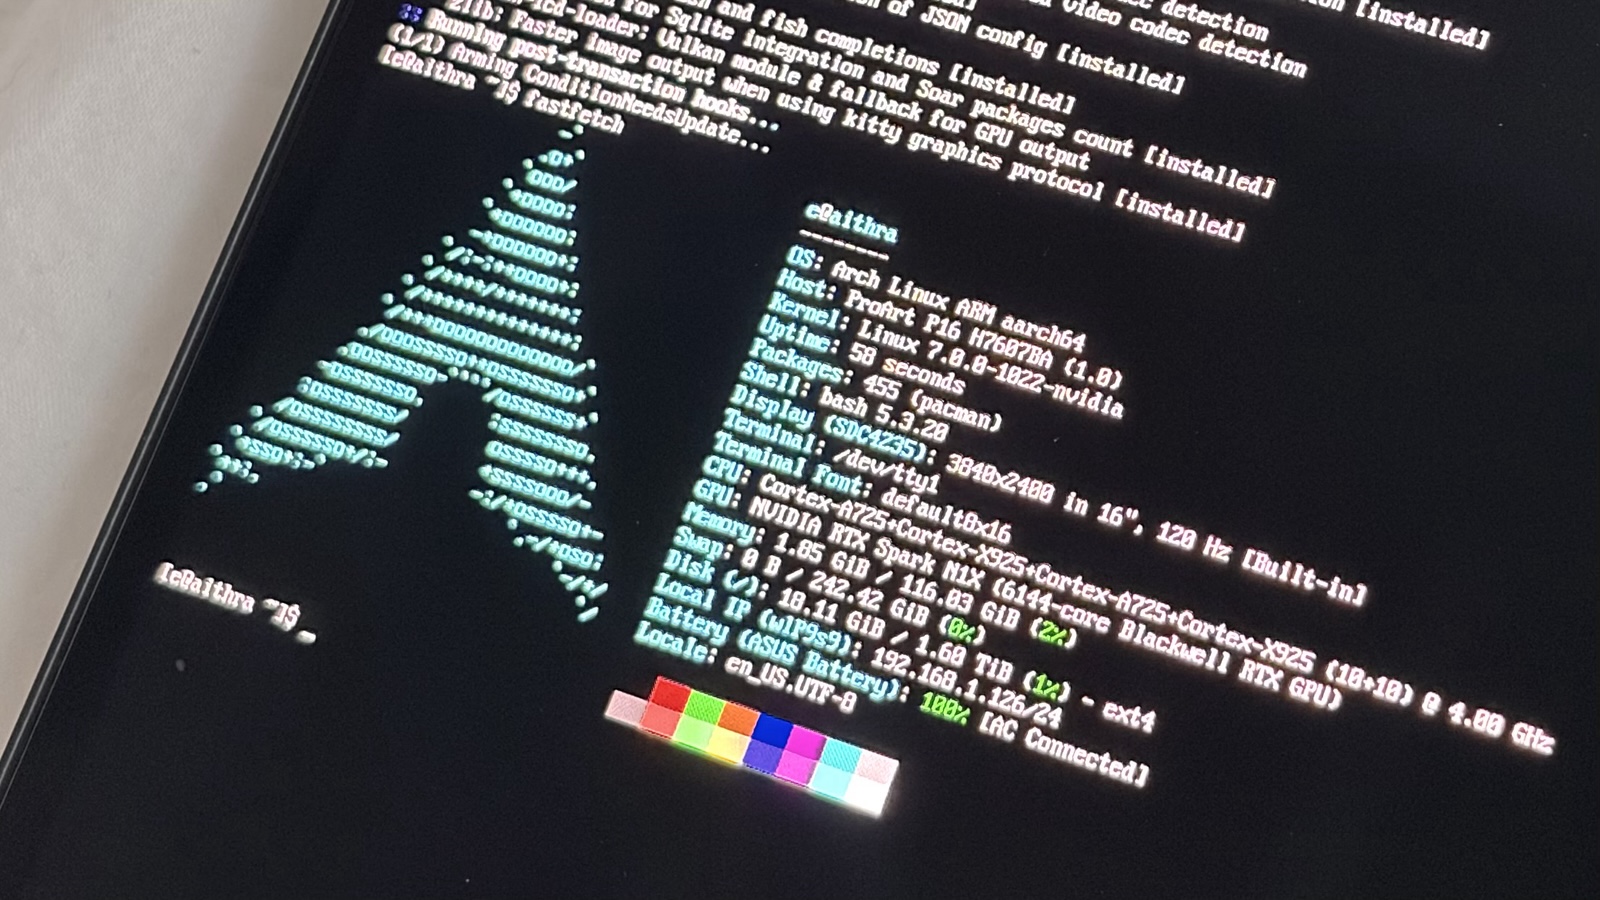
Esta imagen confirma la instalación exitosa de Arch Linux ARM en el hardware específico mencionado en el artículo.
Las pruebas de rendimiento revelaron que la configuración de Linux funciona de manera comparable a Windows en cargas de trabajo estándar. En las pruebas de compresión de 7-Zip, la configuración de Linux fue aproximadamente un 5% más rápida que una HP OmniBook comparable ejecutando Windows ARM64. Una distinción técnica significativa señalada por Pfeiffer es la gestión de memoria: mientras que Windows divide la RAM en regiones dedicadas, compartidas y solo para CPU, la configuración de Linux informa los 116.0 GiB completos como un grupo unificado accesible tanto para el sistema como para CUDA. Esto permite asignaciones de modelos más grandes sin ajustar manualmente las reservas de memoria. En pruebas prácticas ejecutando el modelo Qwen3.8-Flash-Next, la configuración manejó con éxito tareas complejas como revisiones de código y análisis de registros de incidentes con tiempos de respuesta consistentes y alta precisión en múltiples iteraciones.
A pesar del éxito del port, el hardware sigue siendo un punto de entrada de alto costo para el desarrollo local de IA, con un precio de venta de aproximadamente $6,000. Si bien el grupo de memoria unificada ofrece una ventaja técnica para la inferencia de modelos grandes, los requisitos de energía del hardware y la complejidad del port manual de Linux pueden limitar su atractivo para usuarios que no requieren personalizaciones específicas a nivel de sistema operativo. Además, aunque el port de Linux evita la necesidad de una cuenta de Microsoft, requiere un esfuerzo manual significativo para configurar controladores y firmware en comparación con la experiencia de Windows lista para usar que ofrece el fabricante.
Una limitación notable de la configuración actual es la dependencia de versiones específicas de kernel y controladores (Kernel 7.0.0-1022-nvidia y controlador 615.78.08) para mantener la estabilidad. A medida que los ecosistemas de hardware y software evolucionan, mantener estos parches personalizados y asegurar la compatibilidad continua con nuevos controladores de NVIDIA será una tarea recurrente para los usuarios que busquen mantener el sistema actualizado. El trabajo de Pfeiffer proporciona una vía viable para desarrolladores que priorizan entornos de código abierto, pero resalta la fricción continua entre el hardware especializado de gama alta y el soporte de software no propietario.
Una de las ventajas más significativas de este port de Linux es la arquitectura de memoria unificada. A diferencia de Windows, que particiona los 128 GB de RAM en cubetas específicas para la CPU y la GPU, el entorno Linux trata la memoria como un grupo único. Esto permite que el sistema asigne dinámicamente hasta 90 GiB para un solo modelo y su caché KV (caché de Clave-Valor) sin que el usuario necesite reiniciar o ajustar manualmente.