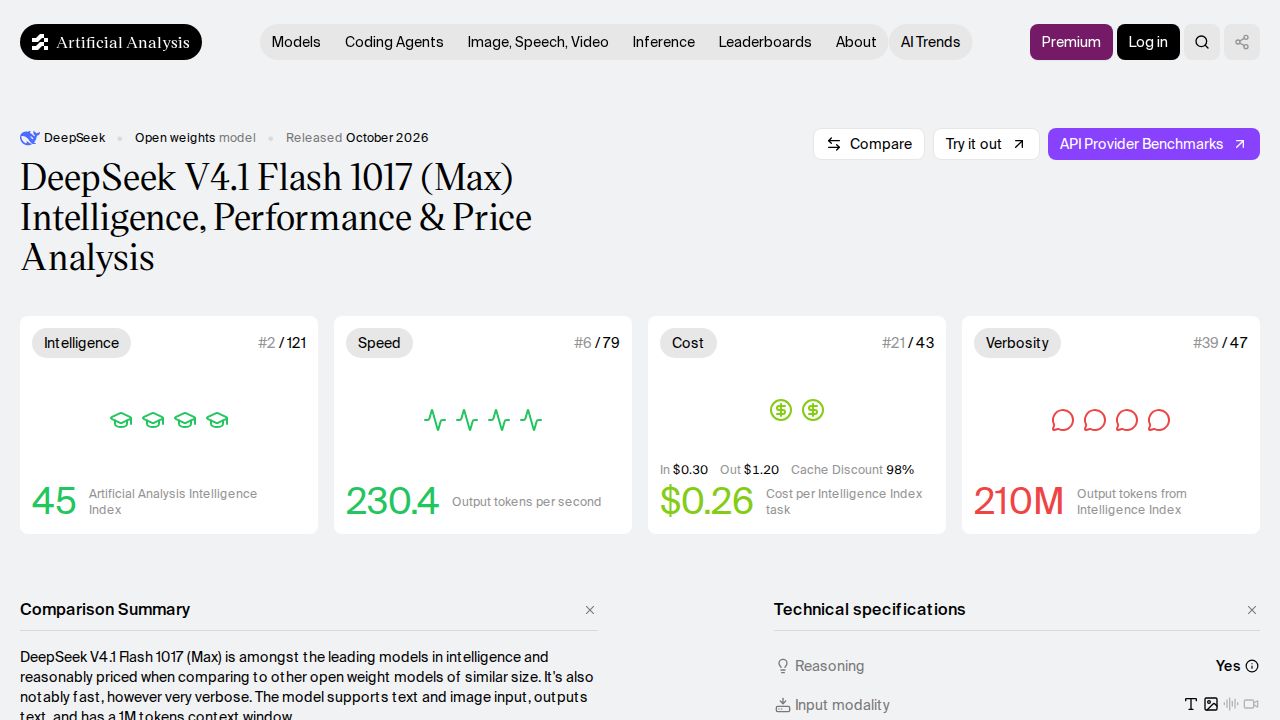
El modelo DeepSeek V4.1 Flash 1017 (Max) ha generado una discusión significativa con respecto a su equilibrio entre el recuento de parámetros, la velocidad y las capacidades de razonamiento. Un detalle técnico notable es su arquitectura, que utiliza una estructura de parámetros de 536+16B (pasivos+activos). Esta configuración le permite alcanzar un rendimiento comparable al de modelos más grandes, como el Mimo v2.6 Pro, a pesar de tener aproximadamente la mitad del tamaño. Si bien el modelo es elogiado por su alto rendimiento (tokens por segundo), algunos usuarios señalaron que puede ser redundante en sus respuestas, lo que sugiere que el ajuste fino futuro podría ser necesario para mejorar la eficiencia de los tokens.
Las comparaciones con otros modelos revelan diversas compensaciones en costo y velocidad. Por ejemplo, algunos usuarios señalaron que GPT 6.1 Sol (medium) puede ser tanto más barato como más rápido por tarea que la configuración DeepSeek V4.1 Flash 1017 (max). Esto resalta una distinción crítica entre los esfuerzos de razonamiento 'max' y las configuraciones estándar; mientras que el esfuerzo 'max' busca una mayor inteligencia, puede aumentar significativamente el tiempo y el recuento de tokens requeridos para una mejora de rendimiento relativamente pequeña. Algunos evaluadores informaron que el ajuste 'max' utilizó casi el doble de tokens que el ajuste 'high' con pocos o ningún beneficio perceptible en casos de uso específicos.
El despliegue práctico en hardware de consumo también sigue siendo un punto clave de interés. Aunque algunos usuarios han ejecutado con éxito modelos DeepSeek V4 Flash en configuraciones de consumo de alta gama como un Mac Studio con 128GB de RAM, existe un debate continuo sobre si estos modelos pueden ejecutarse de manera efectiva en hardware de gama baja (por ejemplo, una 2080ti con 128GB de RAM) manteniendo una inteligencia razonable. Además, se están explorando posibilidades técnicas como la transmisión de pesos desde un SSD —lo que puede reducir el rendimiento pero aumentar la accesibilidad— como formas de hacer que estos modelos grandes sean más utilizables en configuraciones de hardware generales.