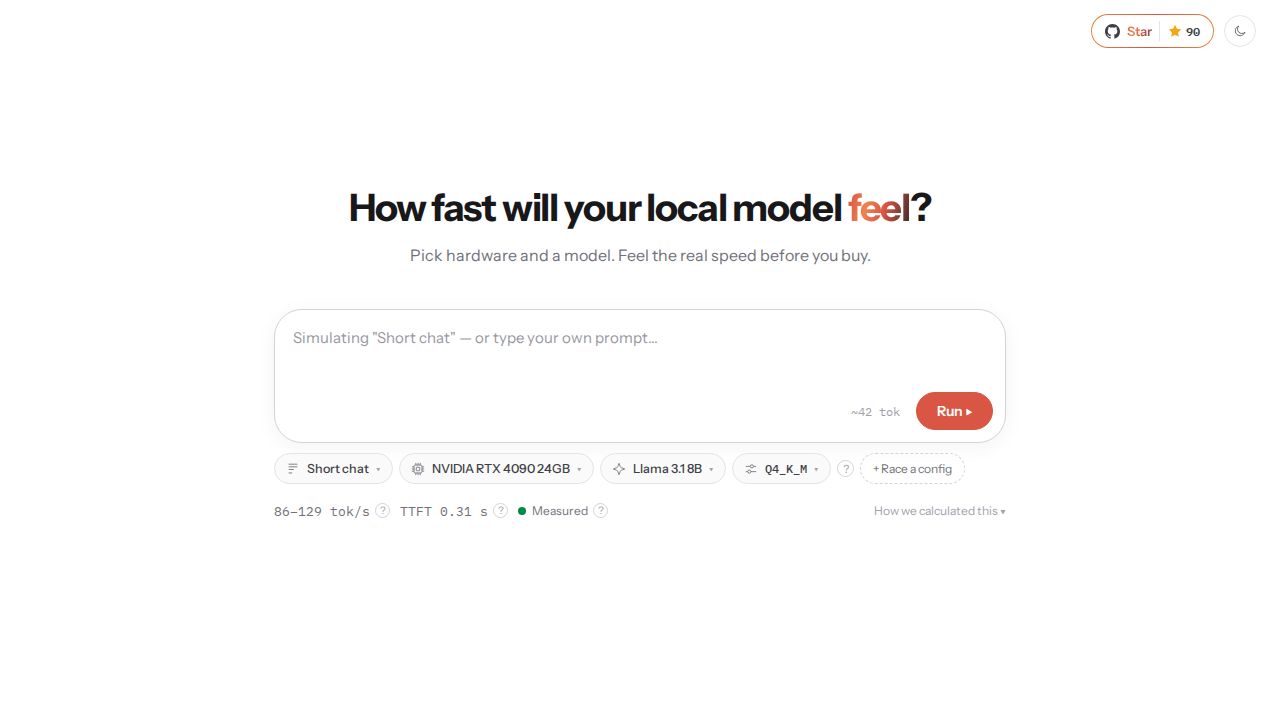
Llmspeed es una herramienta basada en la web diseñada para ayudar a los usuarios a estimar qué tan rápido se ejecutará un modelo de lenguaje de gran tamaño (LLM) local en un hardware específico. Al proporcionar un catálogo de configuraciones de hardware —que van desde GPUs de consumo como la NVIDIA RTX 5090 hasta estaciones de trabajo de alta gama como la Mac Studio M5 Ultra— y una variedad de modelos como Qwen, Gemma 4 y DeepSeek, la herramienta permite a los usuarios visualizar métricas de rendimiento como tokens por segundo (tk/s) y el tiempo hasta el primer token (TTFT) sin necesidad de descargar y ejecutar los modelos por sí mismos.
La herramienta deriva sus estimaciones de pruebas de rendimiento de la comunidad (como r/LocalLLaMA y localscore.ai) y proyecciones basadas en las especificaciones del hardware. Proporciona una forma para que los usuarios evalúen las compensaciones entre el tamaño del modelo, los niveles de cuantización (por ejemplo, 4 bits o 8 bits) y los límites de memoria del hardware. Por ejemplo, puede mostrar cómo un modelo específico podría caber en la VRAM de una GPU o si una configuración es físicamente capaz de ejecutar los parámetros de un modelo determinado.
Sin embargo, los usuarios y observadores técnicos señalan que estas estimaciones representan una instantánea específica del rendimiento y pueden no capturar la complejidad total del uso en el mundo real. La discusión en torno a la herramienta destaca que el rendimiento puede variar significativamente según las implementaciones del motor de inferencia, las optimizaciones de software específicas (como la decodificación especulativa) y el tamaño de la ventana de contexto. Por ejemplo, aunque un modelo puede funcionar bien en un prompt corto, el rendimiento puede degradarse a medida que la ventana de contexto crece. Además, algunos usuarios señalaron que las cargas de trabajo agénticas en el mundo real —que a menudo involucran prompts grandes y una gestión compleja de la caché KV— podrían generar un rendimiento menor que los números máximos mostrados en las pruebas de rendimiento simplificadas. La herramienta sirve como un recurso de planificación de alto nivel, pero el rendimiento real sigue estando sujeto al stack de software específico y a los matices del hardware utilizados por el usuario final.