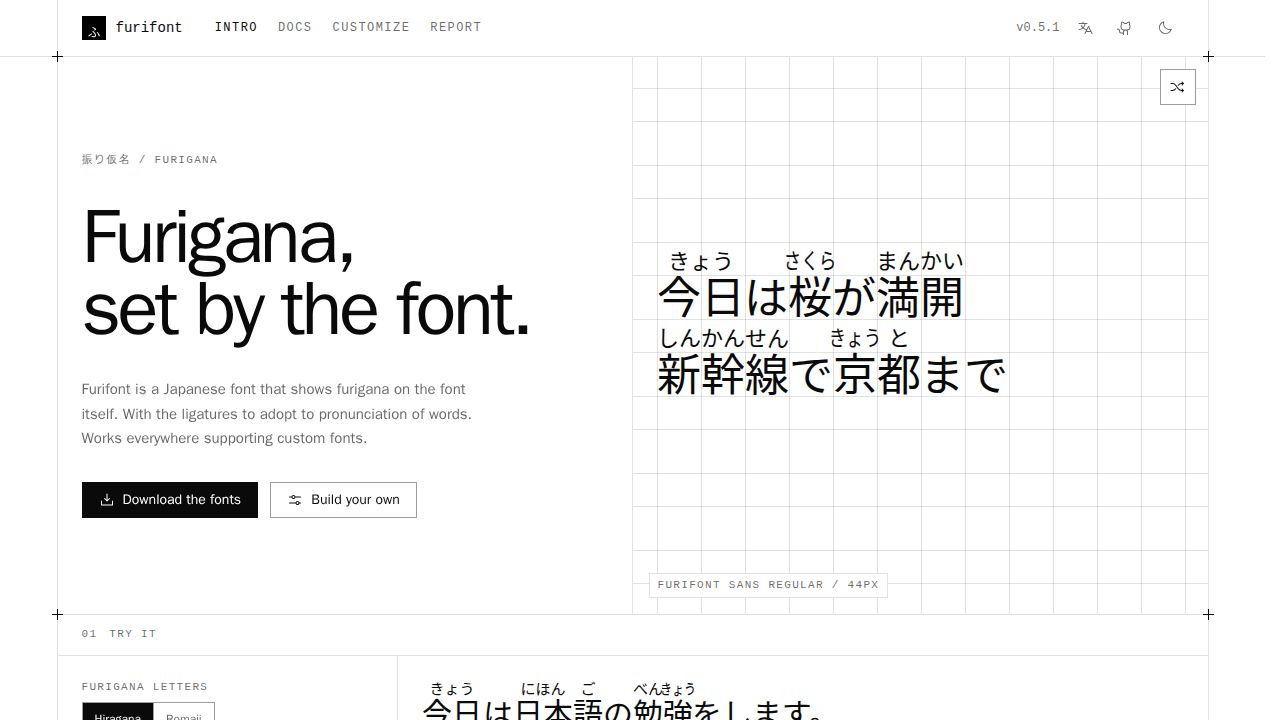
Furifont es una fuente japonesa diseñada para mostrar automáticamente furigana —pequeños caracteres fonéticos colocados encima o al lado de los kanji— directamente a través del motor de renderizado de la fuente. Al utilizar ligaduras de fuentes, el proyecto pretende proporcionar una forma fluida para que los usuarios vean las lecturas de kanji complejos sin requerir la inserción manual de etiquetas Ruby, que son el método estándar para mostrar furigana en medios web e impresos. Este enfoque es particularmente útil en contextos donde es difícil aplicar el formato tradicional, como en ciertos lectores de libros electrónicos, aplicaciones personalizadas o entornos web específicos.
El mecanismo se basa en la flexibilidad de las especificaciones de fuentes TrueType y OpenType, que permiten un modelado complejo y ligaduras. Cuando se escribe una secuencia específica de caracteres, la fuente los reemplaza con un solo glifo que incluye tanto el kanji como su furigana correspondiente. Sin embargo, este método enfrenta un desafío lingüístico significativo: las lecturas de los kanji japoneses dependen en gran medida del contexto. Muchos caracteres tienen múltiples lecturas distintas dependiendo de las palabras circundantes, y algunos pueden tener docenas de pronunciaciones diferentes. Debido a que el motor de modelado de una fuente normalmente opera en secuencias de caracteres locales en lugar de en el contexto de la oración completa, puede tener dificultades para determinar la lectura correcta de palabras ambiguas, lo que podría dar lugar a guías fonéticas inexactas.
Los usuarios y observadores han señalado tanto la utilidad creativa como las limitaciones prácticas de este enfoque. Para los estudiantes de idiomas, la fuente proporciona un puente útil para leer textos complejos, aunque algunos han señalado que puede fallar cuando las palabras se dividen en los saltos de línea, lo que provoca que la fuente pierda el contexto necesario para seleccionar la ligadura correcta. Además, debido a que la fuente no puede actualmente dar cuenta de los vastos matices de la gramática y el vocabulario japoneses —una tarea con la que incluso los grandes modelos de lenguaje tienen dificultades— existe el riesgo de enseñar a los estudiantes pronunciaciones incorrectas. Si bien el proyecto representa un uso innovador de la ingeniería de fuentes, su fiabilidad sigue estando limitada por la complejidad inherente de las reglas fonéticas del idioma japonés.
En la discusión en torno al proyecto, algunos participantes destacaron que, si bien es difícil perfeccionar el furigana automático, la fuente aún podría servir como una herramienta valiosa para aquellos que tienen dificultades con el reconocimiento básico de kanji. Otros sugirieron que el valor principal del proyecto reside en su capacidad para funcionar en entornos donde no se admiten las etiquetas Ruby estándar, como en ciertos dispositivos de lectura digital. También se discutió la viabilidad técnica de mejorar la precisión, y algunos sugirieron que la integración de algoritmos de segmentación más avanzados o incluso la ejecución de modelos de lenguaje dentro del motor de modelado podrían abordar eventualmente los problemas de dependencia del contexto que actualmente limitan la precisión de la fuente.
En última instancia, Furifont sirve como un experimento único en tipografía y lingüística. Demuestra el poder de las especificaciones de fuentes modernas para resolver problemas de visualización, al tiempo que resalta los límites de lo que se puede lograr únicamente mediante el modelado de caracteres locales. Por el momento, sigue siendo una herramienta especializada que equilibra la tipografía de alta tecnología con las complejidades del lenguaje.