Apple Machine Learning Research ha demostrado la capacidad de ejecutar modelos de lenguaje de gran tamaño (LLM) de clase frontera en hardware de Mac Studio utilizando el framework MLX. MLX es un framework de arreglos de código abierto diseñado para aprovechar la arquitectura de memoria unificada de Apple silicon, lo que permite a los desarrolladores realizar inferencias y ajustes finos localmente. La investigación destaca la capacidad de ejecutar Muse Spark Open, un modelo de mezcla de expertos (MoE) con casi un billón de parámetros, utilizando un clúster de Mac Studios. En sus pruebas, un clúster de cuatro máquinas logró más de 36 tokens por segundo con un tamaño de contexto de 8,192 tokens, lo cual supera las velocidades promedio de lectura humana.
MLX es un framework de arreglos de código abierto diseñado para aprovechar la arquitectura de memoria unificada de Apple silicon, lo que permite a los desarrolladores realizar inferencias y ajustes finos localmente.
El rendimiento de estos modelos está fuertemente influenciado por la arquitectura de memoria del hardware y los aceleradores especializados. Por ejemplo, el chip M5 Ultra cuenta con un Acelerador Neural de GPU que admite multiplicación de matrices dedicada, el cual, según informa Apple, puede acelerar el 'tiempo hasta el primer token' (TTFT) hasta 4.6 veces en comparación con la generación anterior M3 Ultra. Si bien modelos más pequeños como Qwen 3.8 (27B) y Mistral Medium 3.5 (128B) caben en un solo Mac Studio con 512GB de memoria unificada, el modelo Muse Spark Open requiere más de 1.6TB de RAM en su precisión nativa. Incluso cuando se cuantiza a una precisión de 4 bits (NVFP4), la huella de memoria del modelo alcanza aproximadamente 493GB, lo que requiere la paralelización en múltiples máquinas para acomodar el modelo y los cálculos intermedios necesarios durante la inferencia.
Para manejar estos modelos masivos, MLX admite dos esquemas principales de paralelización: paralelización de tubería (pipeline) y paralelización de tensores. La paralelización de tubería divide las capas del modelo entre diferentes máquinas, donde un Mac Studio ejecuta la primera mitad de las capas y pasa la salida a la siguiente. La paralelización de tensores distribuye el ancho del modelo, donde cada máquina retiene una fracción de cada capa. Para hacer viable la paralelización de tensores, MLX utiliza un controlador RDMA (Remote Direct Memory Access) de baja latencia sobre Thunderbolt 5. Esto permite la comunicación de alta velocidad entre máquinas necesaria para agregar las salidas a través del clúster. Mientras que la paralelización de tubería ofrece simplicidad, la paralelización de tensores puede proporcionar aceleraciones significativas para arquitecturas densas a medida que se añaden más máquinas al clúster, siempre que la sobrecarga de comunicación se mantenga baja.
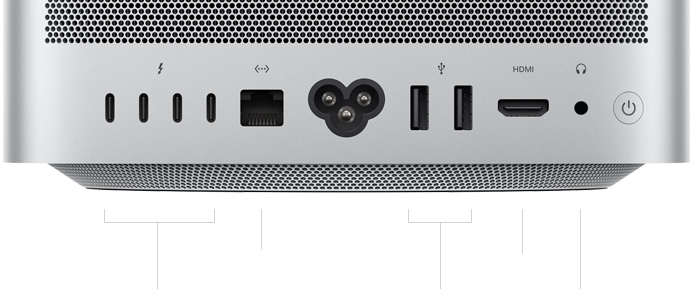
Para hacer viable la paralelización de tensores, MLX utiliza un controlador RDMA (Remote Direct Memory Access) de baja latencia sobre Thunderbolt 5.