Liquid AI ha lanzado LFM2.5-24B-A2B, el modelo más grande de su familia LFM2.5. El modelo está diseñado específicamente para agentes "on-device" (en el dispositivo), que son sistemas de IA que se ejecutan localmente en el hardware del usuario en lugar de en la nube, para garantizar la privacidad y una baja latencia. Utiliza una arquitectura Mixture-of-Experts (MoE), lo que permite que el modelo tenga un gran recuento total de parámetros (24 mil millones) mientras activa solo un pequeño subconjunto (2 mil millones) para cada token generado. Esta elección de diseño permite que el modelo se ejecute significativamente más rápido que otros modelos MoE comparables en hardware de consumo, logrando, por ejemplo, 184 tokens por segundo en un Apple M5 Max.

La imagen sirve como recurso visual principal para el modelo LFM2.5-24B-A2B, ilustrando su función como un agente en el dispositivo de alta velocidad.
El modelo LFM2.5-24B-A2B es un modelo de "razonamiento únicamente", lo que significa que está entrenado para producir una cadena de pensamiento explícita antes de entregar una respuesta final. Este enfoque está destinado a mejorar la calidad de las respuestas aprovechando las altas velocidades de decodificación de la arquitectura MoE. Para soportar tareas de agentes complejas, el modelo pasó por un proceso de post-entrenamiento de cinco etapas que incluyó Supervised Fine-Tuning (SFT), especialización de maestros y Agentic Reinforcement Learning. Estas etapas fueron diseñadas para ayudar al modelo a dominar la llamada de herramientas, las trayectorias de múltiples turnos y los patrones de interacción dentro de marcos de agentes populares como OpenClaw y Hermes Agent.
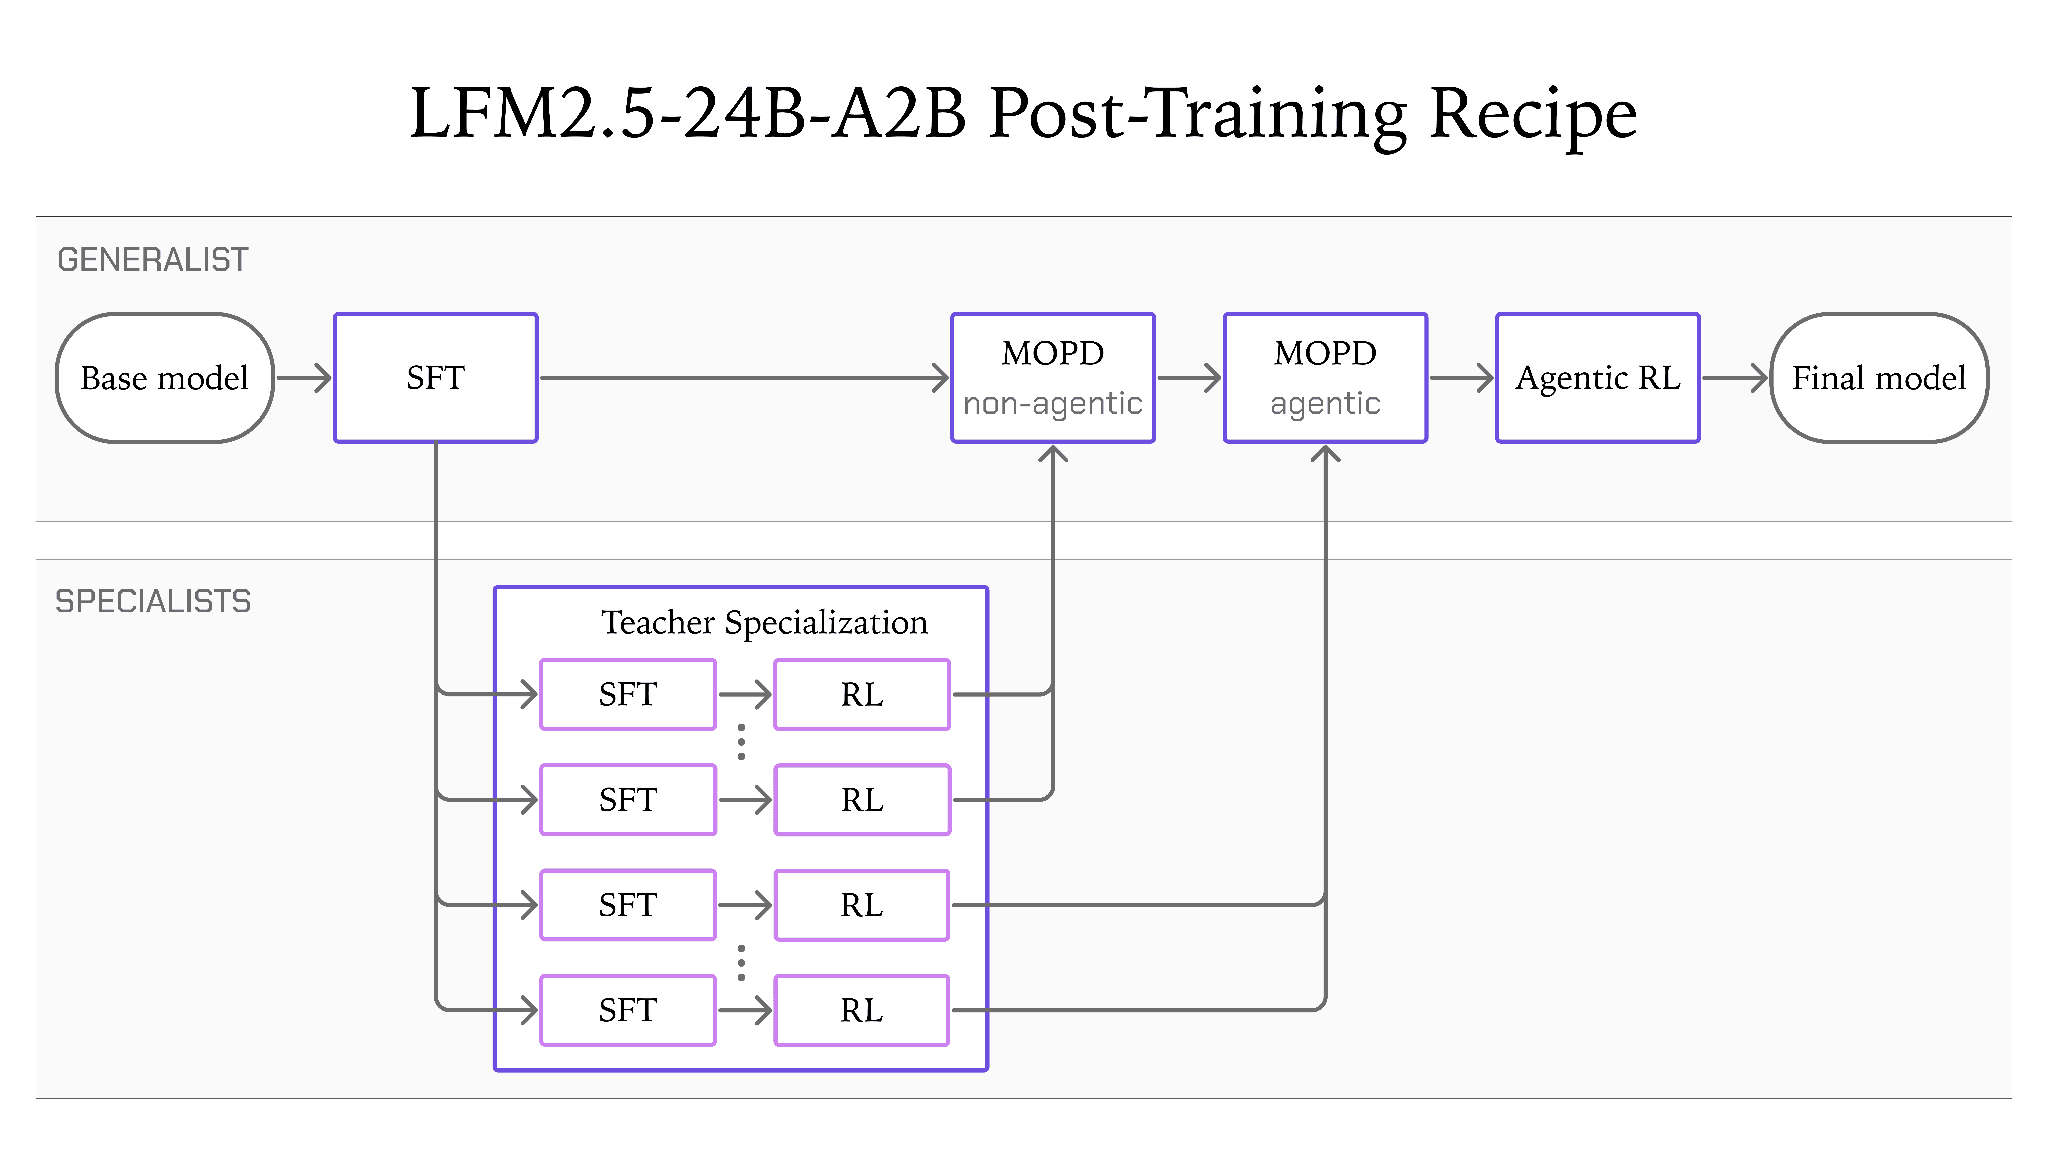
Este diagrama explica las etapas de entrenamiento específicas, incluyendo SFT y Agentic Reinforcement Learning, mencionadas en el texto.
Si bien el modelo muestra un sólido rendimiento en las pruebas de uso de herramientas y seguimiento de instrucciones —superando a algunos modelos más grandes en categorías como AutomationBench— enfrenta compromisos en tareas con gran carga de conocimiento. Liquid AI señala que para cargas de trabajo que requieren un conocimiento factual profundo, el modelo debe combinarse con generación aumentada por recuperación (RAG) o búsqueda web. Además, aunque el modelo destaca en velocidad y flujos de trabajo de agentes específicos, los usuarios han observado que puede tener dificultades con tareas de codificación complejas en comparación con modelos más grandes, lo que resalta el equilibrio entre su velocidad de inferencia optimizada y su capacidad de razonamiento profundo en dominios especializados.