Magnitude es una aplicación de escritorio de código abierto presentada como un motor de inferencia para agentes de IA. Según su repositorio de GitHub, compila y ajusta automáticamente sus núcleos de inferencia en el hardware específico del usuario antes de que se ejecute un modelo, eliminando la brecha de rendimiento causada por los núcleos precompilados genéricos utilizados por otros motores. El software se distribuye como una aplicación lista para ejecutar que incluye la CLI de magnitude, por lo que no se requiere instalación adicional y permite conexiones con un solo clic a agentes como Pi, OpenCode, Hermes, Codex y otros.
El proyecto afirma que esta auto‑optimización produce hasta el doble de velocidad de llama.cpp, citando resultados de referencia que muestran un 92 % más rápido en la decodificación de tokens en la API Metal de Apple Silicon y un 19 % más rápido en la decodificación en CUDA de NVIDIA, así como un 9 % más rápido en la prellenado en Metal y un 23 % más rápido en la prellenado en CUDA. También indica que cada agente consume un 27 % menos de memoria y que dicha memoria se libera cuando los agentes se detienen, mientras que las sesiones concurrentes comparten cachés de prefijo para evitar ralentizaciones. Estos beneficios se atribuyen a núcleos escritos a mano y optimizados para las familias de modelos de peso abierto más populares.
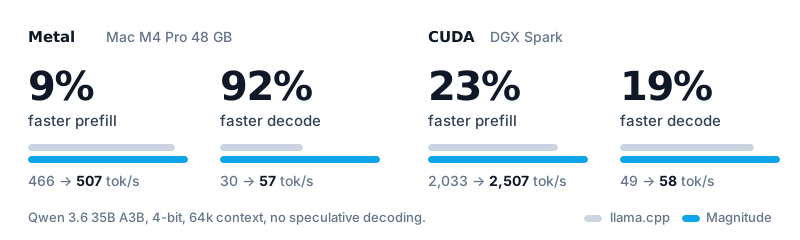
La imagen visualiza las reclamaciones de referencia mencionadas en el artículo, demostrando las ventajas de velocidad de Magnitude sobre llama.cpp en las API de Metal y CUDA tanto para tareas de prellenado como de decodificación.
Magnitude admite Apple Silicon, GPUs NVIDIA, AMD y sistemas solo CPU, sin un requisito mínimo de hardware fijo; las máquinas más pequeñas ejecutan modelos más pequeños y mayor memoria permite ejecutar modelos más grandes. El software está disponible para macOS, Linux y Windows y puede utilizarse con cualquier agente mediante una API compatible con OpenAI o mediante integraciones con un solo clic. El motor hace hincapié en la privacidad: los indicadores, los archivos y los modelos permanecen en la máquina del usuario y no se necesita conexión a internet después de descargar un modelo. Se publica bajo la licencia Apache 2.0 y es gratuito.