Los datos de mercado plantean un desafío único de modelado porque combinan elementos continuos y discretos. Aunque atributos individuales como el precio pueden variar continuamente, el libro de órdenes evoluciona a través de eventos discretos—colocaciones, cancelaciones y ejecuciones de órdenes—que ocurren en intervalos irregulares. Esta dualidad significa que los modelos generativos tradicionales, que asumen datos exclusivamente continuos o exclusivamente categóricos, tienen dificultades para capturar la microestructura de las series temporales financieras. En finanzas cuantitativas, los profesionales suelen predecir precios futuros a partir de flujos históricos de datos de mercado, pero generar datos sintéticos realistas requiere preservar tanto la dinámica continua de variables como el precio y el momento como la naturaleza discreta de los tipos de eventos. Un proyecto de pasantía de Jane Street liderado por Kavish exploró si la difusión autoregresiva podría cerrar esta brecha, adaptando técnicas que han tenido éxito en la generación de imágenes, video, robótica y audio a las características específicas de los eventos del libro de órdenes.
El equipo construyó una arquitectura codificador‑difusor: un codificador transformer con máscara causal crea una inserción latente para cada posición en la secuencia, que alimenta una pequeña cabeza categórica que predice si el próximo evento es una operación o una actualización de mejor‑oferta/mejor‑puja (BBO), mientras que una cabeza de difusión genera objetivos continuos como el precio, el tiempo transcurrido y el tamaño. Los experimentos iniciales utilizaron un Modelo de Difusión Probabilizante de Ruido (DDPM) con un programa coseno de 1.000 pasos y muestreo DDIM, pero esta configuración resultó inestable—las trayectorias de generación divergieron rápidamente, con el 88‑95 % de los valores superando ocho desviaciones estándar respecto a la media en todos los objetivos continuos. Como señaló un comentario en Hacker News, «DDPM falla porque los intervalos de los eventos del libro de órdenes son masas puntuales discretas, no gaussianas suaves». Cambiar al emparejamiento de flujo, que interpola linealmente entre el ruido y los datos y entrena a la red para predecir la velocidad a lo largo de esa línea, proporcionó un rendimiento estable desde el principio. Para manejar las discontinuidades inherentes de los datos de mercado (por ejemplo, el tiempo agrupado alrededor de cero y segundos enteros, los precios concentrándose en los puntos medios de puja‑oferta), Kavish refinaró la cabeza categórica en 20 clases que representan subtipos comunes de eventos y desarrolló un procedimiento de «suavizado atómico» que suaviza las distribuciones picosas y luego reescurre los picos para preservar la masa de probabilidad sin crear discontinuidades artificiales.
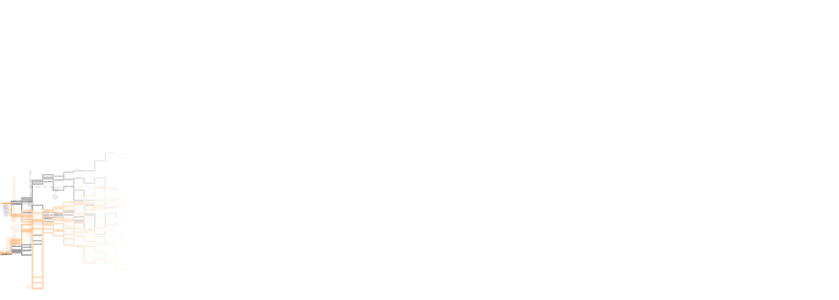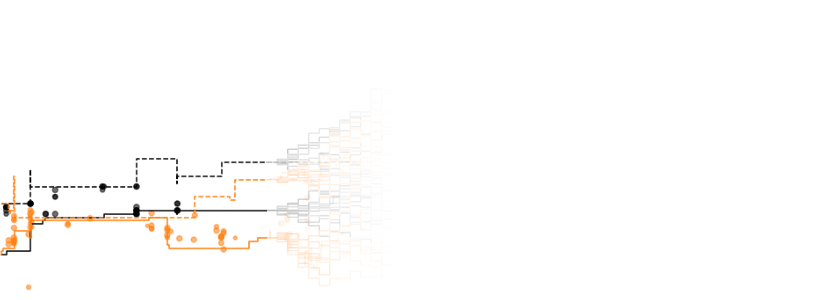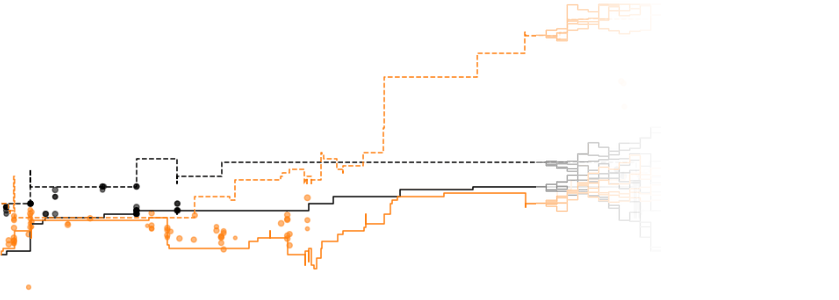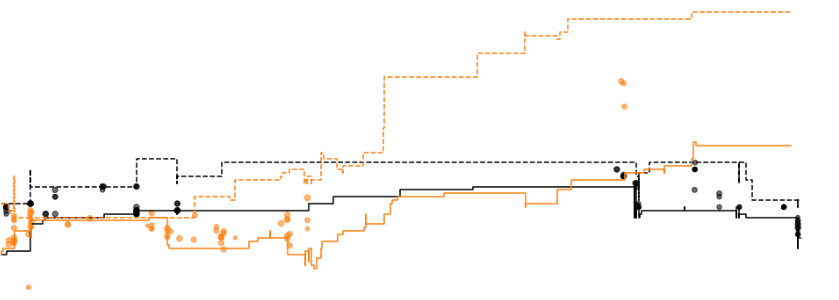
Esta imagen ilustra la arquitectura codificador‑difusor descrita en el artículo, donde un codificador transformer predice los tipos de eventos y una cabeza de difusión genera variables continuas como el precio y el tiempo.
La evaluación mostró que el modelo de emparejamiento de flujo con apretamiento atómico produjo distribuciones marginales mucho más cercanas a los datos reales y generó muestras más realistas cuando fueron discriminadas por un clasificador entrenado para distinguir la salida del modelo de eventos reales. Sin embargo, los despliegues autorregresivos revelaron que las trayectorias sintéticas se degradan en horizontes más largos—la dispersión en los precios sintéticos de CME de EE. UU. se amplía respecto a los datos reales, indicando errores acumulativos. En consecuencia, el modelo aún no es lo suficientemente preciso para servir como un generador práctico de datos de mercado. La pasantía aclaró dos preguntas abiertas para trabajos futuros: cuánta discreción debería modelarse explícitamente versus dejarla al proceso de difusión, y cómo representar y suavizar mejor las distribuciones de características para que la difusión pueda aprender eficazmente las estadísticas complejas y picosas de los datos del libro de órdenes. Como observó otro comentario, «La verdadera historia aquí es esta maravillosa exposición al aplicar modelos de difusión a datos de series temporales que no son ni discretos ni continuos».