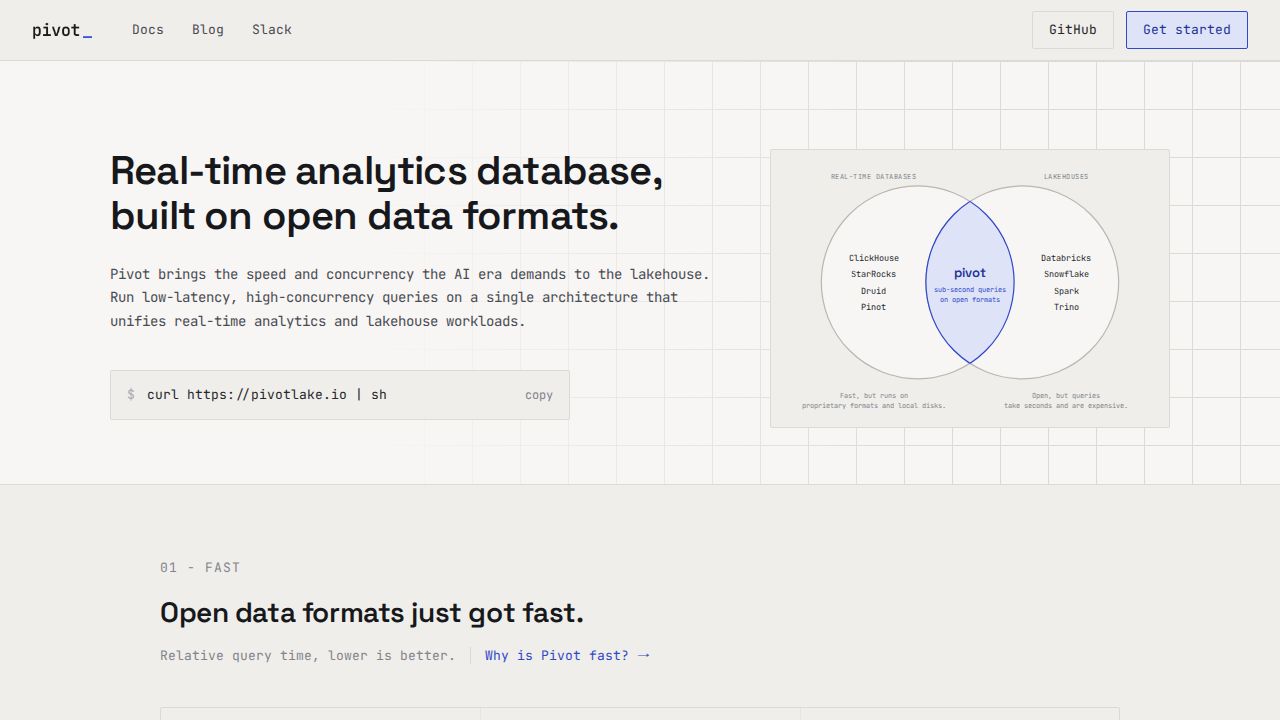
Pivot es una base de datos analítica de código abierto que permite a los usuarios ejecutar consultas SQL de baja latencia y alta concurrencia directamente en formatos de datos abiertos como Apache Iceberg y Delta Lake sin necesidad de copiar primero los datos a un motor propietario. Habla el protocolo de Postgres en el puerto 5432, por lo que los clientes SQL existentes, las herramientas de inteligencia de negocio y los agentes de IA pueden conectarse con psql o cualquier controlador compatible con Postgres y consultar los datos que permanecen en el almacenamiento de objetos.
Las mediciones de rendimiento incluidas en la documentación del proyecto muestran que Pivot supera a las bases de datos analíticas establecidas. En el conjunto de 43 consultas de ClickBench, Pivot (Parquet) registró un tiempo relativo de 1,09×, mientras que ClickHouse (nativo) fue 2,17× y DuckDB (nativo) 4,17×, lo que significa que Pivot ejecuta aproximadamente el doble de rápido que ClickHouse y casi cuatro veces más rápido que DuckDB. En la referencia TPC‑H SF1000, Pivot (Parquet) estableció la línea base en 1,00×, con DuckDB (Parquet) en 2,16×, ClickHouse (nativo) en 3,10× y Spark en 53,73×. El proyecto atribuye estas mejoras a un motor basado en Rust que utiliza Arrow para los datos en memoria, un modelo de ejecución de un hilo por núcleo, un asignador de memoria personalizado y algoritmos de JOIN y GROUP BY optimizados para maximizar el ancho de banda de memoria de las CPUs modernas.
Más allá de la velocidad, Pivot enfatiza la flexibilidad operativa y la apertura. Al considerar el almacenamiento de objetos como la única fuente de verdad y mantener únicamente un estado transitorio en memoria, las instancias pueden escalar hacia arriba, hacia abajo o a cero casi al instante, lo que permite cargas de trabajo ráfagas o autoescalado para ahorrar costos. Los usuarios pueden ejecutar Pivot como un servidor compartido para acceso concurrente o iniciarlo localmente desde una terminal para consultas ad hoc, y ambas vías acceden a las mismas tablas en el almacenamiento de objetos. El arnés de referencia y las consultas están disponibles públicamente en el repositorio, y los números reportados se obtuvieron en instancias AWS c8gd.metal‑48xl, por lo que los resultados pueden variar en otro hardware o cargas de trabajo.