openTPU es un proyecto de acelerador de IA de código abierto que combina diseño RTL, conjunto de instrucciones (ISA), simulador, compilador y perfilador en un único repositorio monolítico. Según su documentación, el proyecto explora hasta dónde pueden avanzar los agentes de IA en el diseño de hardware y si pueden crear chips capaces de ejecutar su propia inferencia. Toda la implementación del acelerador reside en un repositorio que contiene diseño de hardware en SystemVerilog, un conjunto de instrucciones definido, un simulador bit exacto, un lenguaje de kernel personalizado con su compilador y software host para controlar una tarjeta FPGA PCIe física (Inspur YPCB-00338 con Xilinx Kintex-7 xc7k480t y dos canales DDR3).
Esta imagen representa el repositorio monolítico de openTPU descrito en el artículo, que contiene las herramientas de diseño de hardware, conjunto de instrucciones, simulador, compilador y perfilador.
El acelerador emplea un modelo de ejecución sencillo en el que un secuenciador emite una instrucción por ciclo hacia unidades para DMA, multiplicación matricial (pesos int8 transmitidos desde DRAM), matemáticas vectoriales (fp32) y cuantización, sin caché ni programación oculta. Las mediciones de rendimiento muestran que la tarjeta FPGA logra tasas de generación de tokens comparables a las de su simulador, produciendo secuencias de tokens idénticas bit a bit. Por ejemplo, al ejecutar el modelo LFM2.5-230M en precisión int8, la tarjeta alcanza 59,0 tokens por segundo en el dispositivo y 52,3 tokens por segundo en tiempo de pared, mientras utiliza el 85 % del ancho de banda de DRAM disponible. La validación frente a Hugging Face transformers con el esquema de cuantización del proyecto muestra un acuerdo top-1 superior al 96 % y una divergencia KL baja para modelos como Qwen3-0.6B y LFM2.5-230M.
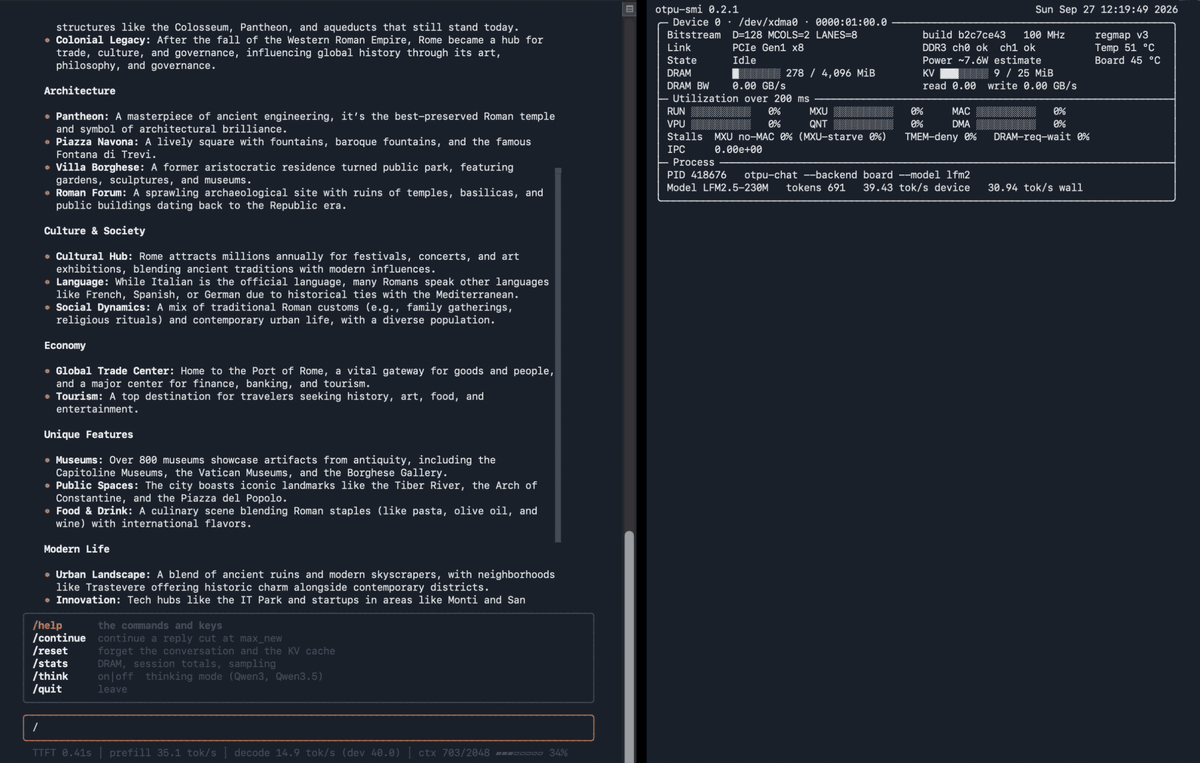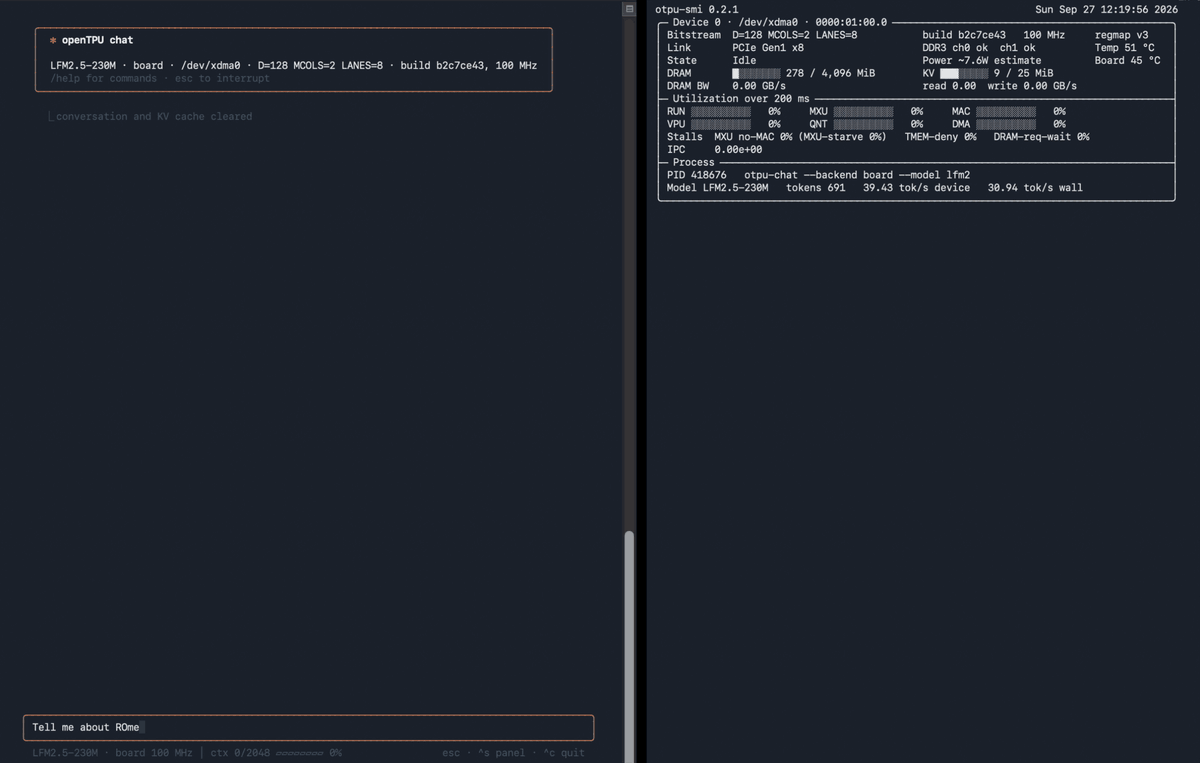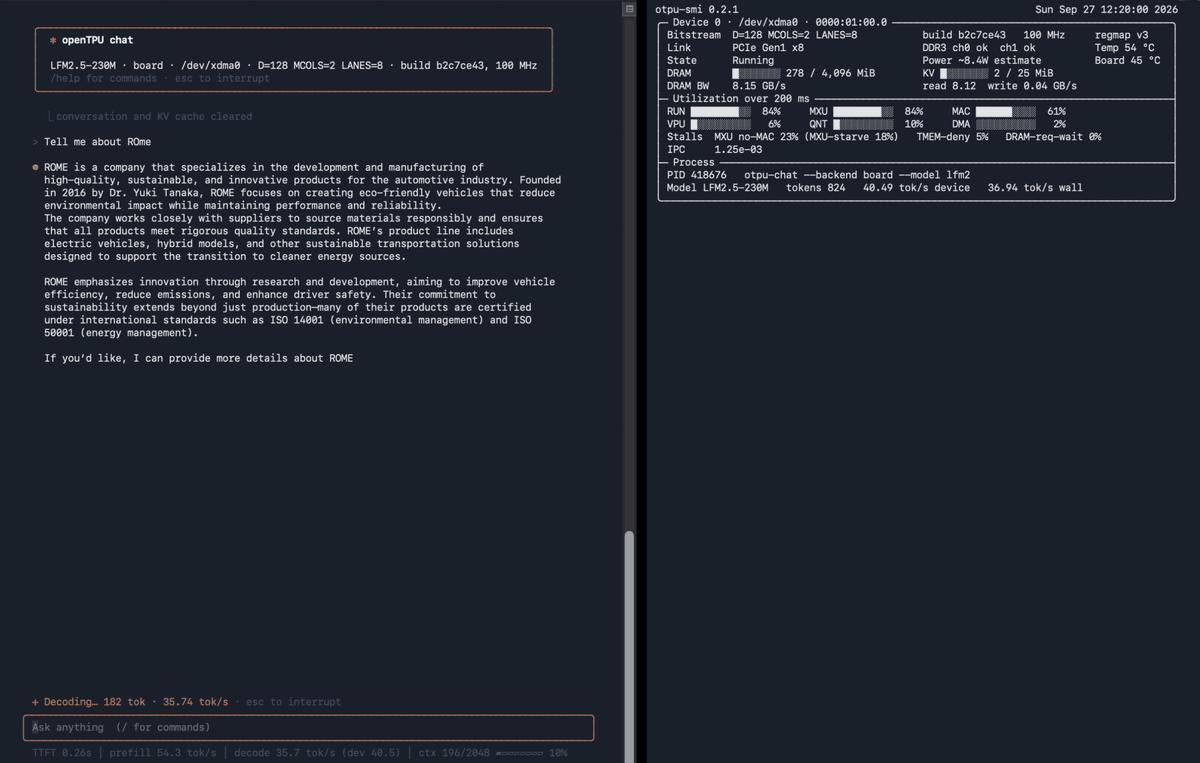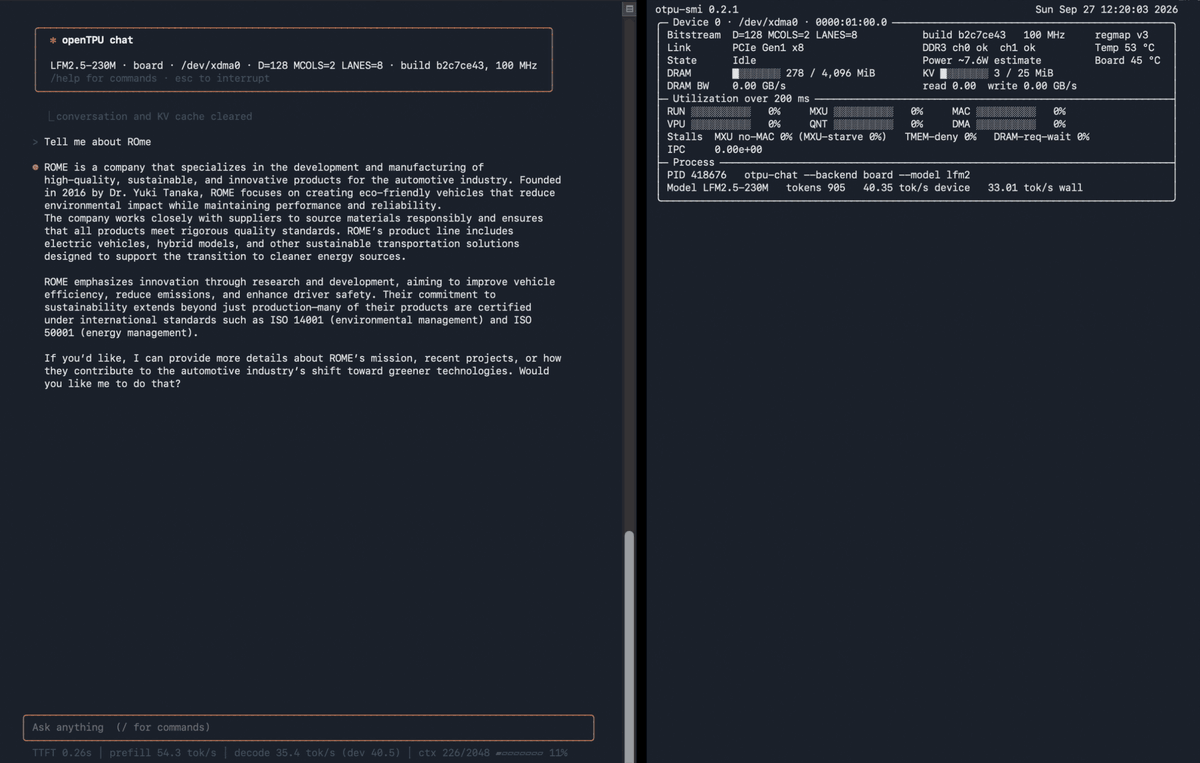
Esta imagen ilustra el rendimiento en el mundo real del acelerador openTPU ejecutando un modelo de lenguaje cuantizado, coincidiendo con la discusión del artículo sobre tasas de generación de tokens y salida idéntica al simulador.
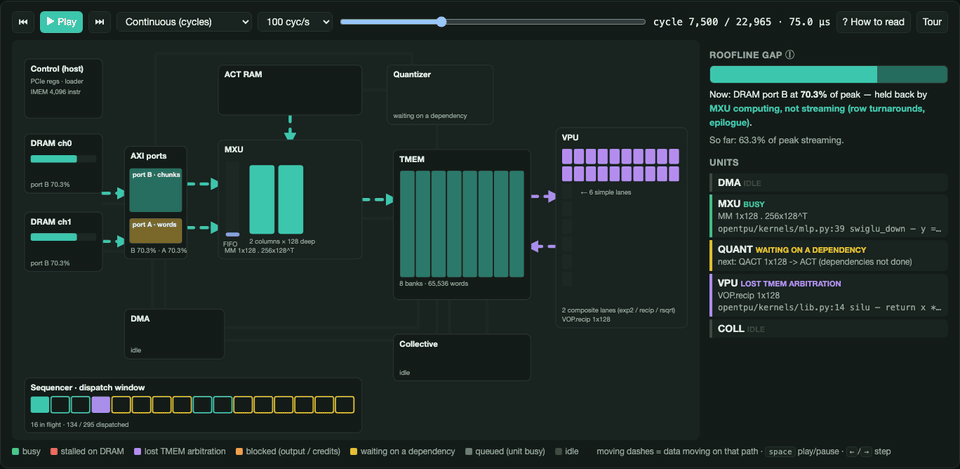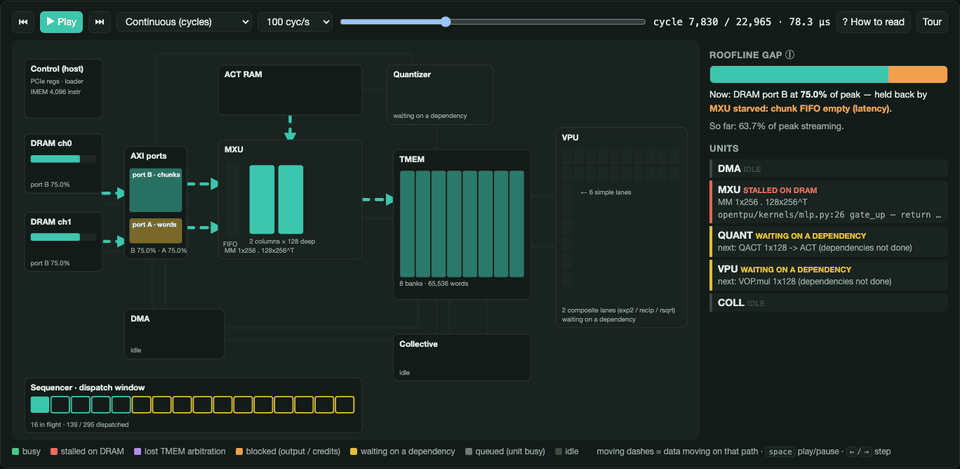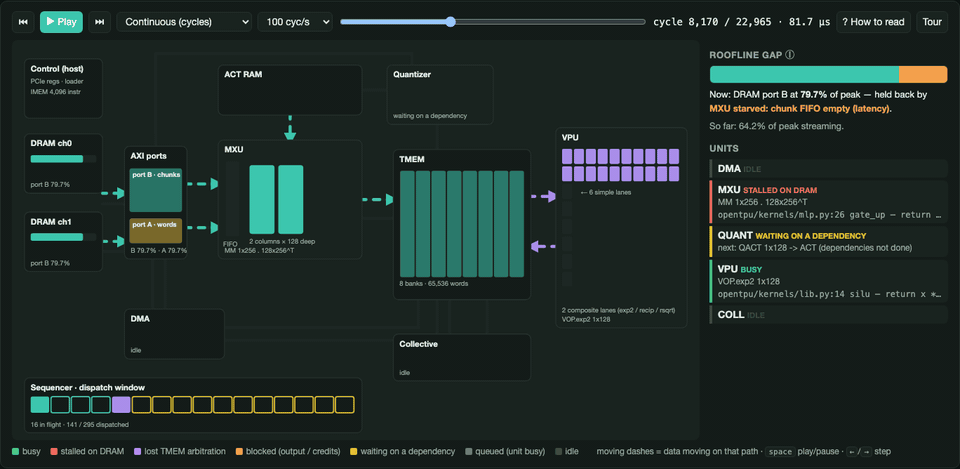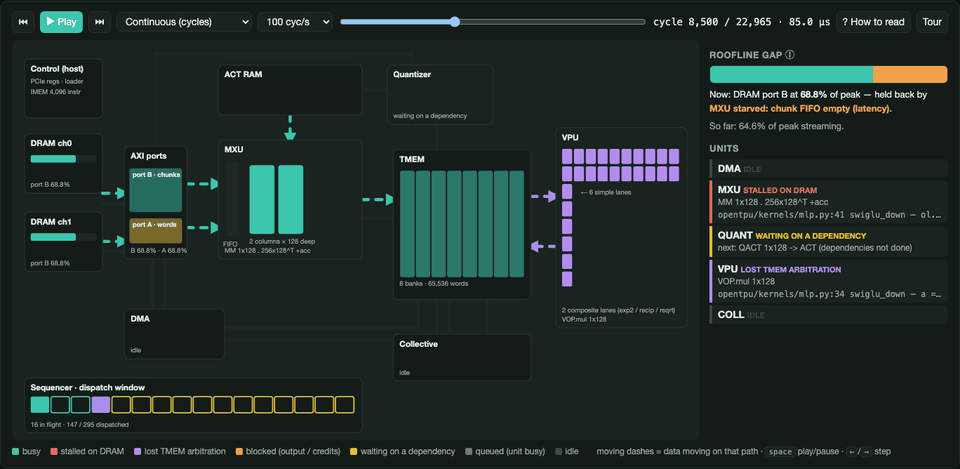
Esta imagen muestra el plano de hardware y el comportamiento en tiempo de ejecución de un paso de decodificación, respaldando la mención del artículo del simulador bit exacto y la ejecución de Qwen3.
Existen limitaciones y compensaciones: para modelos mixture-of-experts que exceden los 4 GiB de DRAM de la tarjeta (p. ej., Qwen3.5-35B-A3B), los expertos se transmiten desde el almacenamiento host a través de PCIe a tasas de hasta 153 MB por token; la cuantización de pesos de 4 bits reduce el uso de memoria en alrededor de un tercio y acelera la decodificación entre un 40 % y un 45 %, pero implica un coste medible en perplexidad que se reporta en la documentación del proyecto; y ciertas operaciones, como el prefill de Qwen3.5, todavía requieren la compilación host de cada fragmento del programa antes de su ejecución, lo que indica que el host no queda totalmente fuera del bucle para todas las cargas de trabajo.