Mistral Large 4, lanzado como vista previa pública en octubre de 2026, es un modelo de IA de pesos abiertos con 1 billón de parámetros totales y decenas de miles de millones de parámetros activos, entrenado desde cero en 3 800 GPUs NVIDIA Grace Blackwell en los propios centros de datos europeos de Mistral【support-2】. El modelo enfatiza la soberanía de la IA europea al ser desarrollado y operado dentro de Europa, con el objetivo de brindar a los clientes control sobre su IA mientras cumple con las regulaciones regionales.
En el benchmark especializado de análisis de datos de Plotly, Mistral Large 4 demostró un salto generacional sobre su predecesor Mistral Medium 3.5【primary】. El costo por ejecución completa del examen cayó de $20.51 a solo $1.94 —una reducción de 10×— mientras que el porcentaje de respuestas correctas aumentó del 58 % (una calificación F) al 74 % (una calificación C). El examen utiliza un conjunto de datos simulado realista de turbinas eólicas con 20 M de filas en 44 tablas, que prueba análisis multietapa como la detección de rachas, joins punto a punto en el tiempo y la identificación de problemas de calidad de datos.
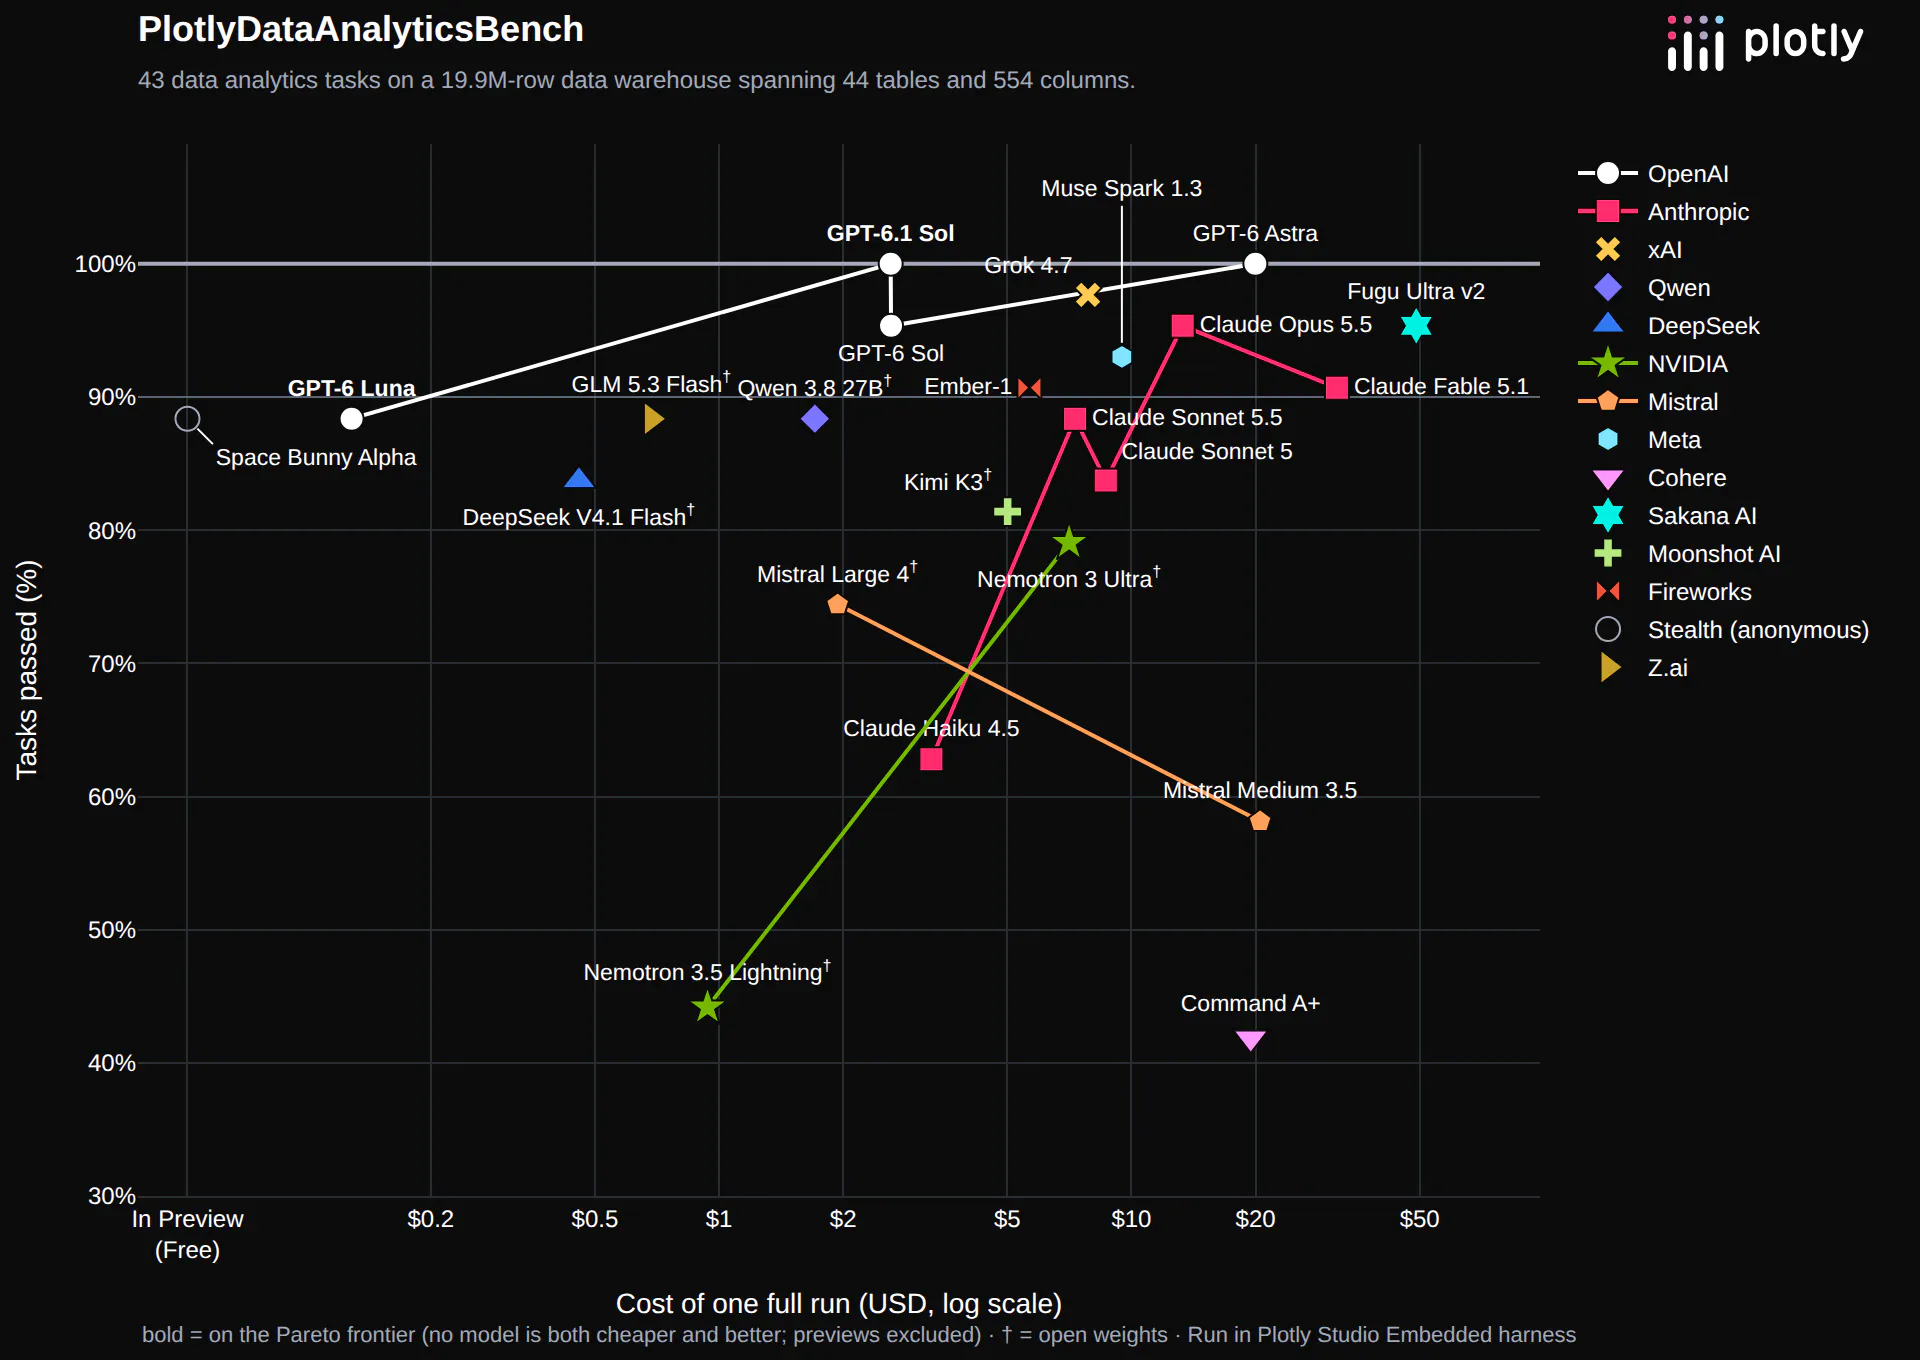
Esta imagen respalda el afirmación del artículo de que Mistral Large 4 ofrece una alternativa rentable, situándolo en el mismo rango que modelos como GPT‑6.1 Sol y Qwen 3.8 27B.
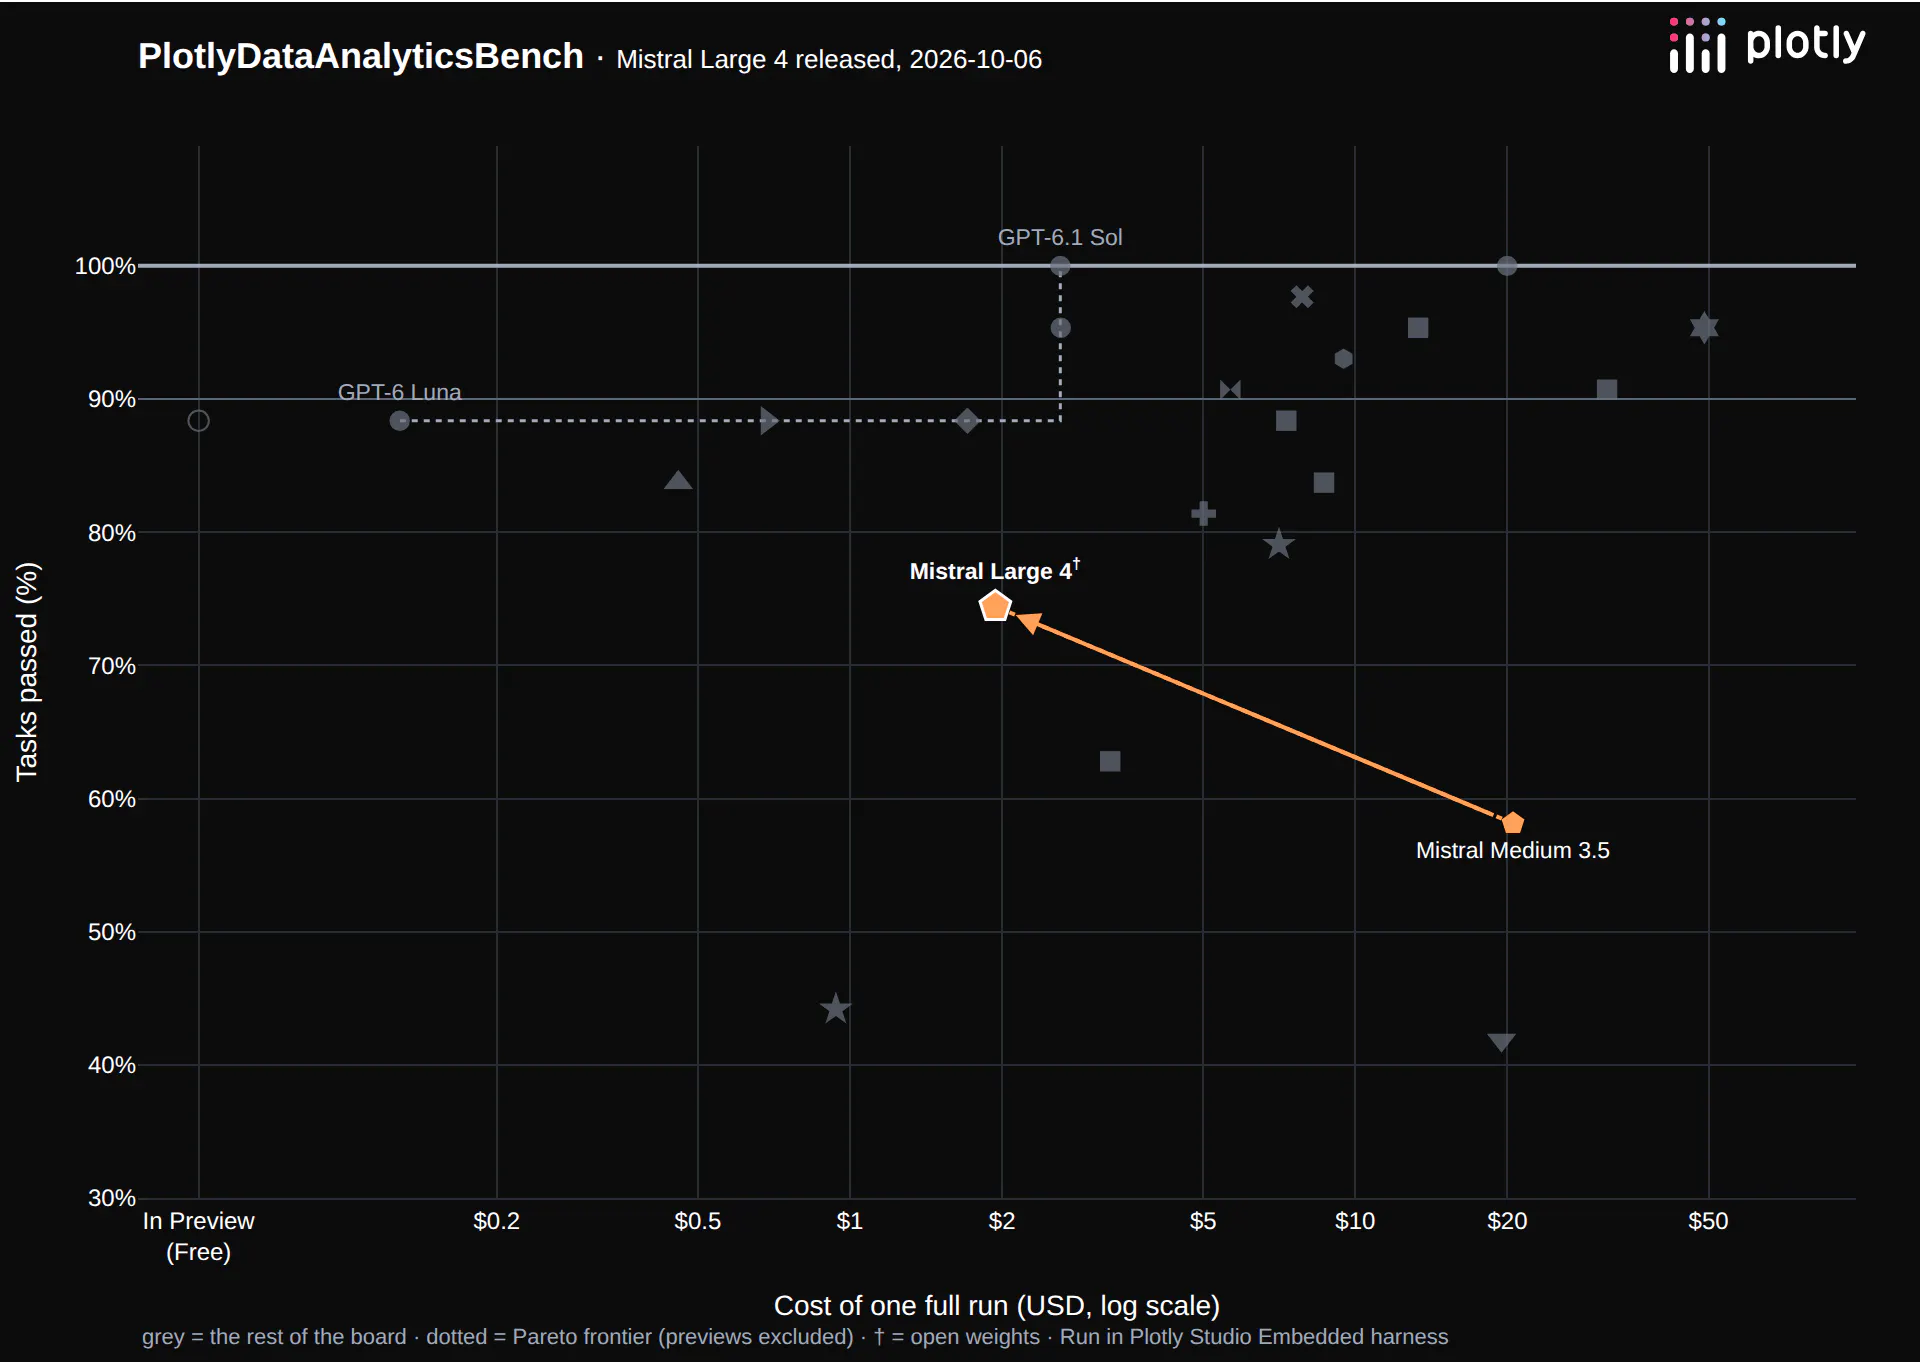
Esta imagen ilustra el salto generacional en rendimiento y eficiencia de costo descrito en el segundo párrafo del artículo, donde la puntuación de Mistral Large 4 en el examen pasó del 58 % al 74 % mientras el costo se redujo diez veces.
A pesar de estas mejoras, Mistral Large 4 aún muestra debilidades notables en el mismo benchmark【primary】. Ocasionalmente informa sumas como promedios, confía en los conteos de filas sin detectar datos duplicados y afirma cobertura total cuando existen brechas significativas —errores que podrían conducir a conclusiones empresariales erróneas. Su rendimiento en preguntas ambiguas disminuyó ligeramente de 4/5 a 3/5 correctas, y aunque se queda detrás de los modelos más precisos en precisión absoluta, su eficiencia de costo lo sitúa en el mismo rango que modelos como OpenAI GPT‑6.1 Sol ($2.61 por ejecución) y Qwen 3.8 27B ($1.71 por ejecución).