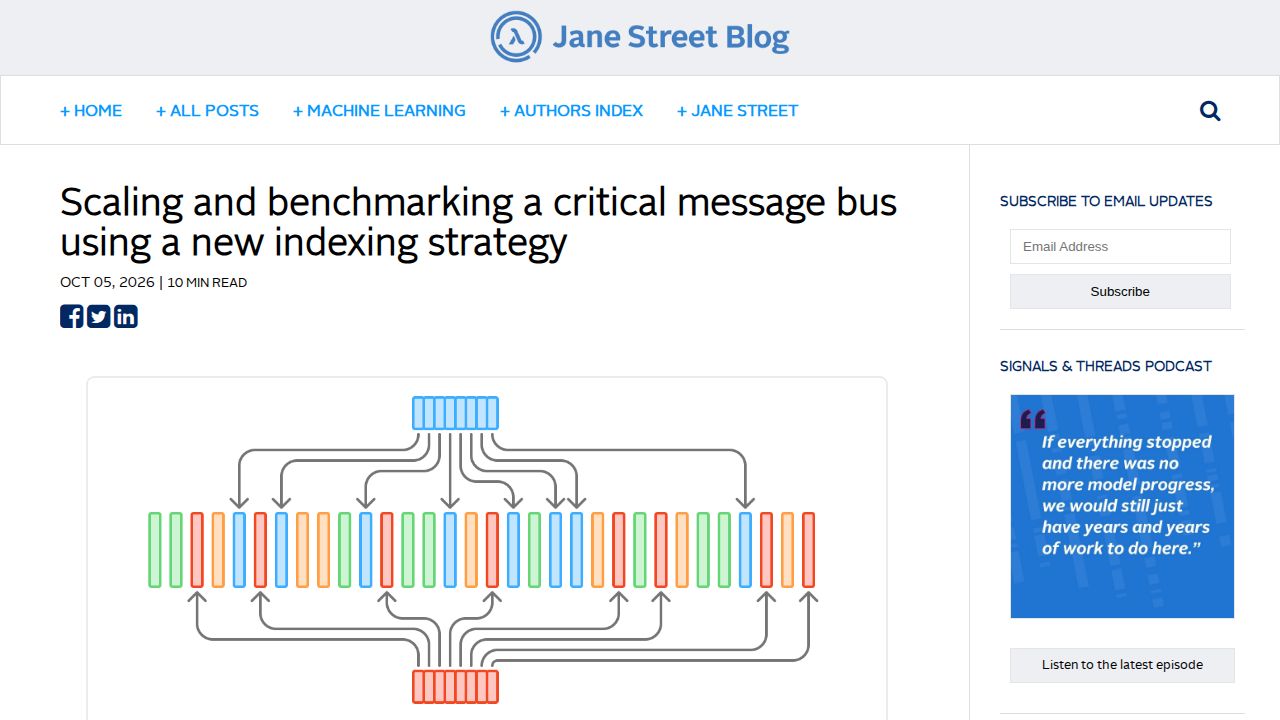
El framework interno de mensajería de Jane Street, Aria, procesa varios terabytes de datos por día, proporcionando flujos de mensajes en tiempo real a clientes suscritos. A medida que crecía el uso de Aria, el sistema encontró cuellos de botella de rendimiento durante dos procesos de recuperación: la recuperación de punta, donde los clientes que se quedan atrás solicitan mensajes recientes desde un buffer en memoria tipo anillo, y la recuperación inicial, donde los clientes reiniciados solicitan mensajes históricos desde el comienzo de la semana. Estas operaciones se sobrecargaron con el aumento de la carga, lo que motivó al pasante de verano Theodor Totev a investigar formas de hacer más eficiente el filtrado de mensajes.
Para acelerar la recuperación de punta, Totev reemplazó el escaneo lineal ingenuo de todo el flujo por un índice para cada partición de temas—a un grupo de temas que comparten el mismo prefijo de dos segmentos (por ejemplo, todos los temas bajo 'app/codestore'). Cuando un cliente solicita mensajes, Aria realiza una fusión n‑way de los índices de partición relevantes utilizando un min‑heap para reconstruir únicamente el flujo de mensajes necesario en orden. Las pruebas de referencia mostraron que reemplazar la implementación estándar de heap por una versión fast_heap_unboxed duplicó el rendimiento del código de recuperación indexado, contribuyendo a una caída observada del 30% en el uso de CPU en cargas de trabajo productivas, mientras se preservaban los estrictos requisitos de corrección del sistema.
Para la recuperación inicial, Totev abordó una ineficiencia diferente: el almacenamiento en disco de Aria dividía originalmente los segmentos de mensajes en almacenes de subárboles utilizando una heurística simple basada en los primeros tres segmentos del nombre del tema, lo que podía colocar un tema de alto volumen junto con temas de bajo volumen. Esto obligaba a los clientes que leen un tema pequeño a filtrar grandes cantidades de datos irrelevantes, a veces leyendo hasta diez veces más bytes de los necesarios. Al analizar los volúmenes reales de mensajes por tema, Totev ideó un algoritmo de división adaptativa que combina un enfoque de clustering voraz con búsqueda binaria. El algoritmo asigna su propio almacén de subárboles a los temas con grandes volúmenes de mensajes mientras agrupa los temas más pequeños en almacenes compartidos, minimizando así los bytes desperdiciados durante las lecturas específicas de temas.