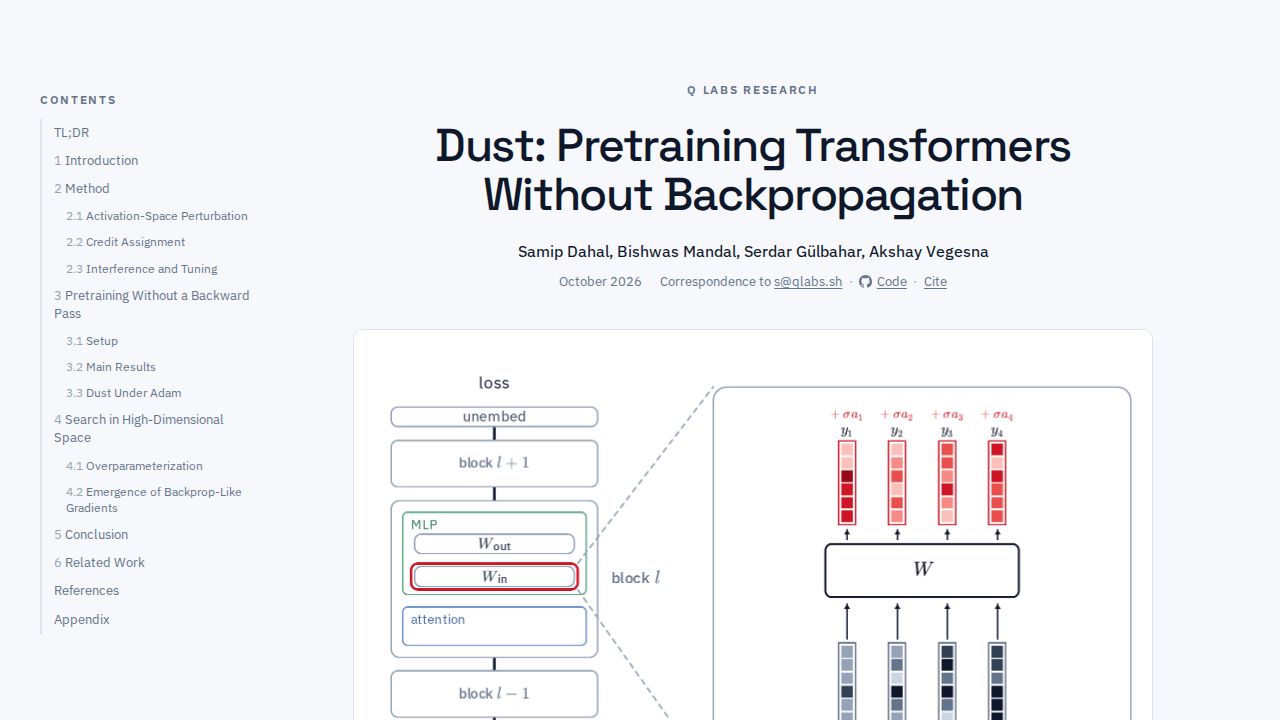
Dust representa una salida fundamental de los métodos estándar de entrenamiento de redes neuronales. A diferencia de la backpropagation, que requiere cálculos diferenciables y calcula gradientes de primer orden mediante la regla de la cadena, Dust es un método de optimización de orden cero que estima los gradientes perturbiendo directamente las activaciones y midiendo los cambios en la loss. Tal como se describe en la fuente primaria, el método añade ruido gaussiano a la salida de cada capa lineal de forma independiente en cada token, ejecuta una forward pass y recompensa el ruido de cada token según el cambio de loss en ese token. Este enfoque crea lo que los investigadores denominan una 'población virtual' donde cada token se convierte en un miembro de la población, permitiendo que una sola forward pass evalúe muchas perturbaciones en paralelo en lugar de requerir pasadas separadas para cada perturbación como lo hacen las estrategias de evolución tradicionales que operan en el weight space.
La ventaja central de eficiencia de Dust proviene de su enfoque de perturbación en el espacio de activaciones. Al perturbar las activaciones en lugar de los pesos, Dust evita la necesidad de materializar cada miembro de la población en el weight space, lo que lo hace órdenes de magnitud más eficiente que las estrategias de evolución en el weight space como EGGROLL. Según la fuente primaria, Dust es del orden de 10^3 a 10^4 veces más eficiente que una implementación de transformer de EGGROLL, una estrategia de evolución de última generación, basada en extrapolaciones a partir de 1M tokens hacia arriba. Esta ganancia de eficiencia proviene de evaluar las perturbaciones en paralelo entre los tokens en lugar de secuencialmente entre los miembros de la población, con una sola forward pass que evalúa una población al menos tres órdenes de magnitud mayor que el ES de weight space en transformers modernos.
Los resultados empíricos demuestran la competitividad de Dust frente a los métodos de optimización establecidos. La fuente primaria informa que Dust se aproxima estrechamente a backprop en tamaños de población grandes y en múltiples configuraciones incluso lo supera, lo que sugiere ventajas potenciales en regímenes ricos en cómputo. Contrario a la sabiduría convencional de que los modelos mayores son menos eficientes en población, los investigadores descubrieron que los modelos mayores son en realidad más eficientes en población con Dust: un modelo de 243M parámetros supera a un modelo 120× más pequeño en la mayoría de los tamaños de población. Además, las estimaciones de gradiente de Dust se alinean mejor con las de backprop a medida que crece la población, manteniendo una buena alineación en todas las escalas probadas hasta 1B tokens, lo que los investigadores consideran alentador para escalar el enfoque a modelos mayores y entrenamientos más largos.