El plugin Terse para Claude Code está diseñado para contrarrestar la tendencia del asistente a ofrecer respuestas estilo ensayo cargadas de relleno como esloganes, metáforas y frases autorreferenciales. Su página de GitHub explica que el plugin proporciona un conjunto de 22 reglas de escritura y 18 pares antes/after (un total de 877 palabras) que reformulan cada respuesta en un formato estricto: una sola frase con la respuesta, seguida opcionalmente por una lista o tabla, luego a lo sumo una frase de advertencia y luego se detiene. Este estilo elimina las referencias en primera persona, los esloganes, las metáforas y las reformulaciones de tipo 'X, no Y', reduciendo así la verbosidad que muchos usuarios encuentran distractiva.
Esta imagen muestra el objetivo declarado del plugin según su página de GitHub, que motiva las reglas estrictas de escritura que reducen la verbosidad.
Las mediciones suministradas con el plugin muestran que para Opus 5.5 (esfuerzo alto) la longitud mediana de la respuesta pasa de 636 palabras a 181 palabras (−72%) en diez respuestas de chat, mientras que los tokens de salida caen un 45% y las violaciones de estilo por cada 1.000 palabras disminuyen de 11,1 a 1,1 (−90%). Las reducciones específicas incluyen que los esloganes y metáforas lleguen a cero por cada 1.000 palabras, las referencias en primera persona caigan un 83% y las reformulaciones 'X, no Y' disminuyan un 33%. Se reportan ganancias similares para Fable 5.1, con un 46% menos de palabras y un 51% menos de costo.
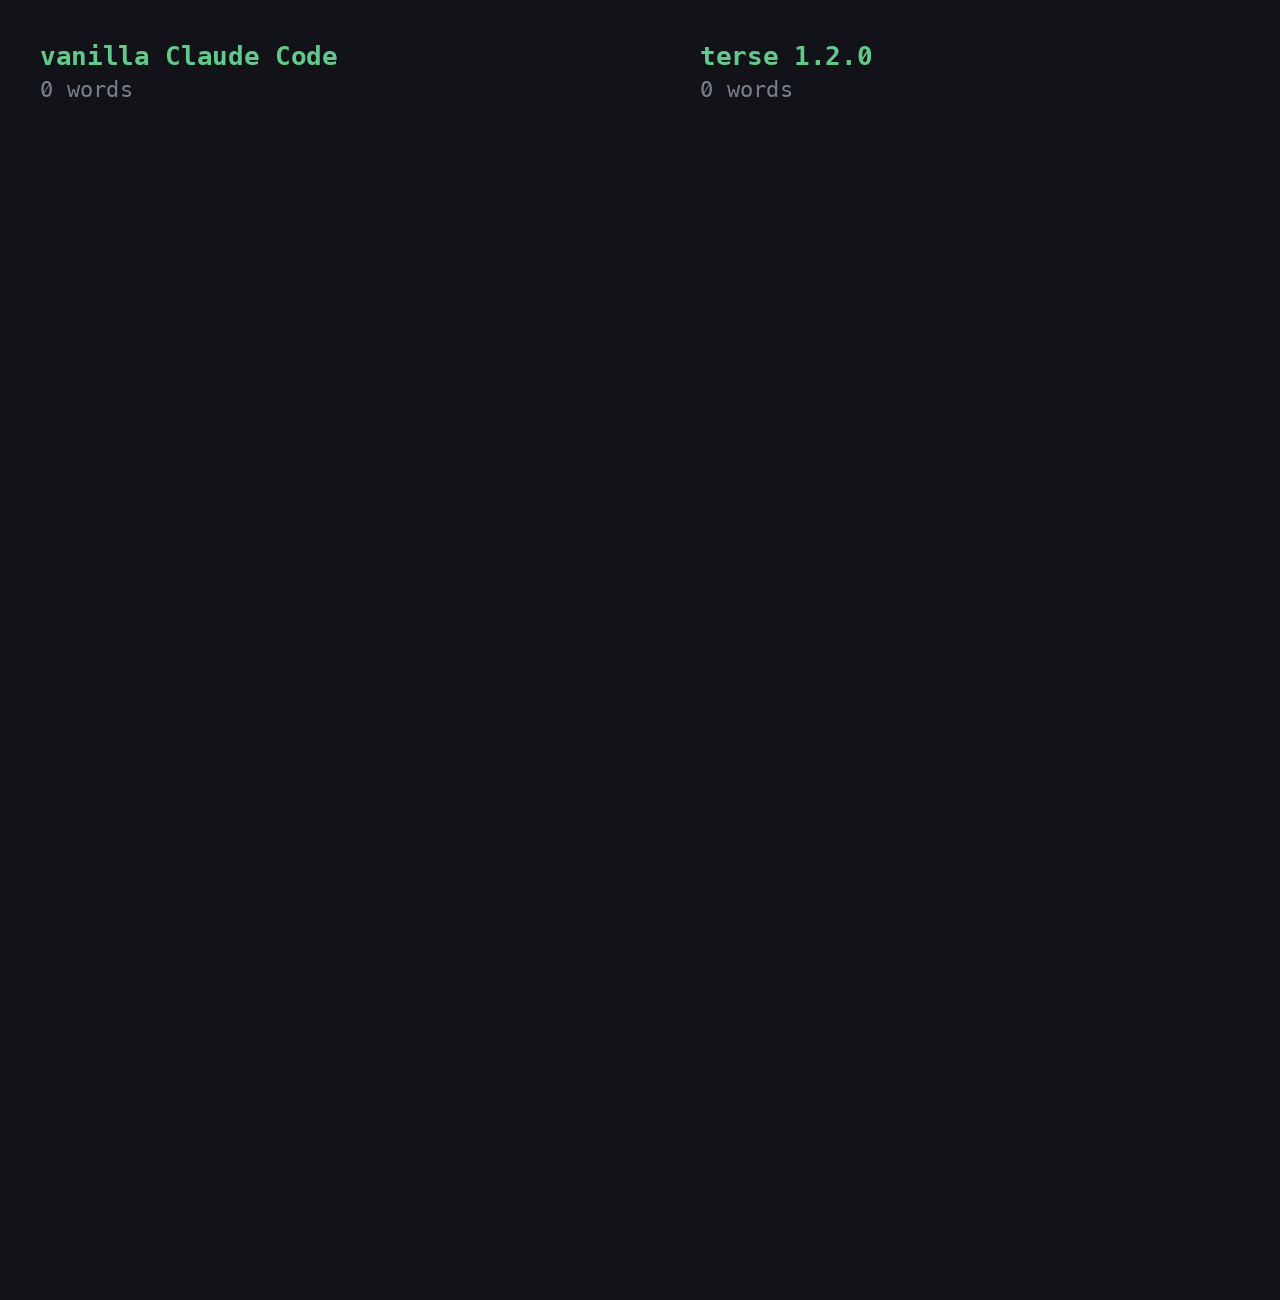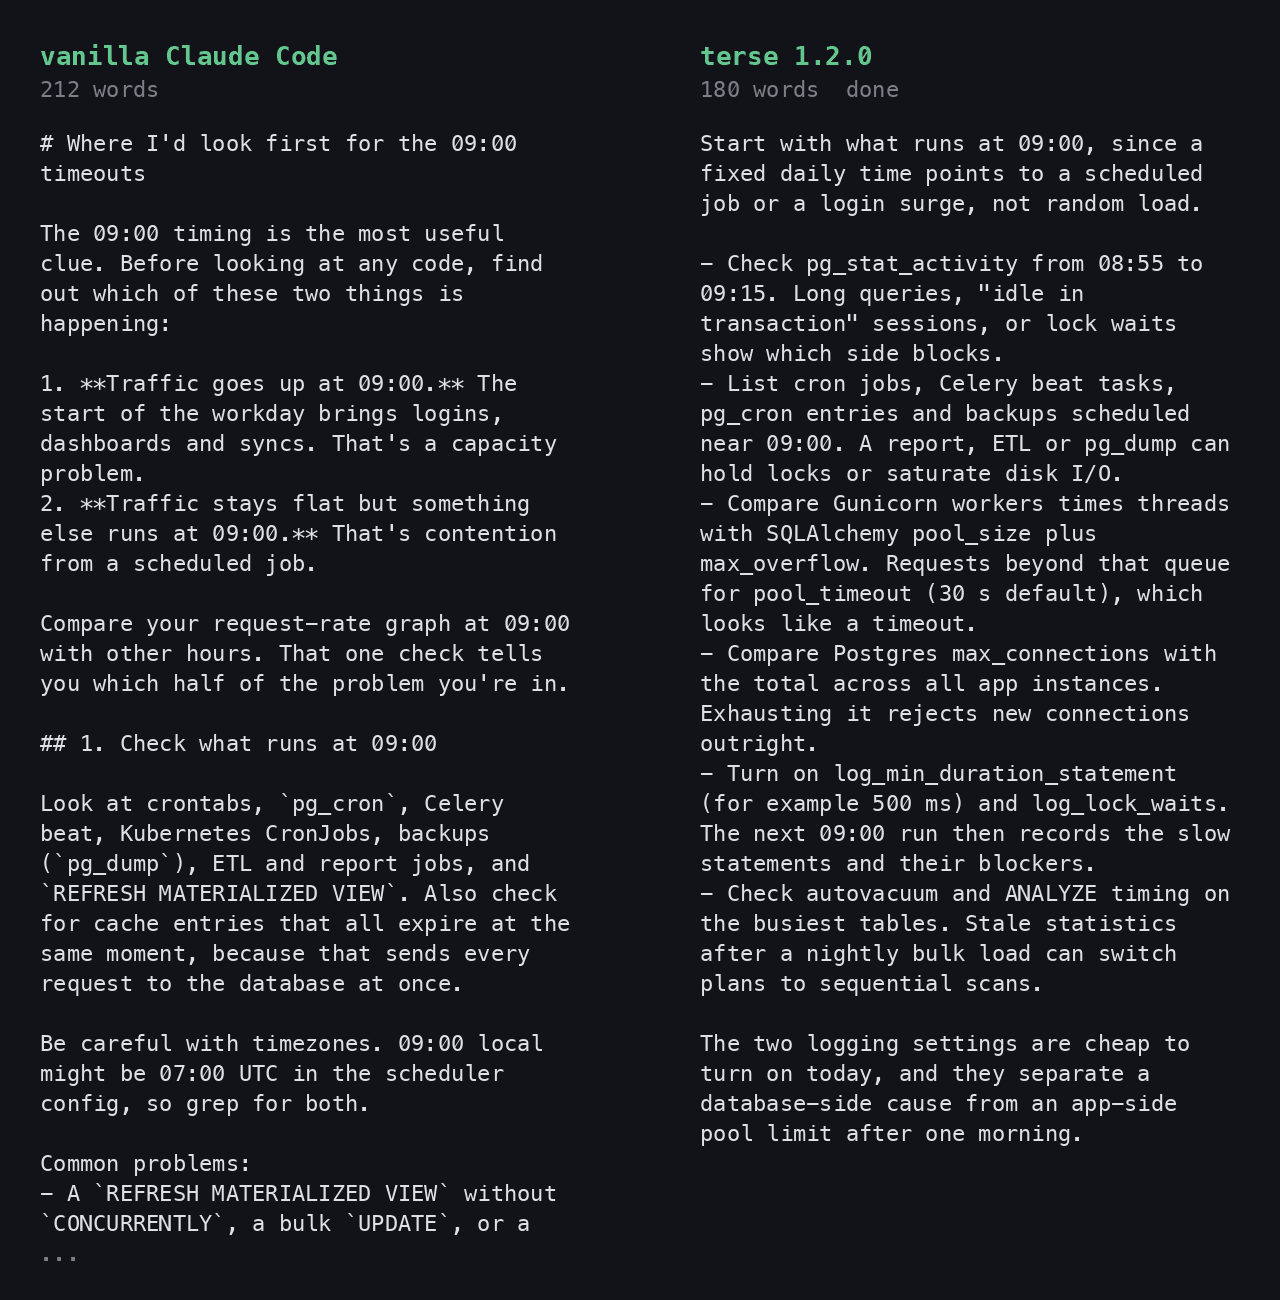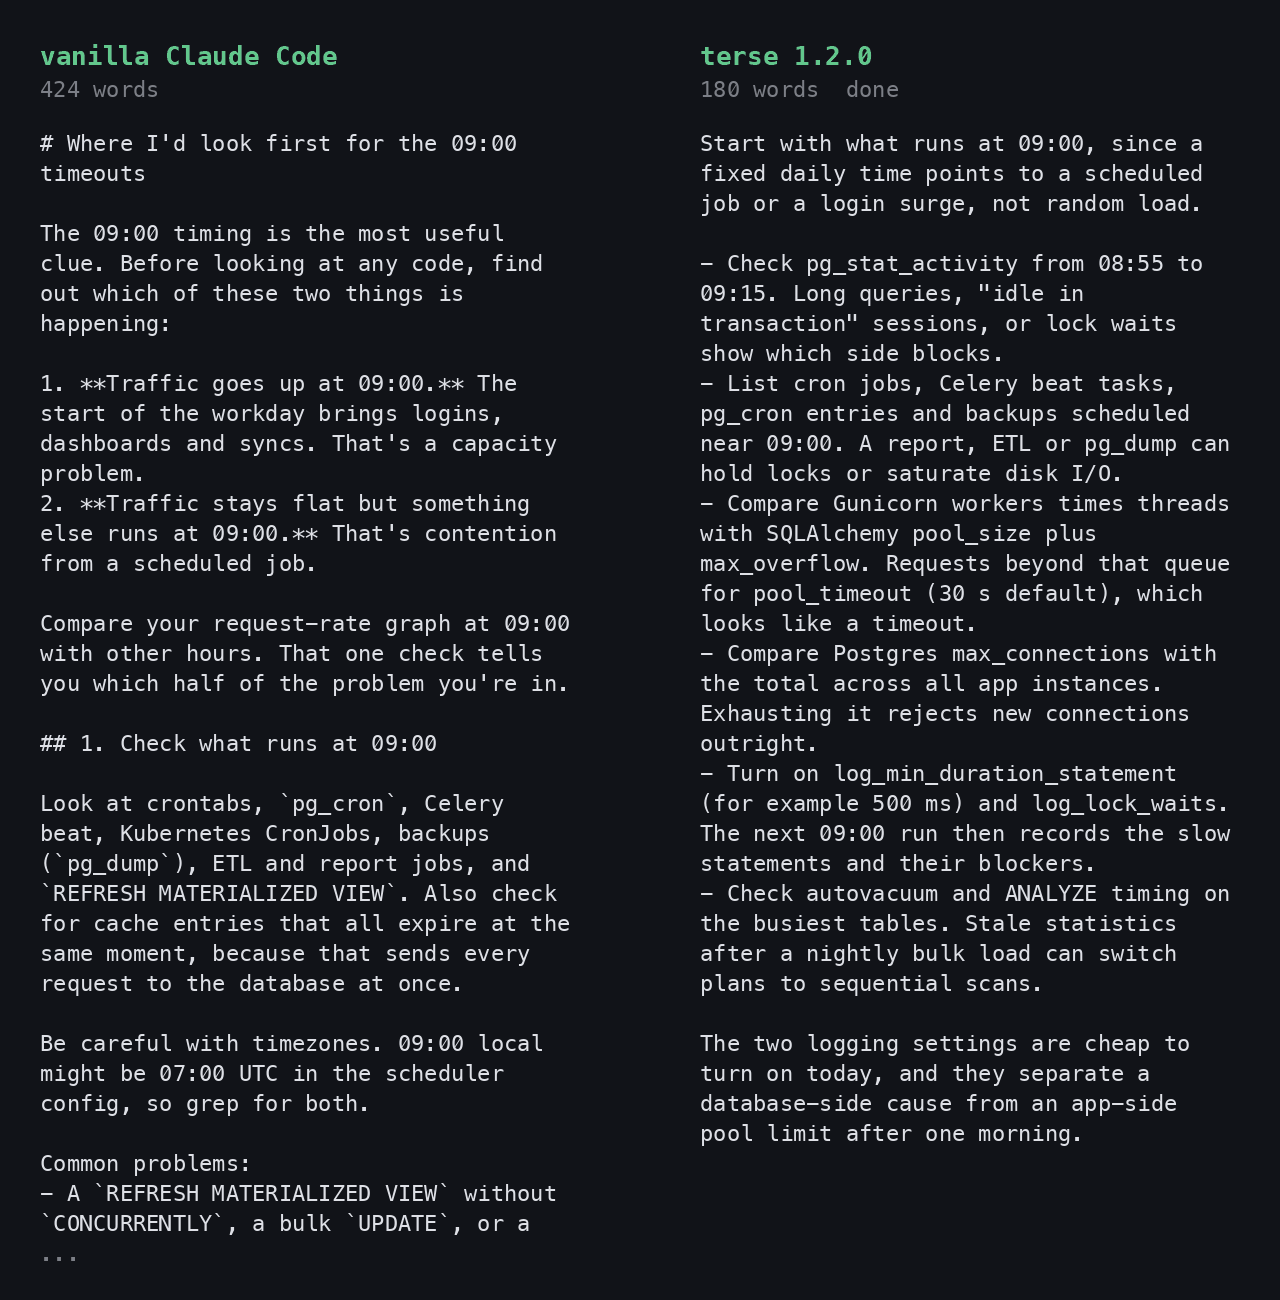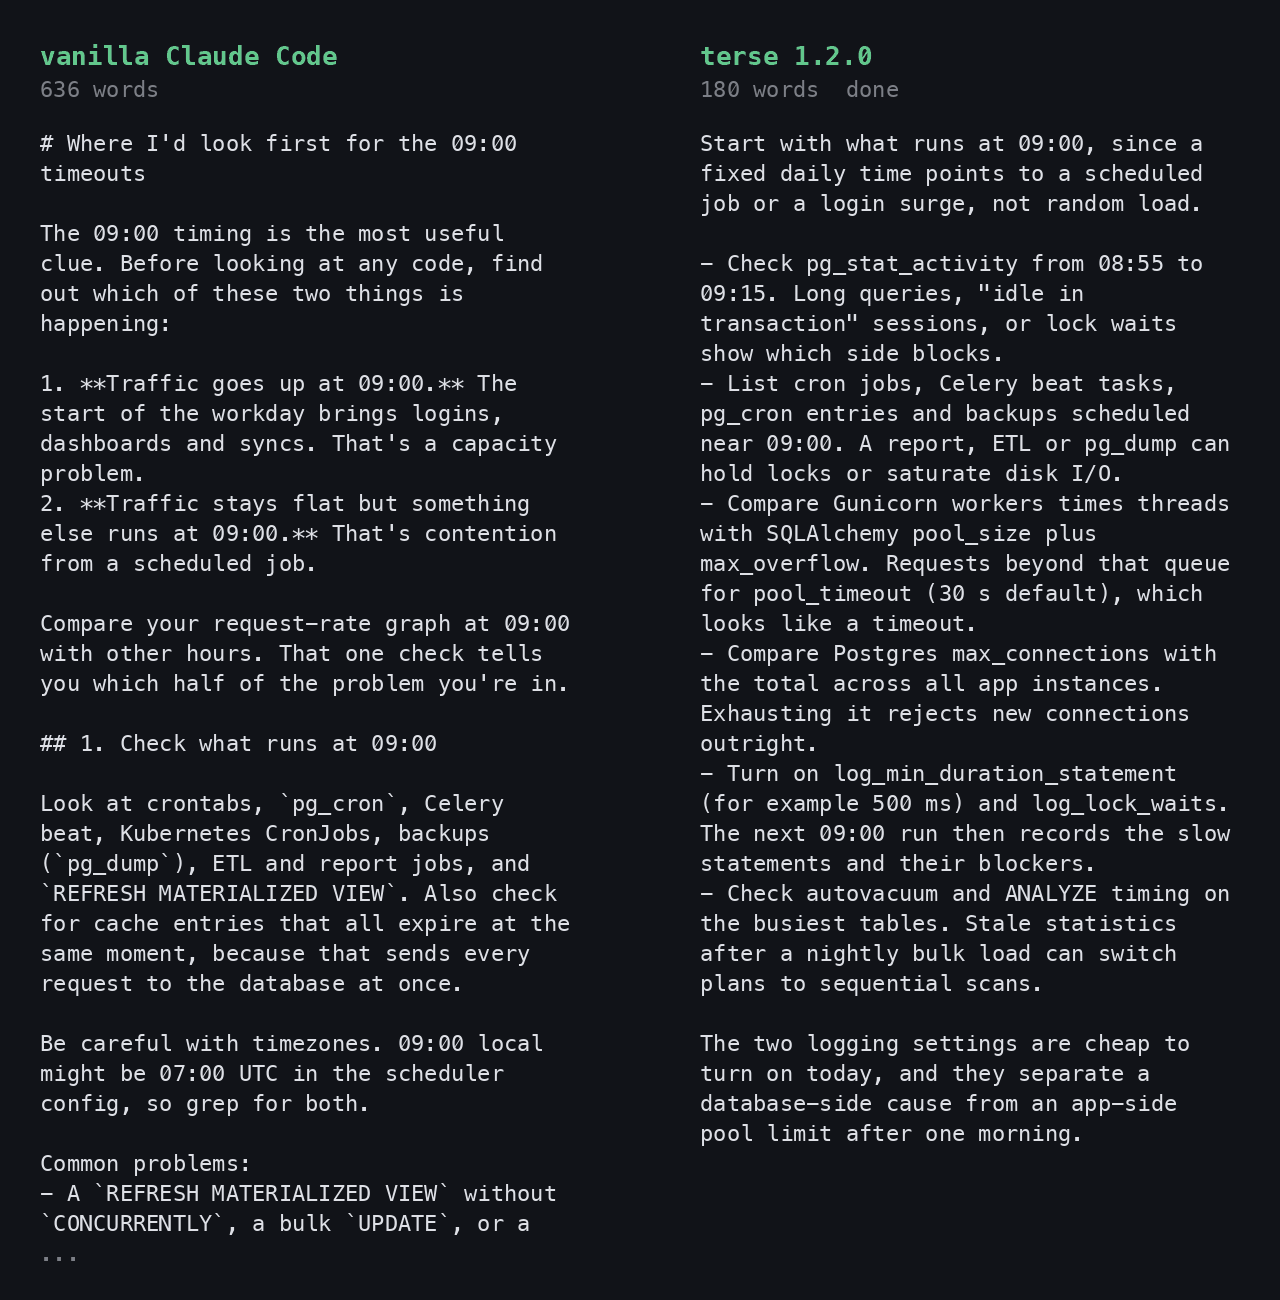
Esta imagen ilustra la reducción cuantitativa de la longitud de la respuesta descrita en la sección de mediciones, donde la longitud mediana de la respuesta disminuye de 636 a 181 palabras para Opus 5.5.
Además de reescribir las respuestas, Terse incorpora un medidor de contexto que muestra el nombre del modelo y el porcentaje de llenado del contexto en la línea de estado. Los umbrales del medidor—verde por debajo del 37%, amarillo desde el 37%, naranja desde el 49% y calavera desde el 60%—se derivan de estudios que indican que la calidad de recuperación se degrada mucho antes de que se llene la ventana de contexto, como el informe de Context Rot de Chroma (degradación desde 50k tokens en una ventana de 200k), NoLiMa (11 de 13 modelos a la mitad de la línea base a 32k tokens) y el fenómeno de Lost in the Middle.