Strata lleva un modelo de lenguaje de 125 mil millones de parámetros al escritorio. El modelo es Qwen3.8-Flash-Next, lanzado por el equipo Qwen como una vista previa experimental de la arquitectura sobre la que se apoyará la próxima generación Qwen4. Strata, un motor de inferencia de código abierto bajo la licencia MIT, lo ejecuta en hardware de consumo — una PC para jugar con una tarjeta gráfica reciente de NVIDIA o AMD — a velocidades de alrededor de 100 tokens por segundo en tarjetas de 24 gigabytes, sin que nada salga de la máquina local.
El párrafo de apertura presenta a Strata como el motor de código abierto que lleva el modelo de 125 mil millones de parámetros a una PC para jugar de escritorio.
El modelo es grande pero inusual. Tiene 125 mil millones de parámetros en total, pero solo se activan unos 6 mil millones para cada token. Es un modelo de mezcla de expertos: 512 expertos por capa a lo largo de sus 48 capas, unos 24.576 especialistas en total, de los cuales se eligen 10 expertos enrutados más un experto compartido para cada palabra. El resto permanece inerte. Es esto lo que hace que un modelo de 125B se comporte más como un modelo de 6B por paso — y lo que hace que sea posible ejecutarlo en una PC en absoluto.
Más allá del enrutamiento de expertos, el modelo introduce varios cambios arquitectónicos que el equipo Qwen dice estar orientados a la eficiencia a gran escala. Qwen Sparse Attention (QSA) procesa el texto en microbloques en lugar de tokens individuales, reduciendo la latencia en contextos largos. Gated Residual modula la información que fluye a través de corrientes residuales más anchas mediante puertas de lectura y escritura dependientes de datos. Una gran tabla de incrustaciones n-gram — equivalente a 51 mil millones de parámetros, indexada por secuencias de palabras cortas — escala el conteo de parámetros con menos cómputo que una incrustación estándar. Su longitud nativa de contexto es de 262.144 tokens, extensible a un millón.
El trabajo de Strata es hacer que todo esto encaje en una máquina construida para jugar. El README usa una analogía de cocina: los expertos que usas constantemente permanecen en la encimera, y el resto espera en la despensa. Concretamente, la GPU conserva los pocos miles de expertos accedidos con más frecuencia; la RAM del sistema contiene a todos; el procesador trabaja con los expertos restantes mientras la GPU funciona; y un SSD contiene una gran tabla de búsqueda. El instalador elige una versión cuantizada del modelo — de 2 a 4 bits por peso — porque el modelo completo no cabe en 12 a 24 gigabytes de memoria de video.
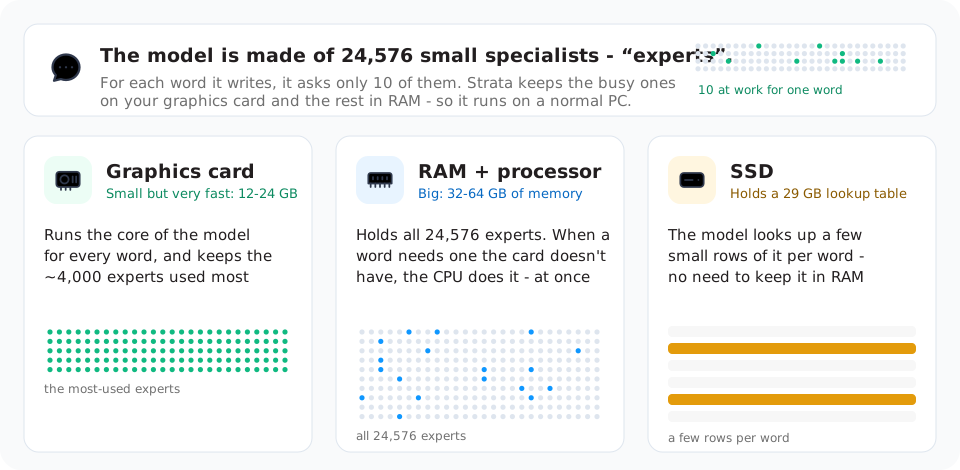
El cuarto párrafo explica la analogía de la cocina y la división concreta de expertos entre GPU, RAM y SSD que hace que el modelo de 125B quepa en una máquina para jugar.
Un segundo truco acelera las respuestas. Un pequeño modelo auxiliar adivina las siguientes palabras, y el modelo grande las comprueba todas a la vez, manteniendo las correctas. El README llama a esto adivinar, luego verificar y dice que produce la misma respuesta de 1,6 a 1,8 veces más pronto. Los prompts largos se leen en trozos de hasta 8.192 tokens a la vez, a más de 1.000 tokens por segundo, así que un documento de 32.000 tokens tarda aproximadamente un minuto en procesarse.
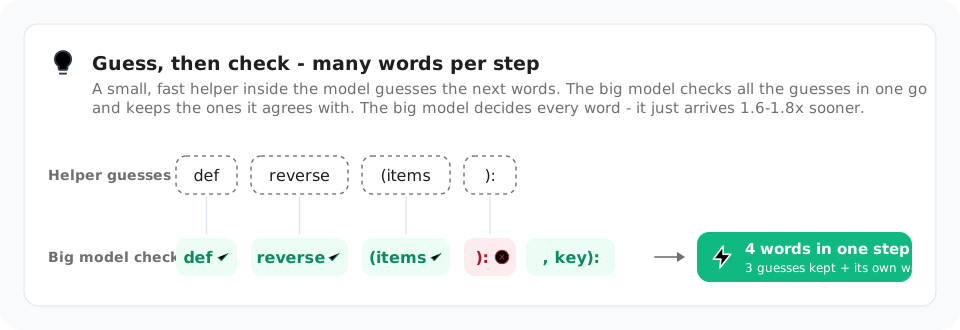
El quinto párrafo describe el truco de adivinar-luego-verificar que acelera las respuestas y la afirmación del README sobre cuánto antes produce la misma respuesta.
Las benchmarks publicadas provienen de dos PCs para jugar ordinarias, no de la RTX 4090 del titular. En una NVIDIA RTX 5070 con 12 GB de VRAM, 64 GB de RAM y un Ryzen 5 7600, el motor escribe respuestas a 94 tokens por segundo con el quant Q2_0 más agresivamente comprimido, bajando a 53 tokens por segundo con el quant IQ3_S más grande. La lectura de un prompt de 32.000 tokens fue entre 1.620 y 2.650 tokens por segundo en la misma máquina. En una AMD RX 9070 XT con 16 GB, los mismos quants escribieron 60 y 52 tokens por segundo respectivamente. El README señala que una tarjeta con más VRAM es más rápida, y estima que una RTX 3090 con 24 GB escribe aproximadamente de 100 a 140 tokens por segundo — el rango que el titular menciona. Un token equivale más o menos a tres cuartos de una palabra, así que 100 tokens por segundo supera con creces la velocidad de lectura.
El intercambio es calidad, y el README es sincero al respecto. Los archivos cuantizados más pequeños y rápidos son un poco más inteligentes a tamaños más grande, y el instalador recomienda quants distintos según cuánta RAM tenga una máquina. La variante Coder elimina la mitad de los expertos, alcanza el 91% del puntaje SWE-bench Verified del modelo completo según sus autores, y cabe en 32 GB de RAM — pero es más débil fuera del código, incluyendo texto chino y otro CJK. También hay fine-tunes de la comunidad: una versión Swift 1.5 que piensa menos tiempo antes de responder, y las versiones de Unsloth de aproximadamente 4 bits que se sitúan entre los quants recomendados en calidad, con la variante más cercana al completo escribiendo solo de 7 a 8,5 tokens por segundo en una PC de 64 GB porque se lee en gran parte del SSD. Las puntuaciones de benchmark publicadas del modelo, listadas en su página de Hugging Face, son las propias mediciones del equipo Qwen a precisión completa — un punto de referencia para lo que puede hacer el modelo sin comprimir, no una garantía sobre cualquier copia cuantizada en particular.
Ejecutarlo es sencillo. El instalador pregunta qué tamaño de modelo usar, cuánto contexto conservar y si el modelo debe leer imágenes, luego descarga aproximadamente 70 gigabytes y arranca el motor. En un navegador en localhost:8080 hay una interfaz de chat y un monitor en tiempo real del modelo y del uso de GPU, CPU y RAM de la máquina. Las aplicaciones que usan una API compatible con OpenAI pueden apuntar a http://127.0.0.1:8080/v1; las aplicaciones que usan la API de Anthropic pueden usar el endpoint messages, que permite a herramientas como Claude Code enrutar solicitudes a través del modelo local. El motor también expone una Responses API para aplicaciones construidas sobre la nueva interfaz de OpenAI.
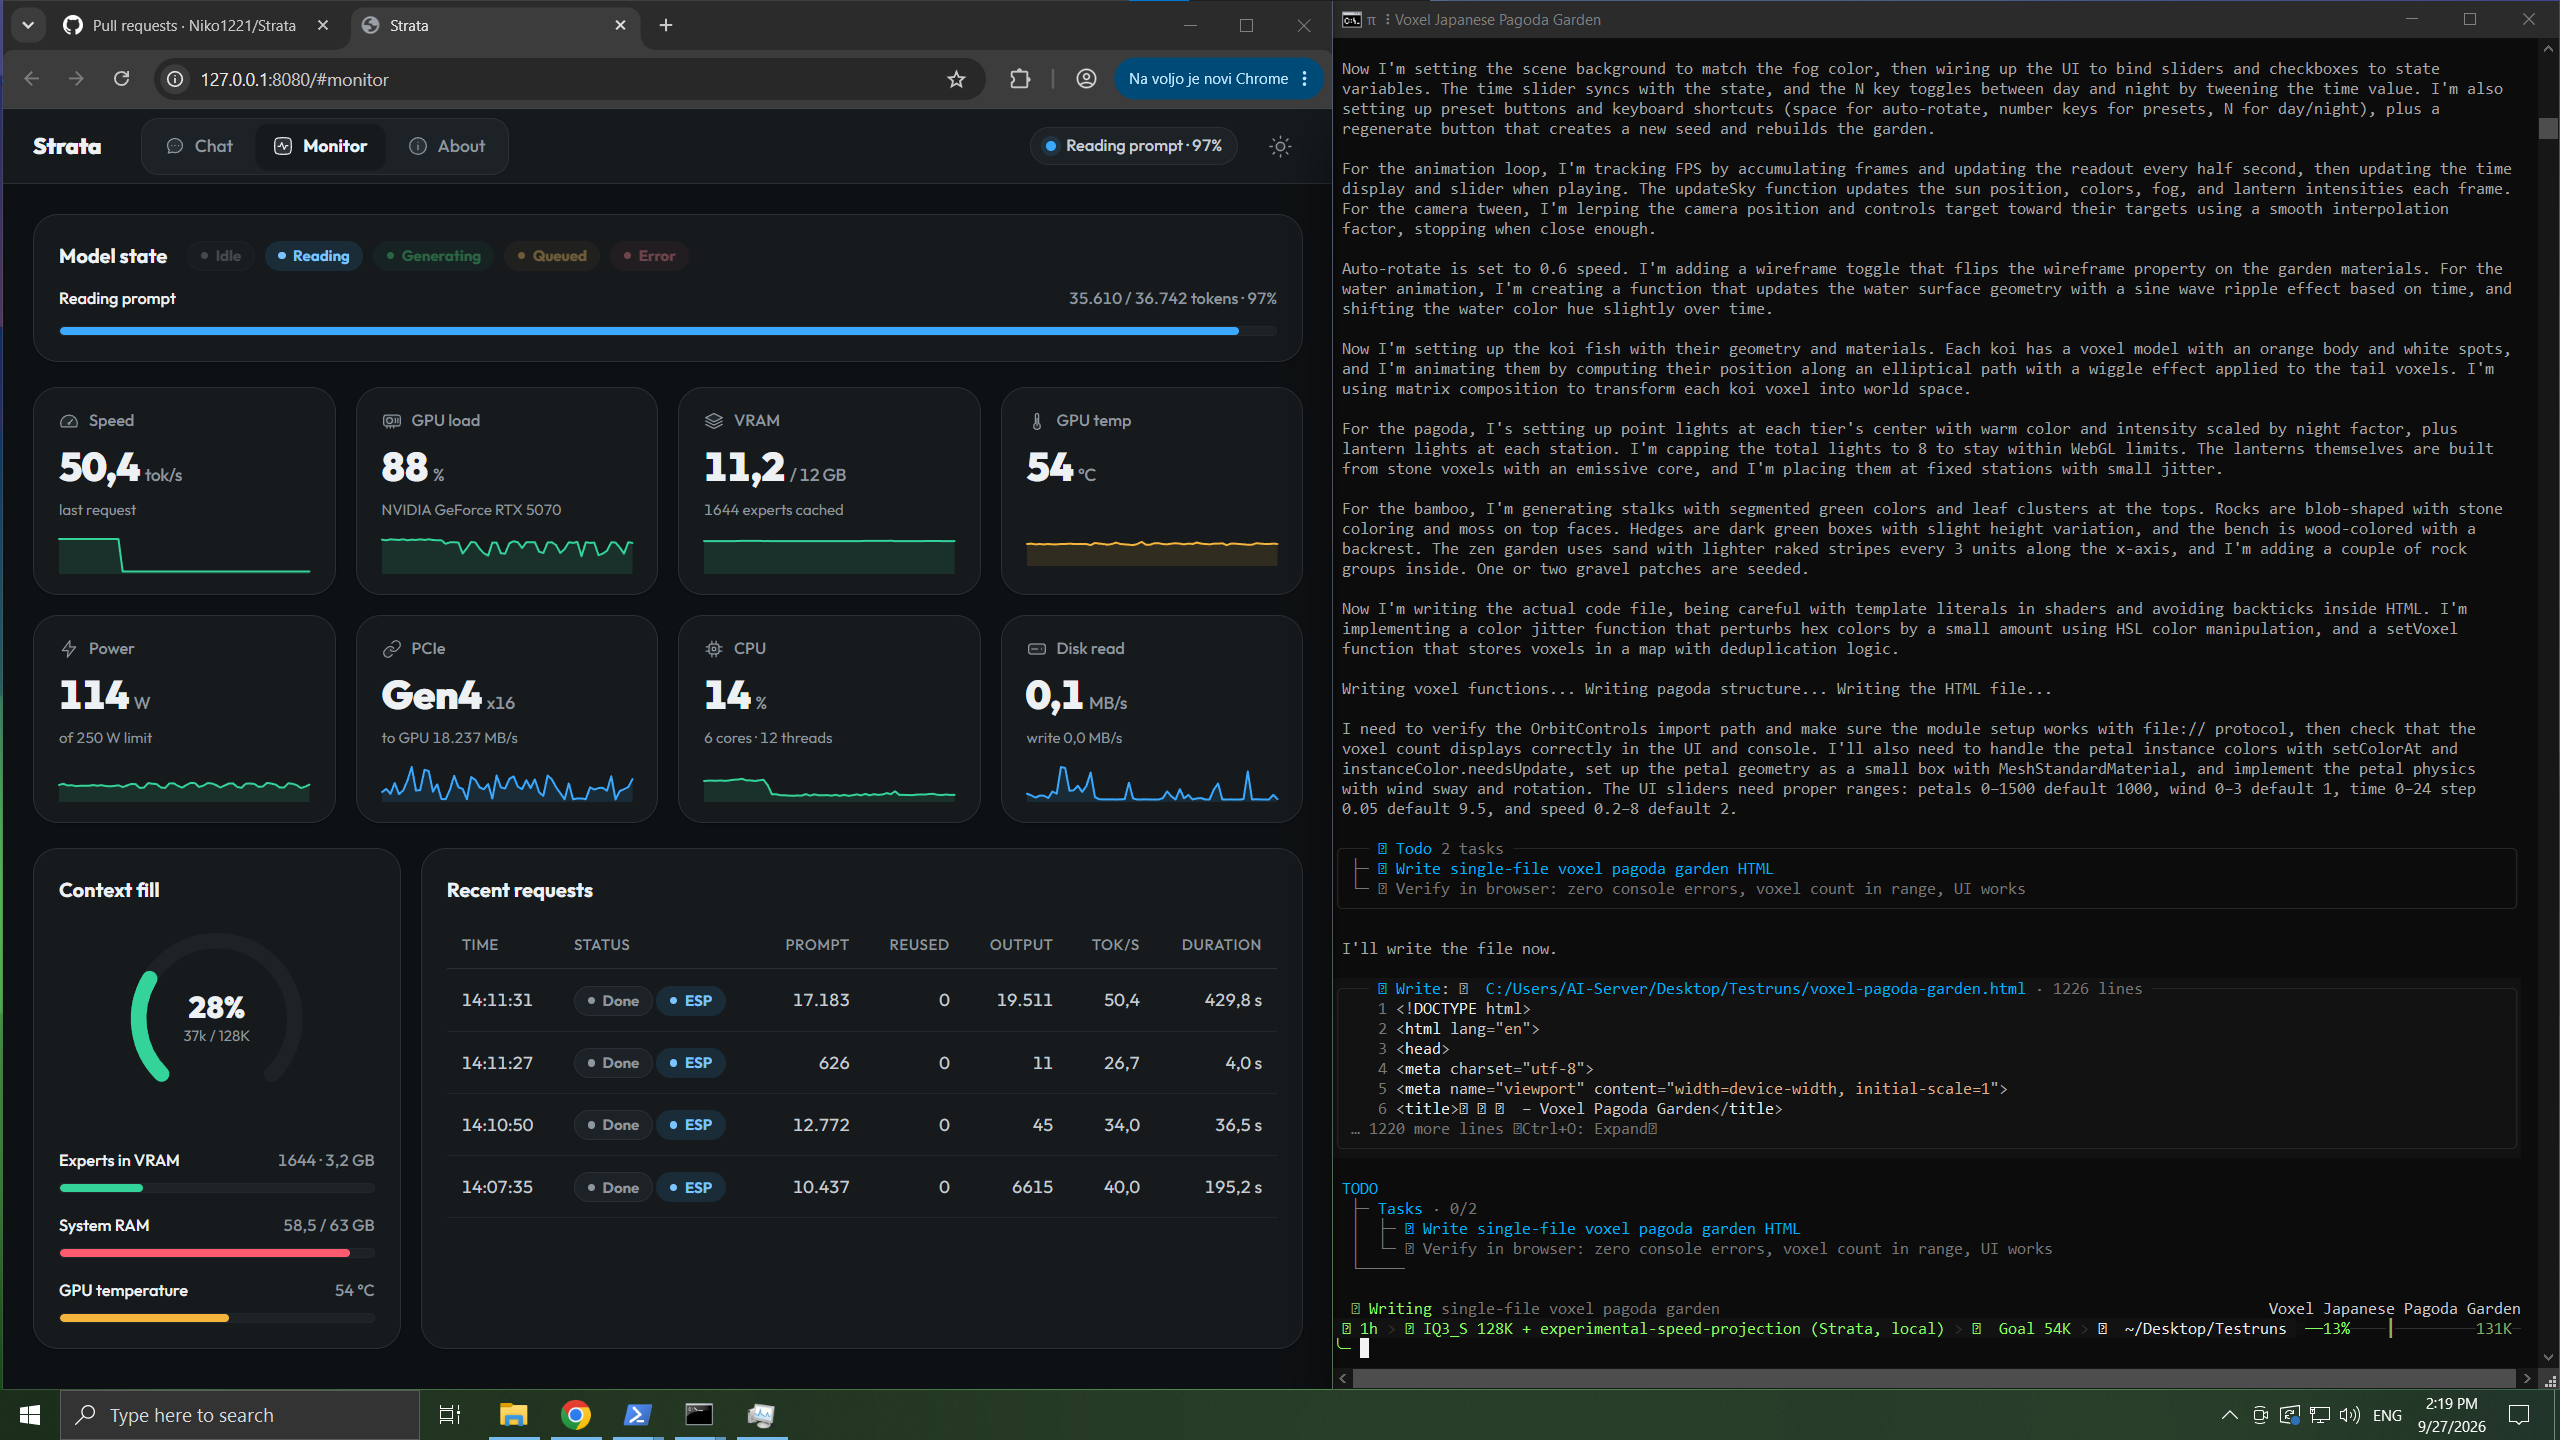
El octavo párrafo describe la interfaz de chat del navegador en localhost:8080 y su monitor en tiempo real del modelo y del uso de GPU, CPU y RAM de la máquina.
Parte del atractivo es que un modelo de 125B que antes necesitaba una granja de servidores puede ahora ejecutarse en un escritorio, sin que los datos vayan a un proveedor remoto. Para desarrolladores y aficionados que quieren un modelo local potencial para codificación, escritura o tareas agentic — y que pueden estar sensibles sobre enviar código o documentos a un servicio en la nube — eso es un cambio significativo.
Las advertencias importan. Strata es experimental, y el README advierte que el primer arranque puede congelar la máquina de uno a tres minutos mientras el modelo se carga en RAM, lo cual es normal. El motor responde una solicitud a la vez por defecto, aunque se puede configurar para varios flujos concurrentes. La entrada de imágenes funciona en la mayoría de configuraciones, pero las tarjetas AMD solo pueden leer imágenes en Linux, no en Windows, por ahora. Las cifras de velocidad provienen de una versión específica del motor en hardware específico — la mayoría de las filas de las tablas publicadas usaron el motor 0.1.26, con la fila Q2_0 más rápida en 0.1.36 — y los números del mundo real variarán con la tarjeta, el tamaño del quant y el prompt.
Lo que queda incierto es hasta qué punto las cuantizaciones de menor bits resisten en la práctica, y si el aproximadamente 100 tokens por segundo del titular en una RTX 4090 coincide con la propia estimación del motor para una tarjeta de 24 GB comparable. La cifra de la RTX 3090 es una estimación, no un benchmark, y las tablas publicadas provienen de tarjetas distintas. Se necesitaría una prueba independiente en la configuración exacta para confirmar el número.