En septiembre de 2026, el equipo detrás de Wagtail CMS —un sistema de gestión de contenidos basado en Python— se embarcó en un experimento que llamaron su 'desafío de solo modelos abiertos: vuelta al colegio'. El objetivo era engañosamente simple: pasar todo el mes de septiembre programando con un solo nivel de modelo abierto eficiente, específicamente GLM 5.3 Flash. Como explica el equipo, 'Establecer el reto de pasar todo septiembre en un solo modelo abierto eficiente pareció una gran idea en ese momento'.
El modelo elegido fue GLM 5.3 Flash, un nivel de modelos de IA de código abierto eficientes. Según el blog de Wagtail, GLM 5.3 Flash cuenta con una ventana de contexto de 1M, lo que permite tareas de programación extendidas y razonamiento complejo. También ofrece soporte de visión, lo que significa que puede trabajar con capturas de pantalla o QA visual. El modelo está disponible a través de una amplia gama de proveedores, beneficiándose de una competencia saludable. Estas fortalezas técnicas lo hicieron muy adecuado para el desafío que el equipo se propuso.
¿Qué salió bien durante el mes? El equipo logró pasar la primera mitad de septiembre utilizando únicamente GLM 5.3 Flash. El uso de ese modelo se mantuvo muy dentro del presupuesto: aproximadamente $68 en costos, unos 4 kWh de uso de energía y 365 gramos de emisiones de carbono. Para poner esto en perspectiva, el equipo señala que este uso de energía es equivalente a conducir un vehículo eléctrico unas 15 millas o hervir 10 galones de agua. El propio GLM 5.3 Flash demostró ser excelente para las tareas que el equipo necesitaba: construir sitios con Wagtail mismo, tareas de UI, trabajo de investigación y desarrollo de IA, redacción de documentación y evaluación de código. La versatilidad del modelo lo hizo 'realmente polivalente' para su flujo de trabajo.
Sin embargo, la segunda mitad del mes no salió como se planeó. Alrededor de 1B de tokens se destinaron a otros modelos, elevando el uso total de tokens a 2B en lugar del objetivo de 1B. Se acumularon unos 35 kWh de uso de energía en lugar de los 10 kWh esperados. El equipo identificó varios obstáculos inesperados.
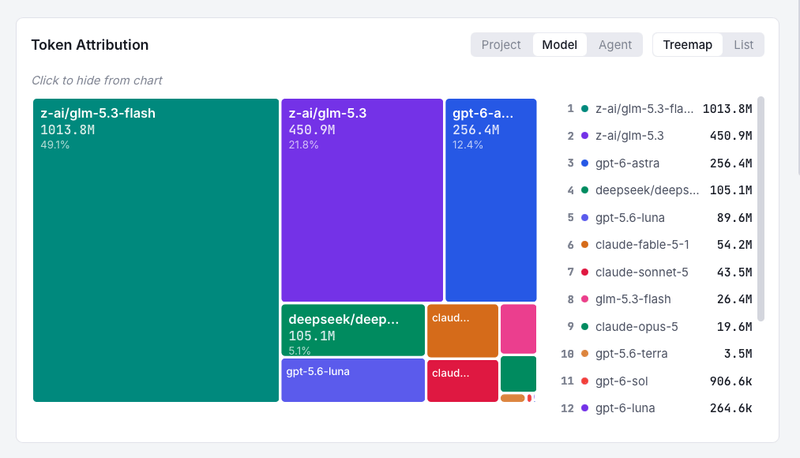
Representación visual del hallazgo clave del experimento: solo el 50% de los tokens se destinaron al modelo objetivo, con la mitad destinada a otros modelos
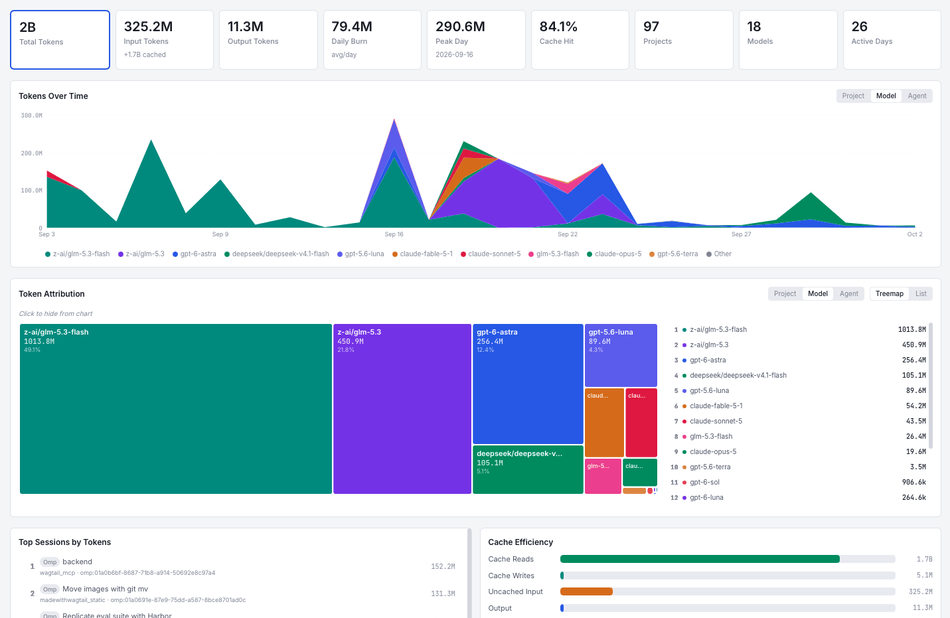
Captura de pantalla que muestra el consumo total de tokens que superó el objetivo de 1 mil millones, ilustrando la escala del exceso
Un problema significativo fue lo que el equipo llama 'el costo del vibe coding'. Su servidor MCP experimental de Wagtail —un prototipo de vibe-coding— estaba utilizando el modelo 'incorrecto' para el propósito del prototipo. Eligieron un modelo que resultó en el gasto de 450M de tokens / $150 / 5 kWh de uso de energía casi de la noche a la mañana. El equipo reconoce que este fue un error de prototipo: 'Podríamos haber logrado resultados similares por un costo probablemente 5 veces menor con no mucho más esfuerzo'. La lección: tener cuidado con la selección de modelos y los patrones agénticos. Necesitaban presupuestar esto y ser más cuidadosos; podrían haberlo previsto, pero ahora ya lo saben.
Otro obstáculo fue la disponibilidad de la infraestructura. El equipo había escrito extensamente sobre la comparación de proveedores de inferencia. Sus elecciones funcionan bien la mayor parte del tiempo, pero estos modelos son muy populares y no tienen la misma capacidad que los grandes laboratorios que acaparan todas las GPUs. Para su situación, con solo modelos abiertos confirmados como disponibles en un centro de datos europeo, la degradación del rendimiento con GLM 5.3 Flash probablemente se debió a que está 'tan alto en la frontera de Pareto de modelos relevantes para nuestro trabajo'. Cuando GLM 5.3 Flash tuvo un rendimiento inferior, el equipo tuvo que cambiar a otros modelos similares: DeepSeek V4.1 Flash y Qwen 3.8 Flash. Este cambio fue 'muy sencillo de hacer, pero no obstante inesperado'.
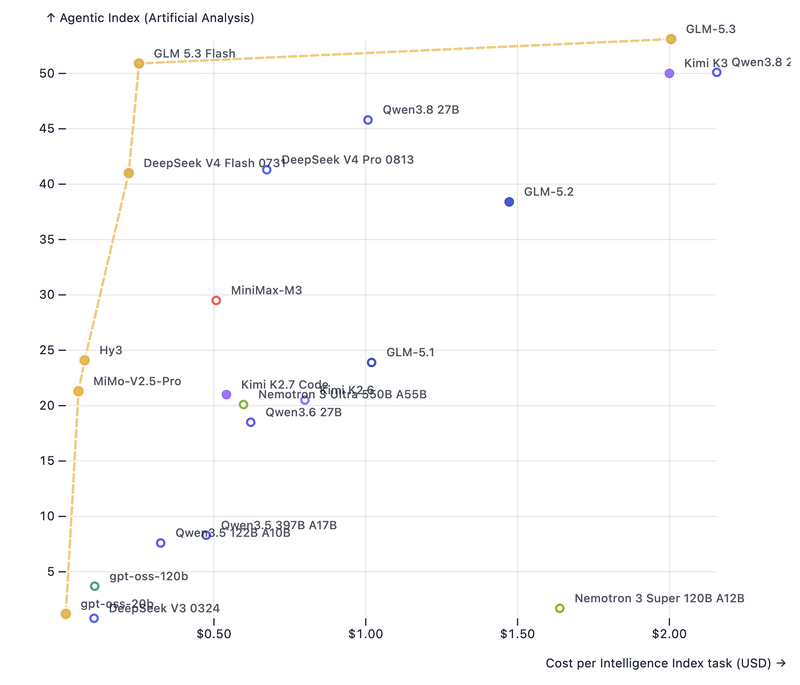
Ilustración gráfica del desafío de selección de modelos discutido en el artículo, donde modelos de alto rendimiento como GLM 5.3 Flash se sitúan en la frontera de Pareto
Más allá de usar un solo modelo para la ingeniería diaria, el equipo consideró esencial seguir experimentando con una amplia gama de modelos, manteniéndose al día con lo que los proveedores están lanzando. Esto es particularmente esencial a medida que comienzan a evaluar el rendimiento de los modelos en tareas de Wagtail, donde necesitan datos a través de una amplia gama de modelos. El equipo comparte un adelanto de su benchmark, señalando que es 'mucho más fácil guiar a las personas hacia opciones más ligeras con este tipo de datos concretos'.
Las conclusiones del equipo y lo que harán a continuación son directas. Técnicamente, el desafío fue un fracaso: solo el 50% del uso en el modelo objetivo, 1B de 2B de tokens. Alrededor de 35 kWh de uso de energía en lugar de 10. Pero aprendieron mucho, lo que el equipo considera crucial para el momento actual. Reflexionando sobre esto para octubre, esto es lo que hará que funcione:
- Medición y reporte constante y local. Mirar no solo los tokens sino también el uso de energía y el gasto, e idealmente qué tan bien esto conduce a resultados positivos concretos. - Presupuestar para la experimentación, no solo para las tareas diarias. Tomar decisiones más concertadas sobre qué prototipos vale la pena construir y cómo. - Mejor selección de prompts y técnicas multi-agente. Agentes orquestador vs. explorador vs. implementador vs. revisor. Objetivos delimitados. No es ciencia de cohetes pero ciertamente es una cosa más que aprender. - Seguir presionando por técnicas y modelos más eficientes. Los modelos de difusión de decisión estilo Jev parecen muy prometedores si pueden ejecutarse de manera tan eficiente. Los últimos modelos insignia también parecen un paso en la dirección correcta en ese frente.
Para el trabajo diario de los desarrolladores, el equipo concluye que es totalmente viable centrarse en uno o dos modelos baratos de nivel flash. Un objetivo viable es probablemente que la mayoría del trabajo de inferencia de IA deba realizarse con modelos tan eficientes, medidos en costo o uso de energía en lugar de tokens sin sentido. Ese es el objetivo para octubre; animan a otros a intentarlo también, ya que aprenderán mucho en el proceso. Estarán en Wagtail Space 2026 en noviembre para escuchar cómo resulta todo.
El experimento refleja un cambio significativo en la filosofía del desarrollo de IA. El equipo sostiene que la mayor parte del trabajo de inferencia de IA debería moverse hacia modelos eficientes, medidos en costo o energía en lugar de conteos de tokens sin sentido. La experiencia sugiere un nuevo paradigma: no reemplazar modelos potentes como Claude Opus, sino establecer modelos eficientes como el caballo de batalla para tareas rutinarias, reservando los modelos premium para desafíos complejos y novedosos.
Mirando hacia adelante, el equipo de Wagtail planea implementar estas lecciones en octubre, con el objetivo de lograr patrones de uso de IA más eficientes. Señalan que el momento actual representa una oportunidad crítica para establecer mejores prácticas antes de que estos modelos eficientes se vuelvan tan competitivos y demandados como los modelos de frontera que actualmente reemplazan. El experimento concluyó técnicamente como un fracaso parcial —solo el 50% del uso en el modelo objetivo— pero sirve como una experiencia de aprendizaje crucial para la comunidad más amplia de desarrollo de IA.