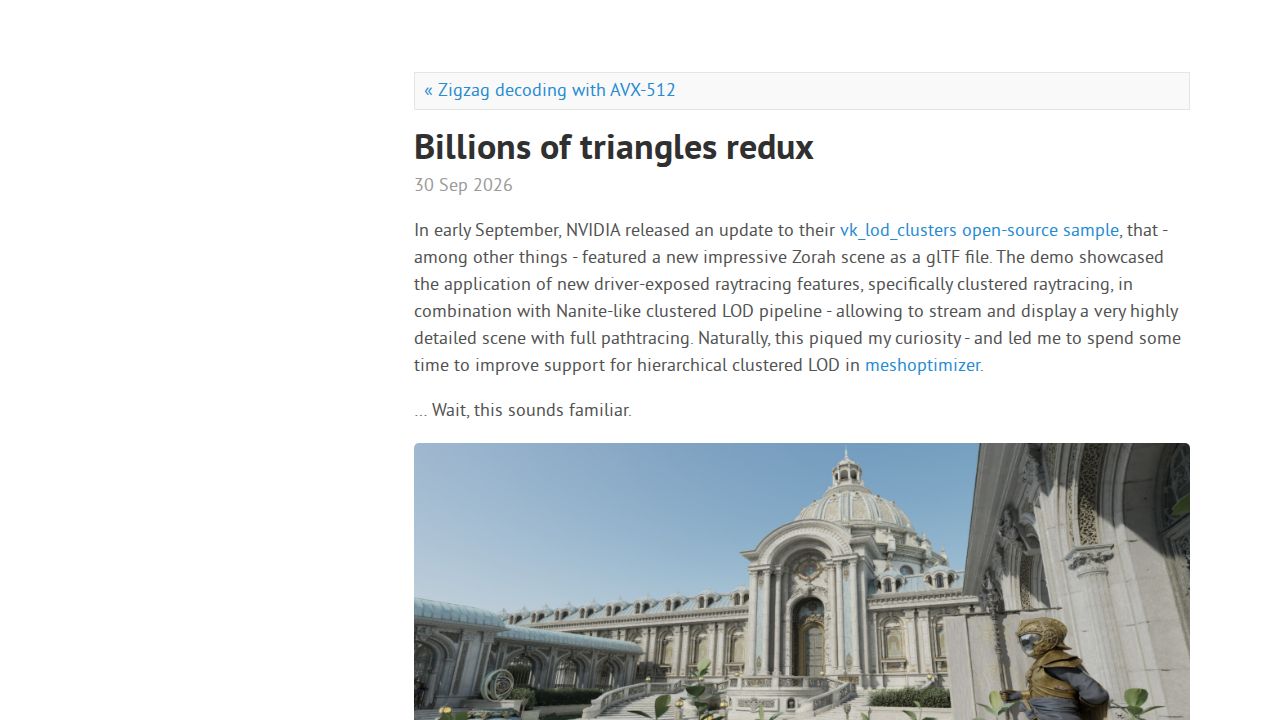
A principios de septiembre de 2026, NVIDIA lanzó una actualización a su muestra vk_lod_clusters de código abierto, una demostración de Vulkan que combina el raytracing agrupado expuesto por el controlador con un pipeline de nivel de detalle (LOD) agrupado similar a Nanite para transmitir y mostrar una escena extremadamente detallada con pathtracing completo. La actualización añadió una nueva escena Zorah como archivo glTF, y llevó a Arseny Kapoulkine, autor de la biblioteca de procesamiento de mallas meshoptimizer, a publicar un artículo de seguimiento titulado «Billions of triangles redux». El nuevo artículo se centra menos en el tiempo de procesamiento que su informe anterior sobre la escena y más en la compresión y otros aspectos del pipeline; no es necesario leer el artículo anterior para seguirlo.
La nueva escena Zorah llega a aproximadamente 1.600 millones de triángulos y llega como una descarga de unos 70 GB. Lo más llamativo no es el tamaño de la descarga, sino los propios datos de la escena glTF: unos 32 GB en la versión 2026, frente a unos 36 GB en la versión 2025, a pesar de que la cantidad total de geometría ha cambiado muy poco. En contraste, NVIDIA ahora también proporciona la versión original, sin atributos y sin texturas, de la escena con solo 9 GB, lo que subraya que los atributos y las texturas añadidos fue en gran parte lo que empujó el archivo anterior hacia los 36 GB.
La reducción de tamaño proviene de las extensiones de compresión de meshoptimizer en las escenas glTF: EXT_meshopt_compression, que expone la compresión de vértices e índices usando el formato de vértice más antiguo «v0», y el más nuevo KHR_meshopt_compression, que utiliza el formato de vértice v1 actualizado y fue estandarizado a principios de 2026. En lugar de empaquetar una malla a la vez, estas extensiones organizan los datos como arreglos de bytes que representan datos de vértices o índices, dejando libres a las herramientas para decidir cómo dividir y almacenar las mallas. El códec de vértice meshoptimizer en sí es sin pérdida — reproduce exactamente la secuencia de bytes original —, pero una capa inferior puede hacerlo con pérdida, ya sea mediante datos pre-cuantizados cuando los accessors de glTF los admiten, o mediante «filtros» que intercambian un poco de precisión por mejores ratios de compresión. La escena Zorah, siendo un archivo intermedio y no el formato de entrega final, utiliza la opción sin pérdida; la entrega de última milla en cambio usaría una compresión con pérdida afinada para minimizar el tamaño del archivo.
Kapoulkine informa los siguientes tamaños para la escena: raw (descomprimido), v0 (lo que se almacena en disco en el archivo descargado) y v1 (recomprimido con el formato v1):
Category Raw v0 v1 Positions 14.3 GB 9.1 GB (63.5%) 8.9 GB (62.1%) Attributes 30.1 GB 21.6 GB (71.8%) 20.5 GB (68.2%) Indices 18.9 GB 1.9 GB (10.1%) 1.9 GB (10.1%) Total 63.3 GB 32.6 GB (51.5%) 31.3 GB (49.5%)
Los datos de índice se comprimen especialmente bien; las posiciones y atributos se comprimen de manera más moderada. Cambiar al formato de vértice v1 recupera unos puntos porcentuales adicionales y se decodifica más rápido.
¿Por qué preocuparse por comprimir un archivo intermedio? Kapoulkine da dos razones. En primer lugar, reduce el costo de leer la escena desde el disco: la decodificación de datos de vértices o índices funciona a varios gigabytes por segundo de salida en un solo núcleo, la descompresión tarda menos del 1% del tiempo de procesamiento total, se ejecuta completamente en paralelo y reduce a la mitad la huella de lectura del disco. En segundo lugar, un compresor optimizado para mallas puede terminar siendo más pequeño que uno de propósito general. Usar Zstandard a nivel 6 sobre datos raw produce un archivo de 38.0 GB (60.1% del raw), mientras que aplicar Zstandard sobre la compresión meshopt v1 llega a 27.4 GB (43.3% del raw) — un resultado aparentemente paradójico. El punto de diseño detrás de esto es explícito: los códecs meshoptimizer no reimplementan un compresor sin pérdida completo, sino que se enfocan en características que los compresores de propósito general suelen pasar por alto, manteniendo la secuencia de salida amigable tanto para una decodificación rápida como para una post-compresión adicional. La motivación original era simplemente que los SSD se estaban volviendo irrazonablemente rápidos; cuando una unidad puede transmitir varios gigabytes por segundo, una compresión lenta pero compacta puede no rentar en absoluto, y el enfoque en capas permite a un editor elegir el códec subyacente (LZMA, Zstandard, etcétera) sin tocar la capa de mallas.
En el lado del procesamiento, el pipeline se asemeja en gran parte al artículo anterior: divide la malla de entrada en clusters, particiona los clusters en grupos, simplifica cada grupo preservando la frontera, divide el nuevo grupo en más clusters y repite. En el lado del tiempo de ejecución, clusterlod.h ahora proporciona clodBuildHierarchy, que construye una BVH sobre el DAG de clusters para seleccionar rápidamente los clusters en el correcto nivel de fidelidad, como se describe en la presentación original de Nanite. Como la escena ahora lleva atributos, se utiliza la simplificación consciente de atributos a través de meshopt_simplifyWithAttributes: cada atributo recibe un peso escalar según cuánto cambia la apariencia de la superficie, de modo que la métrica de error del simplificador refleja el resultado visual completo.
Los recientes cambios en clusterlod.h mejoran la coherencia espacial y la robustez de la simplificación. La opción partition_sort ordena las particiones por orden Morton, haciendo que el DAG sea más espacialmente coherente y ayudando a la localidad de streaming; meshopt_buildMeshletsSpatial es más rápido gracias a prefetches colocados estratégicamente; y meshopt_partitionClusters ha mejorado en recientes lanzamientos. El modo permissive, habilitado con la bandera meshopt_SimplifyPermissive, ha sido refinado y marcado como estable: exonera la mayoría de las restricciones topológicas para que mallas ricas en costuras no detengan al simplificador — un problema para los esquemas LOD jerárquicos que se basan en simplificar mallas fuente de alto detalle hasta un solo cluster — y el error de atributo ahora puede ser limitado para evitar una selección de LOD excesivamente pesimista. Cuando se usa el modo permissive, los atributos con discontinuidades deben pasarse al simplificador para una ponderación basada en atributos, y la selección de LOD debe confiar en el error de salida calculado más que en un presupuesto de triángulos fijo; Zorah no usa protección selectiva de discontinuidades. En la escena Zorah, el fallback de baja calidad «sloppy» se toma ahora para aproximadamente el 0.01% de los grupos simplificados, lo que el autor considera benigno.
El artículo nota la prueba en una GeForce RTX 5070 con 12 GB de VRAM e incluye un apéndice que cubre el afinado de la compresión con pérdida para escenarios de entrega de última milla.