Los agentes de IA actuales a menudo dependen de complementos de 'memoria' que intentan proporcionarles un contexto persistente entre sesiones. Sin embargo, estos sistemas son fundamentalmente defectuosos. En lugar de ayudar a los agentes a comprender los proyectos, estos complementos de memoria crean una lotería en la que los agentes recuperan fragmentos de conversaciones pasadas esperando que los relevantes aparezcan en la cima. El problema reside en la arquitectura de estos sistemas de memoria. Casi todos los complementos de memoria comerciales funcionan de manera idéntica: analizan los transcripciones de las sesiones, generan fragmentos de memoria, los almacenan en una base de datos vectorial (RAG) y, en cada solicitud, recuperan los 5 fragmentos más similares para inyectarlos en el contexto del agente. Este enfoque presenta varias limitaciones críticas. Primero, los recuerdos se muestran únicamente por similitud en el espacio de embeddings, sin mecanismo para determinar cuál fragmento es correcto, actual o completo. Segundo, almacenar solo fragmentos pierde contexto crucial—motivaciones, lecciones aprendidas, factores ambientales y razonamiento detrás de las decisiones. Tercero, estos sistemas tratan el pasado como verdad, ignorando que las bases de código evolucionan diariamente, haciendo que los fragmentos sobre características como la autenticación queden rápidamente desactualizados. Cuarto, incluso cuando se proporcionan herramientas de búsqueda sobre su memoria a los agentes, no pueden saber qué buscar porque no saben lo que no saben. Finalmente, el almacén de memoria se vuelve inauditable—miles de embeddings en SQLite sin forma de verificar qué recuerdos existen, cuáles están obsoletos o cuáles podrían estar influyendo incorrectamente en el comportamiento del agente. La idea central es que los agentes no necesitan mecanismos de recuerdo mejores; necesitan documentación. Como observa el autor: 'Nadie vuelve a ver una reunión de equipo de hace tres años para recordar las restricciones alrededor de una función. La gente escribe las cosas y utiliza esos registros en su lugar.' Esta realización llevó al desarrollo de sistemas de memoria basados en documentación. En lugar de capturar fragmentos de conversación fugaces, estos sistemas proporcionan a los agentes un espacio de trabajo estructurado de archivos Markdown donde pueden persistir conocimiento importante: especificaciones, decisiones, hallazgos de investigación, índices y pautas. El bucle agente se transforma de 'prompt → build → forget' a 'prompt → consult → build → update'—antes de comenzar el trabajo, el agente consulta los documentos relevantes de su cerebro; después de completar el trabajo, actualiza el cerebro revisando la información obsoleta y agregando nuevos documentos donde sea necesario. Una implementación de este enfoque es Operator Memory, que proporciona a los agentes un cerebro basado en Markdown organizado en tres particiones: conocimiento privado del proyecto (.operator/), conocimiento del proyecto compartido con el repositorio (.operator-shared/) y reglas personales utilizables entre proyectos (~/.operator/user/). El sistema incluye documentación automática de especificaciones y decisiones, memoria transparente almacenada como archivos Markdown legibles, conocimiento compartible mediante control de versiones de Git y cero requisitos de infraestructura—sin agentes en segundo plano, embeddings o bases de datos vectoriales. Principios similares aparecen en sistemas alternativos como Encephalon, que almacena conocimiento durable de agentes como registros JSON fusionables con Git indexados por SQLite para búsquedas rápidas. Ambos enfoques comparten la característica clave de tratar la memoria del agente como documentación que puede leerse, actualizarse, confirmarse y compartirse—en lugar de como un mecanismo de recuerdo opaco. Este cambio representa un cambio fundamental en cómo pensamos el estado del agente: pasando de fragmentos frágiles y sin contexto a documentación mantenible, auditada y que crece junto con el proyecto y el equipo.
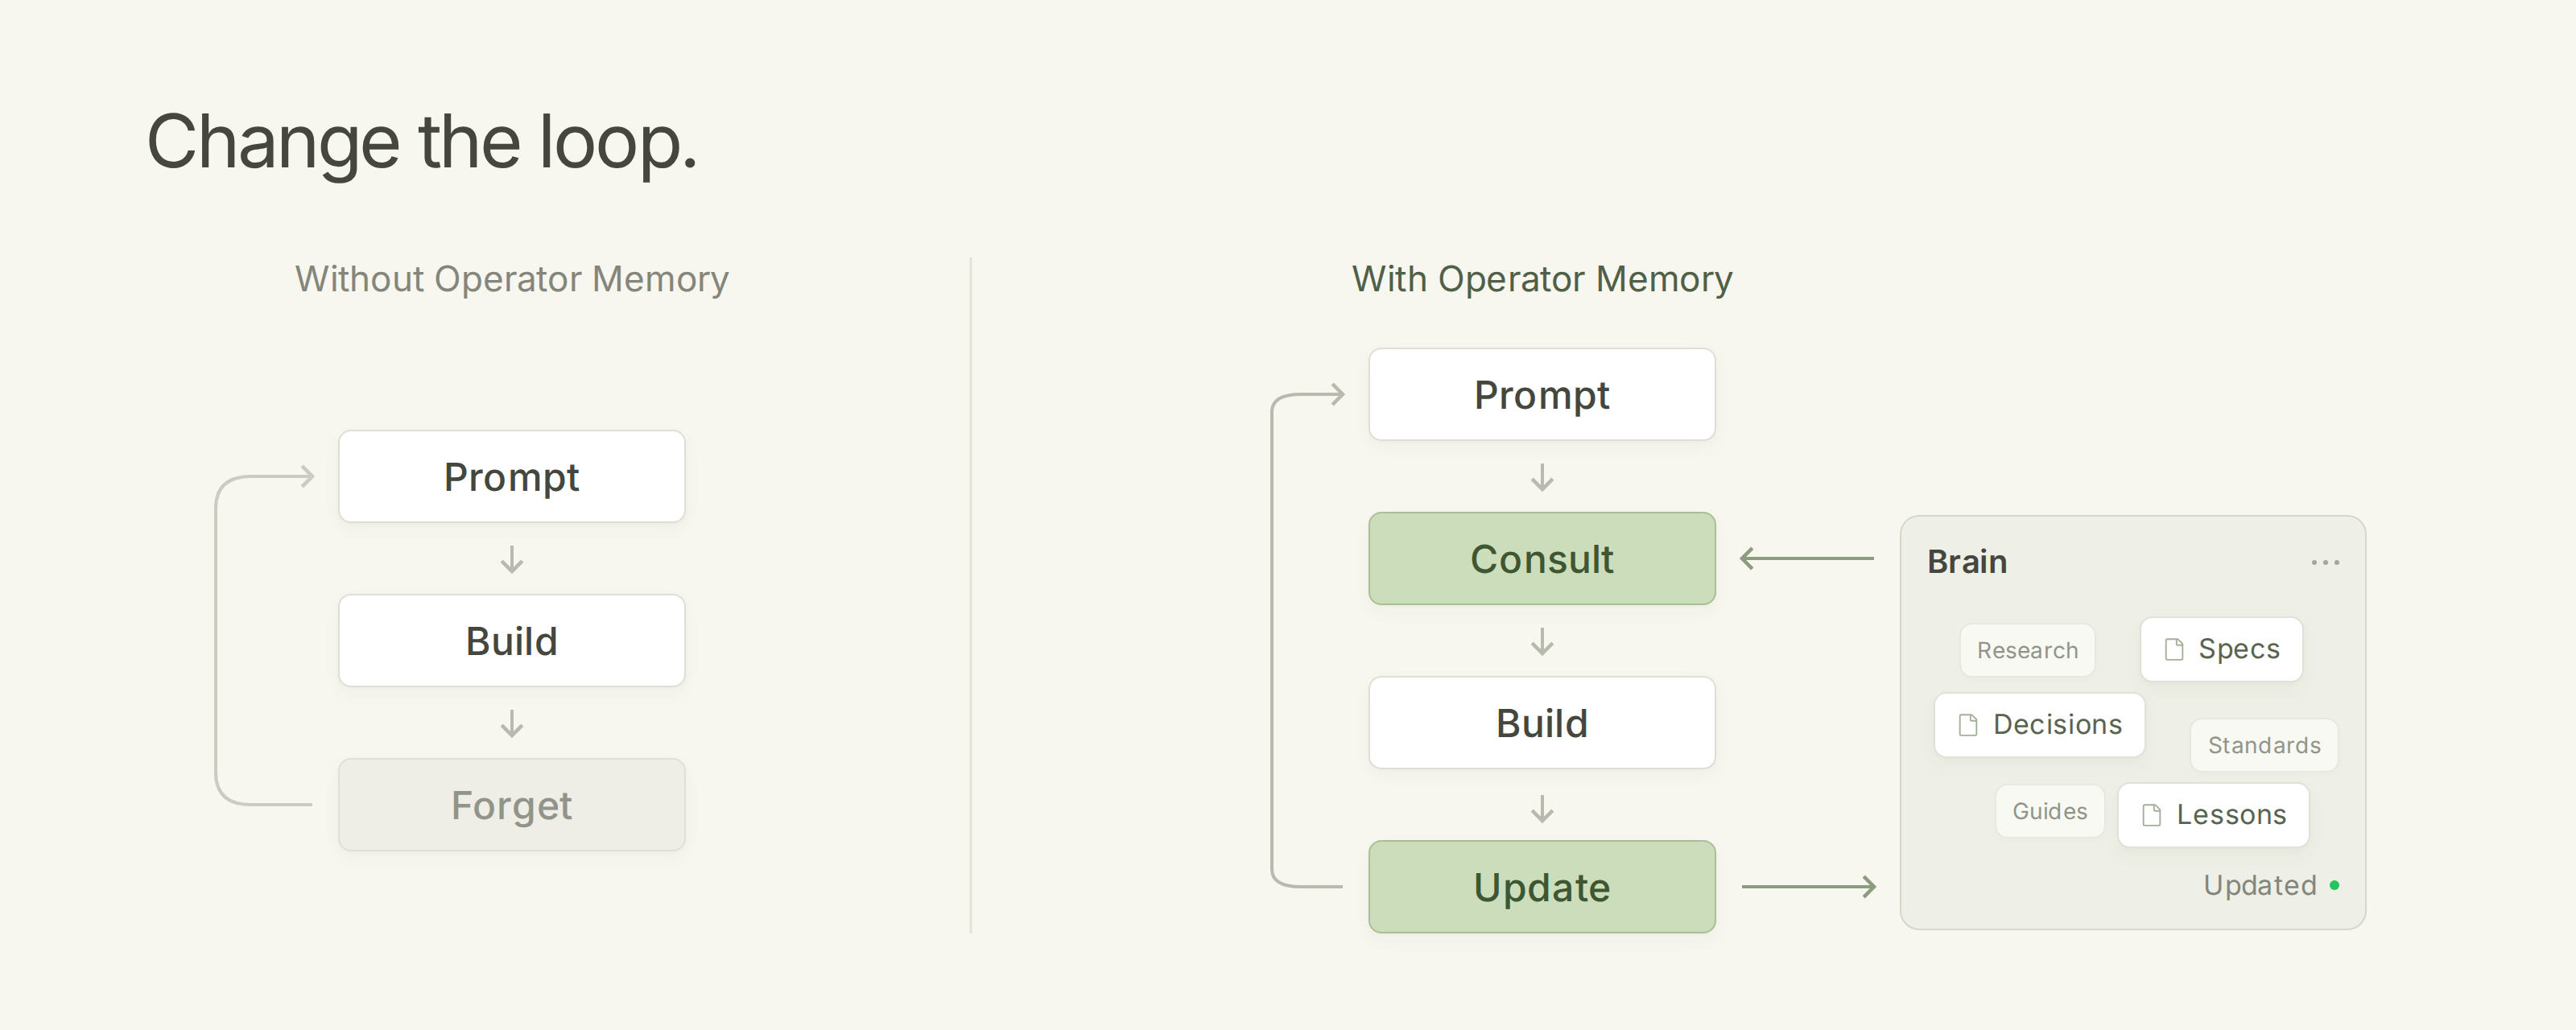
The image supports the article’s core argument that agents should consult documentation (the brain) before building and update it after work, rather than relying on unreliable memory snippets.