Los modelos de decisión como el Jev de TypeSafe se introdujeron como un enfoque intermedio para los guardias de seguridad de IA, prometiendo las salidas estructuradas y seguras en tipo de los clasificadores tradicionales junto con la flexibilidad zero‑shot de los large language models. Al devolver una decisión fija (por ejemplo, una probabilidad) en lugar de generar texto, Jev afirma ofrecer una inferencia más rápida y barata, evitando la necesidad de datos de entrenamiento específicos para la tarea requeridos por los clasificadores convencionales.
Las pruebas de referencia realizadas por el equipo de seguridad de IA de Red Hat midieron la latencia y la precisión para los guardias de seguridad contra inyección de prompts y toxicidad/profanidad. Para la detección de inyección de prompts, Jev alcanzó un 86,35 % de precisión con una latencia mediana de 348,1 ms, en comparación con el 89,01 % de precisión y 54,1 ms de latencia del clasificador tradicional deberta‑v3‑base‑prompt‑injection‑v2 y el 89,31 % de precisión y 312,5 ms de latencia del modelo LLM‑as‑a‑judge Qwen3.6‑35B. En la prueba de seguridad de toxicidad/profanidad, Jev obtuvo una precisión del 86,20 % a 360,4 ms de latencia, mientras el clasificador tradicional granite‑guardian‑hap‑125m alcanzó un 80,27 % de precisión a 33,2 ms y Qwen3.6‑35B alcanzó un 85,47 % de precisión a 307,6 ms. Aparecieron brechas de latencia similares al comparar Jev con otras opciones LLM‑as‑a‑judge como Shieldstral‑1.0 y variantes de Nemotron‑3.5.
Esta imagen muestra el logotipo de Red Hat AI, representando a la organización que realizó las pruebas de referencia sobre los modelos de decisión y los clasificadores tradicionales mencionados en el artículo.
Estos resultados muestran que Jev no cumple con su ventaja de velocidad prometida; su latencia es aproximadamente seis veces mayor que la de los clasificadores tradicionales y entre un 10‑20 % mayor que la de los modelos LLM‑as‑a‑judge líderes. Aunque la precisión de Jev sigue siendo competitiva y su capacidad zero‑shot puede ser útil para escenarios novedosos de guardias sin datos de entrenamiento, el retraso adicional en la toma de decisiones puede superar los beneficios de seguridad de esquema en aplicaciones de IA de alto rendimiento donde se esperan tiempos de respuesta a nivel de milisegundos. En consecuencia, los adoptantes deben evaluar Jev frente a requisitos específicos de latencia en lugar de asumir una superior eficiencia.
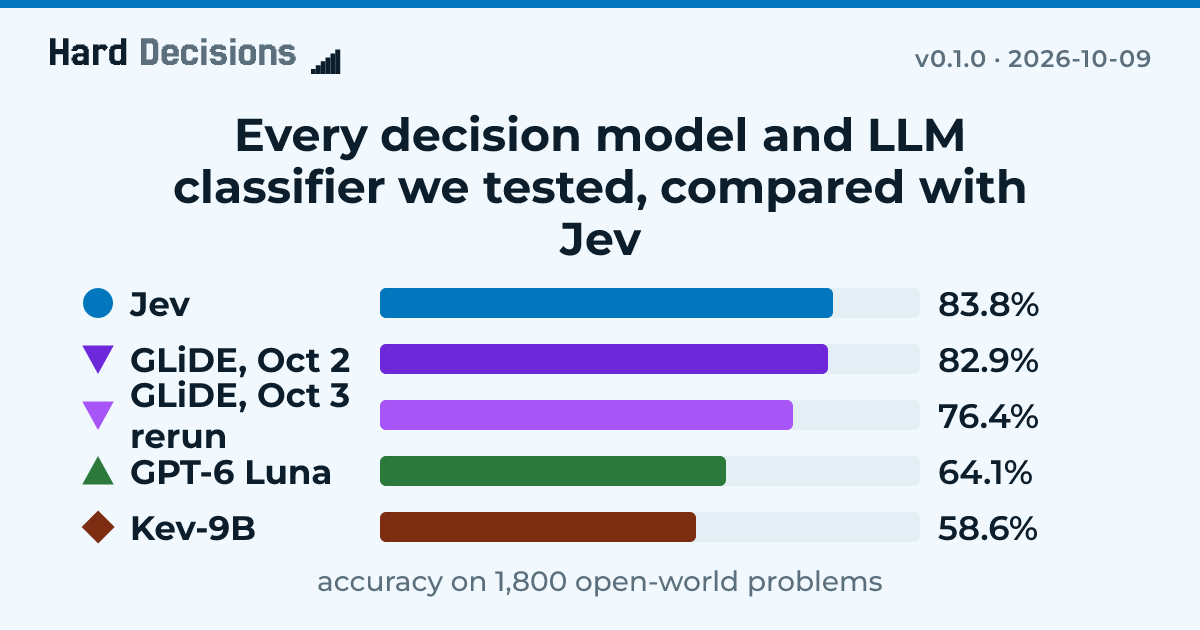
El gráfico muestra que Jev alcanza una precisión del 83,8 %, menor que GLiDE y mayor que GPT-6 Luna y Kev-9B, ilustrando el intercambio entre precisión y latencia discutido en el artículo.