Strands Decider 2B es un modelo de decisión de código abierto de 2 mil millones de parámetros publicado por Strands Agents. Parte del modelo base Qwen3.5‑2B, elimina la cabeza del modelo de lenguaje que genera texto y la reemplaza por una cabeza de puntero que puntúa el estado oculto de cada opción de respuesta respecto a una posición de referencia. Esta arquitectura permite al modelo elegir entre un conjunto predefinido de alternativas y producir una puntuación de confianza numérica en lugar de texto libre.
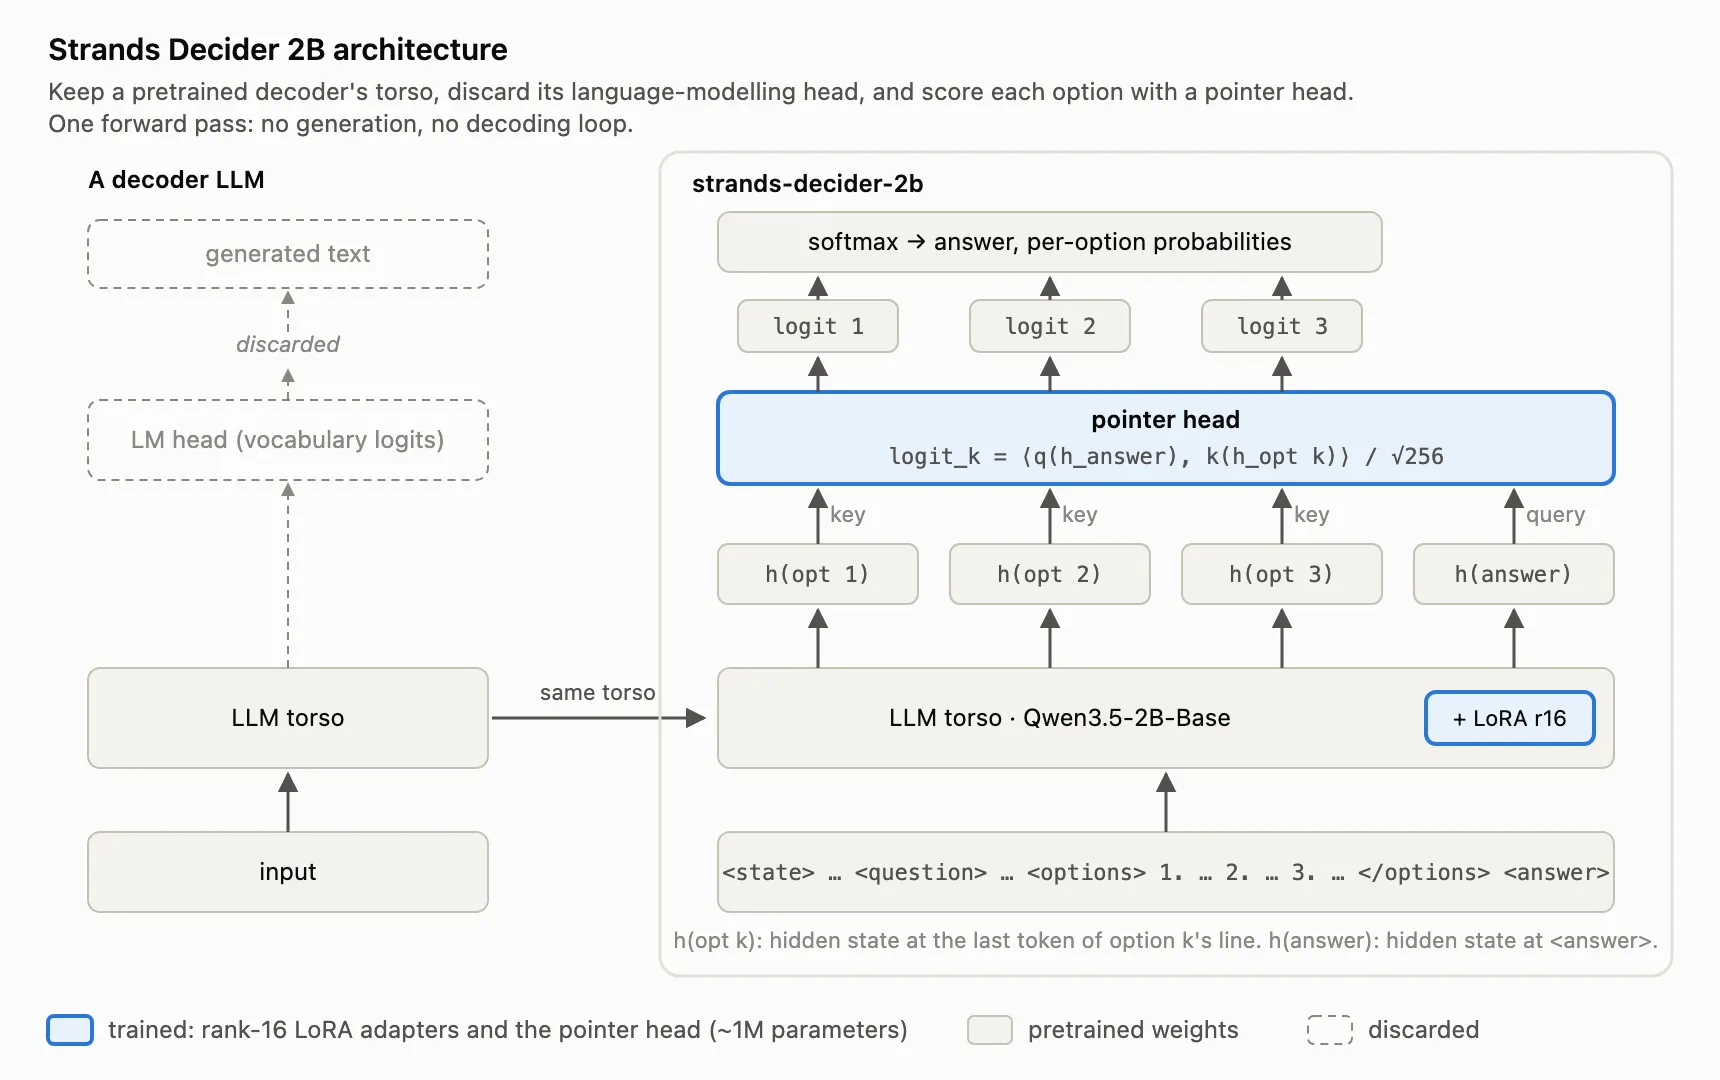
El artículo explica que Strands Decider 2B parte del modelo base Qwen3.5-2B, elimina la cabeza del modelo de lenguaje y la reemplaza por una cabeza de puntero que puntúa las opciones de respuesta.
Debido a que está limitado a un conjunto fijo de opciones, Strands Decider 2B siempre devuelve una respuesta de ese conjunto y puede hacerlo con una latencia muy baja—aproximadamente 115 ms de mediana en una GPU RTX 3090 y 153 ms en un MacBook M3 para tareas pequeñas, con la latencia aumentando aproximadamente de forma lineal con el número de tokens en el prompt. En el benchmark público JevBench, el modelo ocupa el tercer lugar entre 33 modelos de decisión de la clase de 2 B‑parámetros y el primero al excluir los modelos apenas superiores a 2 B, lo que demuestra una precisión y calibrado competitivos. Además proporciona una puntuación de fiabilidad que estima la confianza en su selección, una característica que normalmente no expone la API de inferencia de LLMs estándar. Estas propiedades lo hacen adecuado para tareas de decisión rápidas como el enrutamiento de modelos, la selección de herramientas, los guardianes, la gestión de memoria, la clasificación de políticas y la navegación simple en juegos o laberintos.
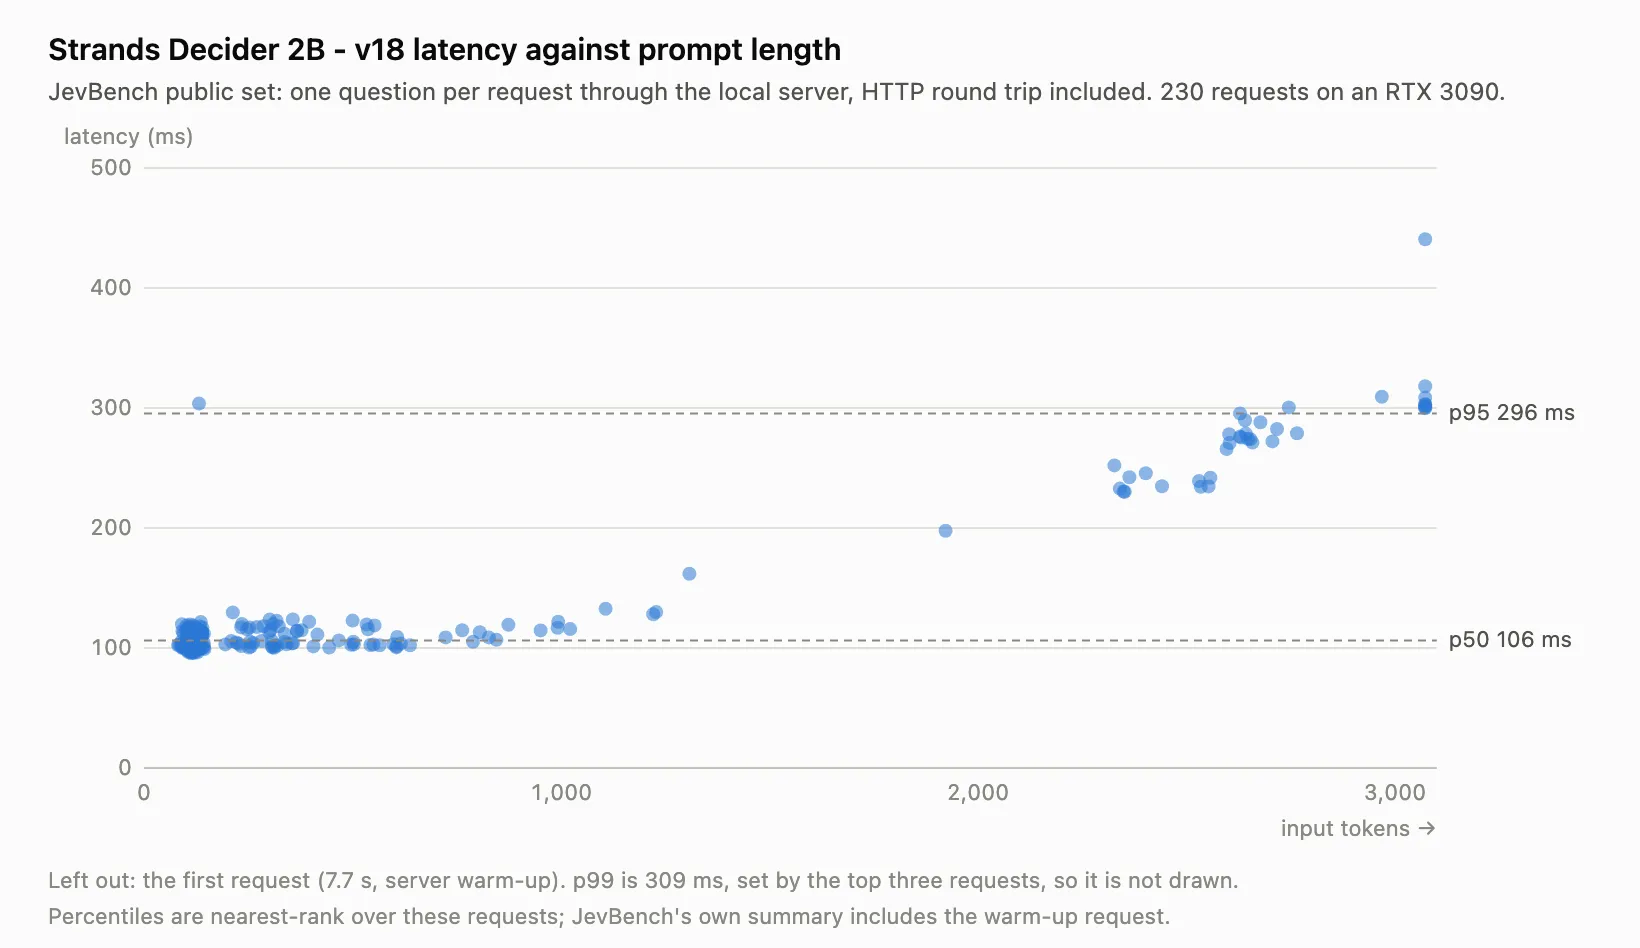
El artículo señala una latencia baja de aproximadamente 115 ms en una RTX 3090 y 153 ms en un MacBook M3, que crece aproximadamente de forma lineal con el número de tokens del prompt.
Una versión WebGPU contribuida por la comunidad cuantiza el modelo a int4 y se ejecuta totalmente en el navegador; en un benchmark de 27 ítems coincide con la respuesta principal de la implementación de PyTorch en cada caso, con un error absoluto medio de probabilidad de solo 0.019 debido a la cuantización.
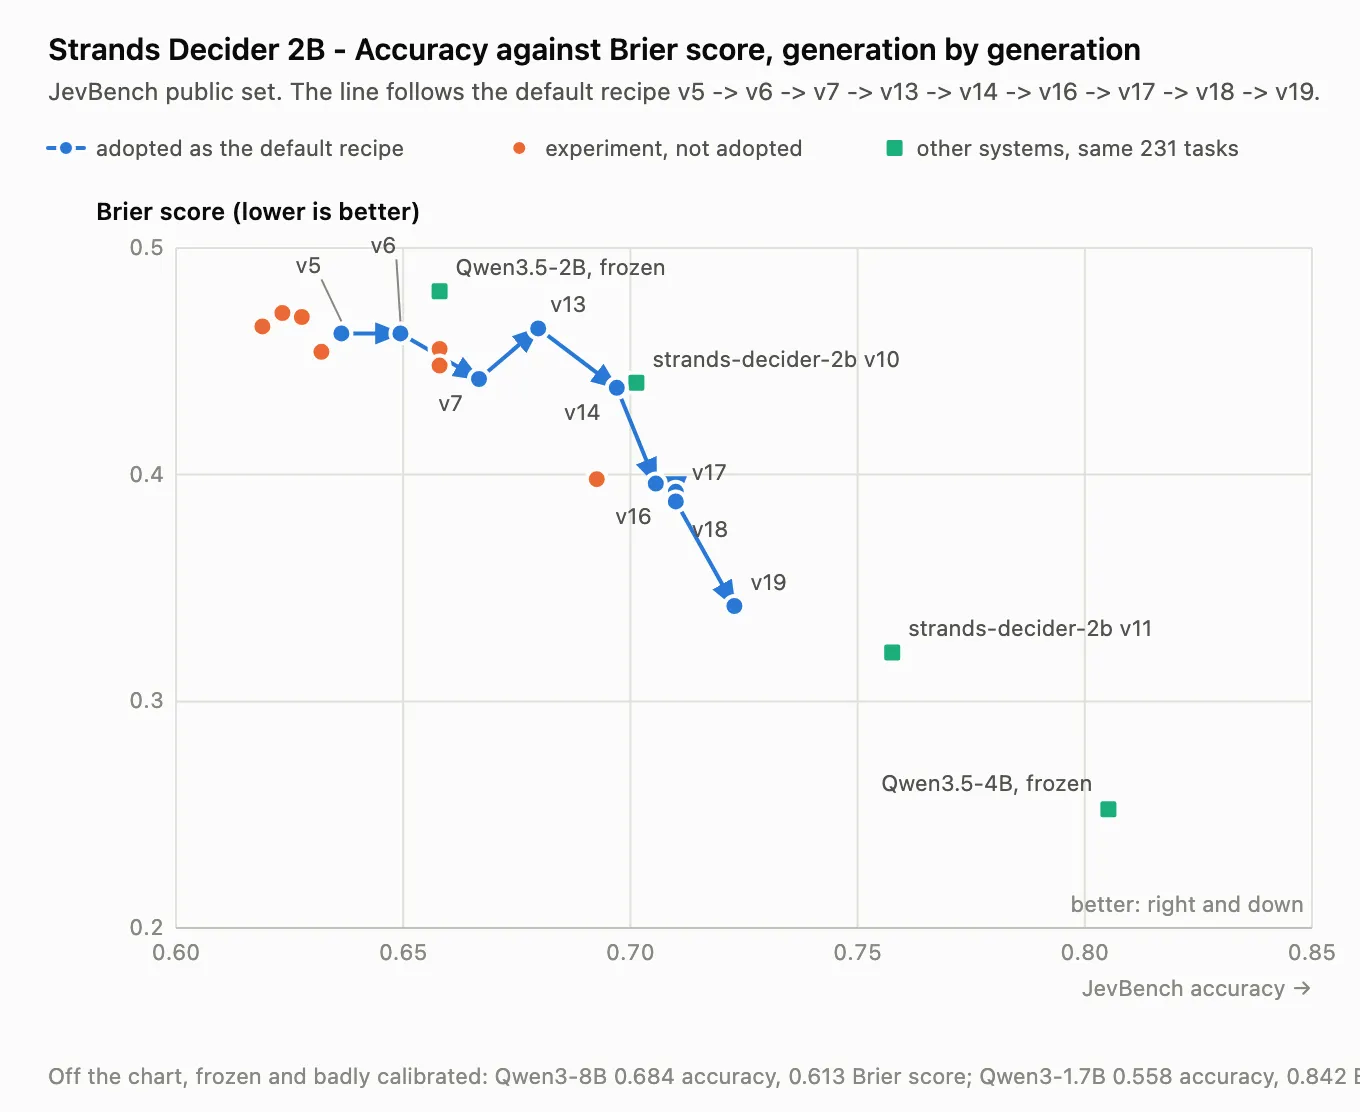
En el benchmark JevBench, el modelo se sitúa en tercer lugar entre los modelos de decisión de 2 B‑parámetros y primero al excluir los modelos ligeramente mayores, indicando una fuerte precisión y calibrado.