Cactus ha lanzado Needle 3, un "modelo fundamental de automatización" diseñado para ejecutar llamadas a herramientas, extracción de datos estructurados y búsqueda de texto en dispositivos pequeños — teléfonos, wearables, centros de domótica, robots y microcontroladores. El modelo completo se distribuye como un único binario de 8-29 MB, cuantificado a aproximadamente 2 bits por peso, y la afirmación principal de la empresa es que una pequeña subred afinada puede igualar a DeepSeek V4 Flash, un modelo frontera mucho más grande alojado en la nube, en las tareas específicas de llamadas a herramientas y extracción de campos de texto.
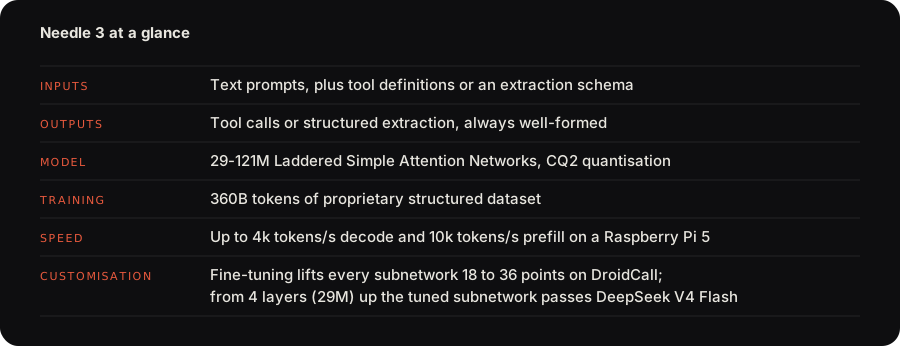
The article explains the Laddered Simple Attention Network replaces the standard feed-forward network with a Monarch Hadamard MLP, pairs GQA with causal convolutions, and reads an engram n-gram memory through a gather operation.
Lo inusual del diseño es lo que Cactus llama la "escalera de inteligencia". Needle 3 es un conjunto de pesos, pero cada profundidad desde 2 capas hasta 20 capas es en sí mismo un modelo desplegable. Un desarrollador puede enviar la versión completa de 20 capas o una subred de 8 capas para una Raspberry Pi, y cada subred puede ser afinada independientemente. En los benchmarks propios de la empresa, una subred de 4 capas afinada durante una época en tareas descendentes iguala a DeepSeek V4 Flash, el modelo supera a modelos aproximadamente 10 veces más grandes en tareas móviles de llamadas a herramientas y iguala a modelos 2 a 3 veces más grandes en extracción.
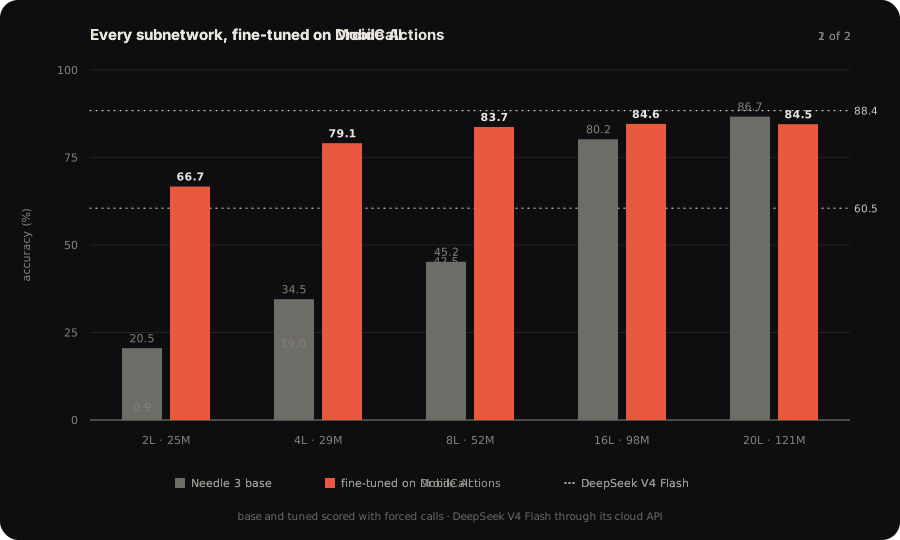
The article describes the intelligence ladder where every depth from 2 to 20 layers is a deployable model that can be fine-tuned independently, and the 4-layer subnetwork matches DeepSeek V4 Flash after one epoch.
¿Cómo intenta lograrlo un modelo de 8-29 MB? La respuesta es la Red de Atención Simple Escalonada, una arquitectura construida para gastar mucha menos cálculo por token que un transformador del mismo tamaño. Según el repositorio de GitHub, reemplaza la red de alimentación estándar (FFN) con un Monarch Hadamard MLP, empareja la atención con consultas agrupadas (GQA) con convoluciones causales, lee una memoria n-grama "engrama" a través de una operación de recolección y añade hiperconexiones multi-carril. La mayoría de los parámetros del modelo residen en ese engrama, por lo que la empresa afirma que el modelo de 121M parámetros realiza el cálculo de uno de 50M parámetros. La página del producto añade que la arquitectura gasta más de 2x menos millones de operaciones de coma flotante (MFLOPs) por token que un transformador de la misma configuración. El modelo fue entrenado con 360B tokens de un conjunto de datos estructurado propietario, y en una Raspberry Pi 5 decodifica entre 400 y 4.000 tokens por segundo y pre-llena entre 1.000 y 10.000 tokens por segundo.
Needle 3 está construido para tres capacidades estrechas, no para conversación. Dado el conjunto de funciones que una aplicación expone, elige la herramienta adecuada y rellena todos los argumentos a partir de lo que dijo el usuario: si pide dos cosas, devuelve dos llamadas en orden, y si pide algo que no cubre ninguna herramienta, devuelve una lista vacía en lugar de adivinar. Para la extracción de datos estructurados, un desarrollador declara una forma — una factura, una reserva, una notificación — le entrega texto desordenado y obtiene campos tipados de vuelta; la empresa afirma que la gramática de decodificación garantiza que la salida se analice y que la extracción generalizó bien a problemas de clasificación. El mismo modelo también devuelve un vector de incrustración de texto, por lo que una aplicación puede buscar, coincidir y enrutar localmente sin salir del dispositivo. La página del producto lista los dominios objetivo: domótica, donde "apagar la habitación y cerrar" se convierte en dos llamadas ejecutadas localmente; robots; teléfonos; wearables; gafas de realidad aumentada; automóviles; y control de computadora en inglés plano.
La ruta de afinado es barata en comparación con los estándares de este campo. Cactus ofrece tres ejecuciones de afinado alojadas por $19 una vez, con cálculo y generación de datos de entrenamiento incluidos, y el paquete de código abierto soporta afinado LoRA (baja rango de adaptación) local en la base congelada a las 20 capas completas, y exporta un .cact de 4 bits de cualquier subred que se ejecute en el mismo motor:
needle finetune data.jsonl --epochs 10 --out adapter.safetensors needle build --lora adapter.safetensors --out tuned.cact
El bucle de Python es igualmente corto — decora una función, y run() completa el bucle ejecutando la función y devolviendo sus resultados:
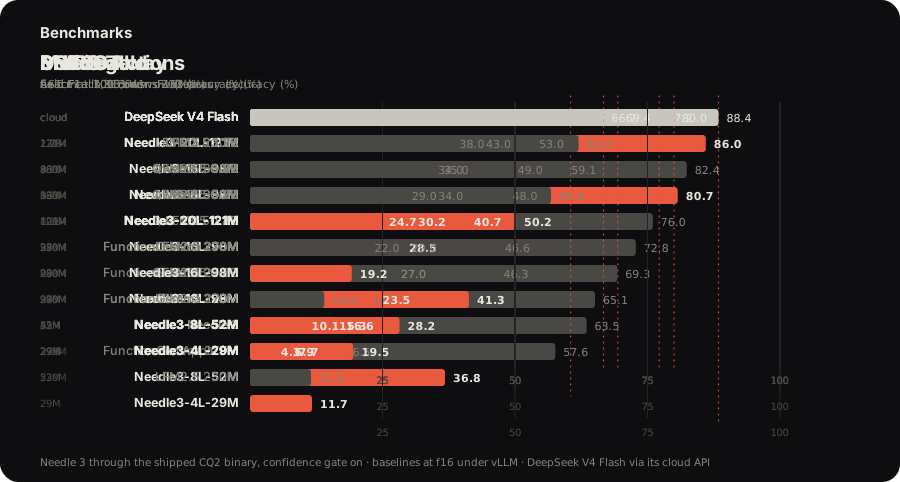
The article spells out how the benchmarks should be read: exact-match accuracy for tool calling, field micro-F1 for extraction, and the comparison conditions including the CQ2-bit binary versus f16 baselines.
import needle
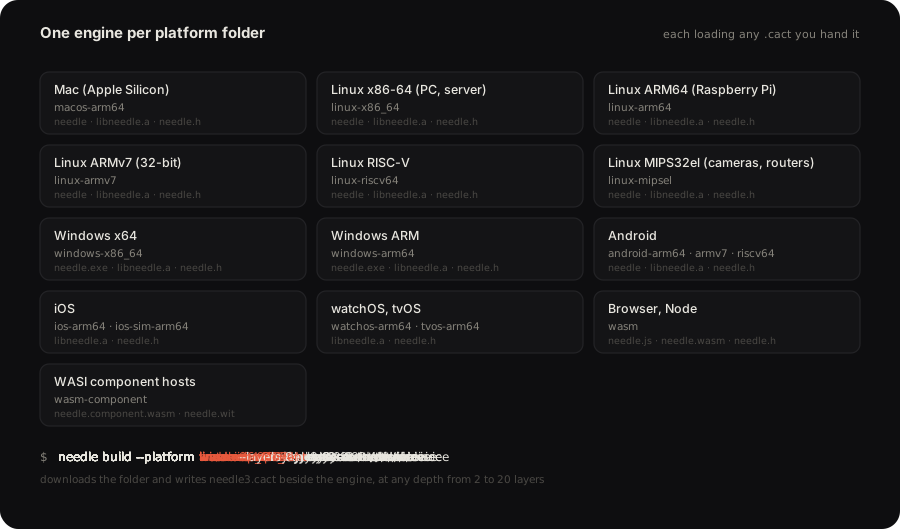
The article lists the broad deployment platforms including macOS, Linux on x86_64, arm64, armv7, riscv64, mipsel, Windows, Android, iOS, tvOS, watchOS, browser via WASM, and a WASI component.
@needle.tool def get_weather(city: str): "Obtener el clima actual de una ciudad." return {"city": city, "temp_c": 27, "sky": "clear"}
agent = needle.Needle(tools=[get_weather]) print(agent.run("¿cómo es el clima en Lagos ahora?")["results"]) # [{'city': 'Lagos', 'temp_c': 27, 'sky': 'clear'}]
Cada turno devuelve un objeto JSON con las llamadas a funciones, el razonamiento del modelo, una puntuación de confianza calibrada y cifras de tiempo y memoria. Esa puntuación de confianza es la parte del diseño que más determina si el modelo es lo suficientemente confiable para usarlo en un producto real. El motor aplica un mínimo de 0.1: por debajo de él, la llamada se retiene en un campo suppressed_calls y function_calls está vacío. Por encima de él, la propia guía de la empresa es enrutarse en función de la puntuación — actuar inmediatamente cuando sea alta, mostrar la llamada y preguntar cuando sea mediana, y tratar un resultado vacío como una negativa. Una herramienta marcada con desencadenantes siempre produce una llamada para una solicitud coincidente, por lo que la puntuación es lo que le indica a un desarrollador si ejecutarla o confirmarla primero. La empresa es franca que el diseño de herramientas es "el juego completo": el modelo lee un esquema literalmente, por lo que una herramienta estrecha con una descripción simple supera a una amplia, y cada herramienta extra en el conjunto es una oportunidad de desviar.
Esta es también donde las limitaciones honestas del modelo se vuelven claras, y el README de GitHub lo afirma con franqueza: el producto "cambia capacidad de chat general". Needle 3 no es un chatbot y no está pensado para serlo. Es un modelo de automatización: llama una herramienta, extrae un campo, incrusta una frase. Su guía para escribir herramientas — una herramienta por acción, nombres extraídos de lo que dice el usuario, formatos de valor explicados en descripciones, argumentos requeridos con valores predeterminados, y un conjunto pequeño de herramientas por turno — es realmente una lista de las formas en que el modelo puede fallar. La afirmación de la empresa de que la extracción "generalizó bien a problemas de clasificación" está delimitada a sus propias suites; el material fuente no provee evidencia independiente de que generalice a tareas de clasificación arbitrarias, y el estrechez del diseño es el punto entero de su velocidad y tamaño.
Cómo se deben leer los benchmarks vale la pena explicarlo, porque "iguala a DeepSeek V4 Flash" es fácil de sobreinterpretar. Las cifras publicadas provienen de las suites del fabricante, ejecutadas en las divisiones de prueba completas: llamadas a herramientas es exactitud de coincidencia exacta, extracción es micro-F1 de campos. Las suites de herramientas son Mobile Actions (comandos de teléfono a intenciones Android), DroidCall (solicitudes de teléfono, algunas necesitando dos llamadas), y BFCL v4 (Berkeley function calling, un solo turno); las suites de extracción son DSTC8, SNIPS gold, y SNIPS 7-way. Las condiciones de comparación están especificadas: las subredes de Needle 3 corren a través del binario CQ2-bit (Cactus Quants, la cuantificación a 2 bits de la empresa), mientras que los baselines corren a precisión f16 bajo el motor de inferencia vLLM, y DeepSeek V4 Flash se alcanza a través de su API en la nube. Así que la afirmación es que una subred a 2 bits, en dispositivo, logra puntuaciones comparables a un modelo mucho más grande, servido en la nube, a precisión completa, en un puñado de suites de llamadas a herramientas y extracción — no que iguale a DeepSeek V4 Flash en general. La cifra de afinado refuerza el mismo punto: afinado en DroidCall aumenta cada subred entre 18 y 36 puntos, y desde 4 capas arriba, la subred afinada supera a DeepSeek V4 Flash, empezando en 29M parámetros.
El despliegue es amplio. Cada objetivo envía un motor preconstruido de menos de 1 MB que carga los pesos needle3.cact al inicio, y needle build obtiene el motor para una plataforma y coloca los pesos al lado del mismo. Las plataformas incluyen macOS, Linux en x86_64, arm64, armv7, riscv64, y mipsel, Windows, Android, iOS, tvOS, watchOS, navegador vía WebAssembly (WASM), y un componente System Interface WebAssembly (WASI). Un desarrollador puede construir cualquier subred — una versión de 8 capas para una Pi, por ejemplo — y la Plataforma Cactus ofrece el camino completo (conjuntos de datos, la cuantificación a 2 bits, evaluación, afinado, y gestión de conjuntos de datos) en la infraestructura de la empresa para equipos que no quieran construir su propia tubería.
Lo que queda incierto es la brecha entre las propias suites del fabricante y el uso en el mundo real. Las cifras publicadas son mediciones de Cactus, en benchmarks de Cactus, contra un conjunto específico de modelos de comparación ejecutados en condiciones específicas, y el material fuente no incluye una auditoría independiente. El comportamiento del modelo ante lenguaje natural ambiguo — el tipo de formulación que produce una llamada equivocada segura en lugar de una negativa — depende de la calidad de las descripciones de herramientas y de la puntuación de confianza, que está calibrada en datos del fabricante. El modelo está abiertamente disponible, desde el paquete de Python y los pesos en Hugging Face a un repositorio de GitHub con 12.9k estrellas, 875 bifurcaciones, y 326 commits, así que las afirmaciones son independientemente verificables. Para un equipo construyendo automatización en dispositivo alrededor de un conjunto de herramientas bien definido, la arquitectura escalonada y el camino de afinado de $19 valen la pena ser evaluados en sus propios méritos.