Escribir aplicaciones asíncronas que se desempeñen bien en Tokio es un equilibrio entre equidad y agrupación, contentión y aislamiento. El post «Principles for fast Tokio applications» de Russell Cohen identifica las trampas más comunes y las estrategias de optimización.
**Determinar si existe un problema** Antes de optimizar, verificar que los problemas de rendimiento afecten a las métricas que ve el usuario. El autor observa que casi todas las aplicaciones reales de Tokio tienen intervalos de poll (el tiempo entre puntos `.await`) mucho más largos que los 10–100 microsegundos recomendados por Alice Ryhl en su post sobre bloqueo. Sin embargo, los polls largos pueden ser benignos: una aplicación puede tener polls largos que son completamente inofensivos, y corregirlos no mejorará de manera medible las métricas que ve el usuario. La métrica más útil de Tokio es el histograma de latencia de planificación, que mide el tiempo entre que una tarea está ready y que Tokio sondea realmente el future.
**Dividir para latencia, agrupar para throughput** Baja latencia en muchas solicitudes requiere equidad. Una implementación ingenua en pipeline puede hacer que toda la pipeline de un cliente espere detrás de otro, aumentando la latencia drásticamente. Ceder explícitamente después de cada solicitud puede reducir la latencia en aproximadamente 10×; ceder después de varias lecturas consecutivas inmediatamente disponibles mejora la equidad con un menor sacrificio de throughput.
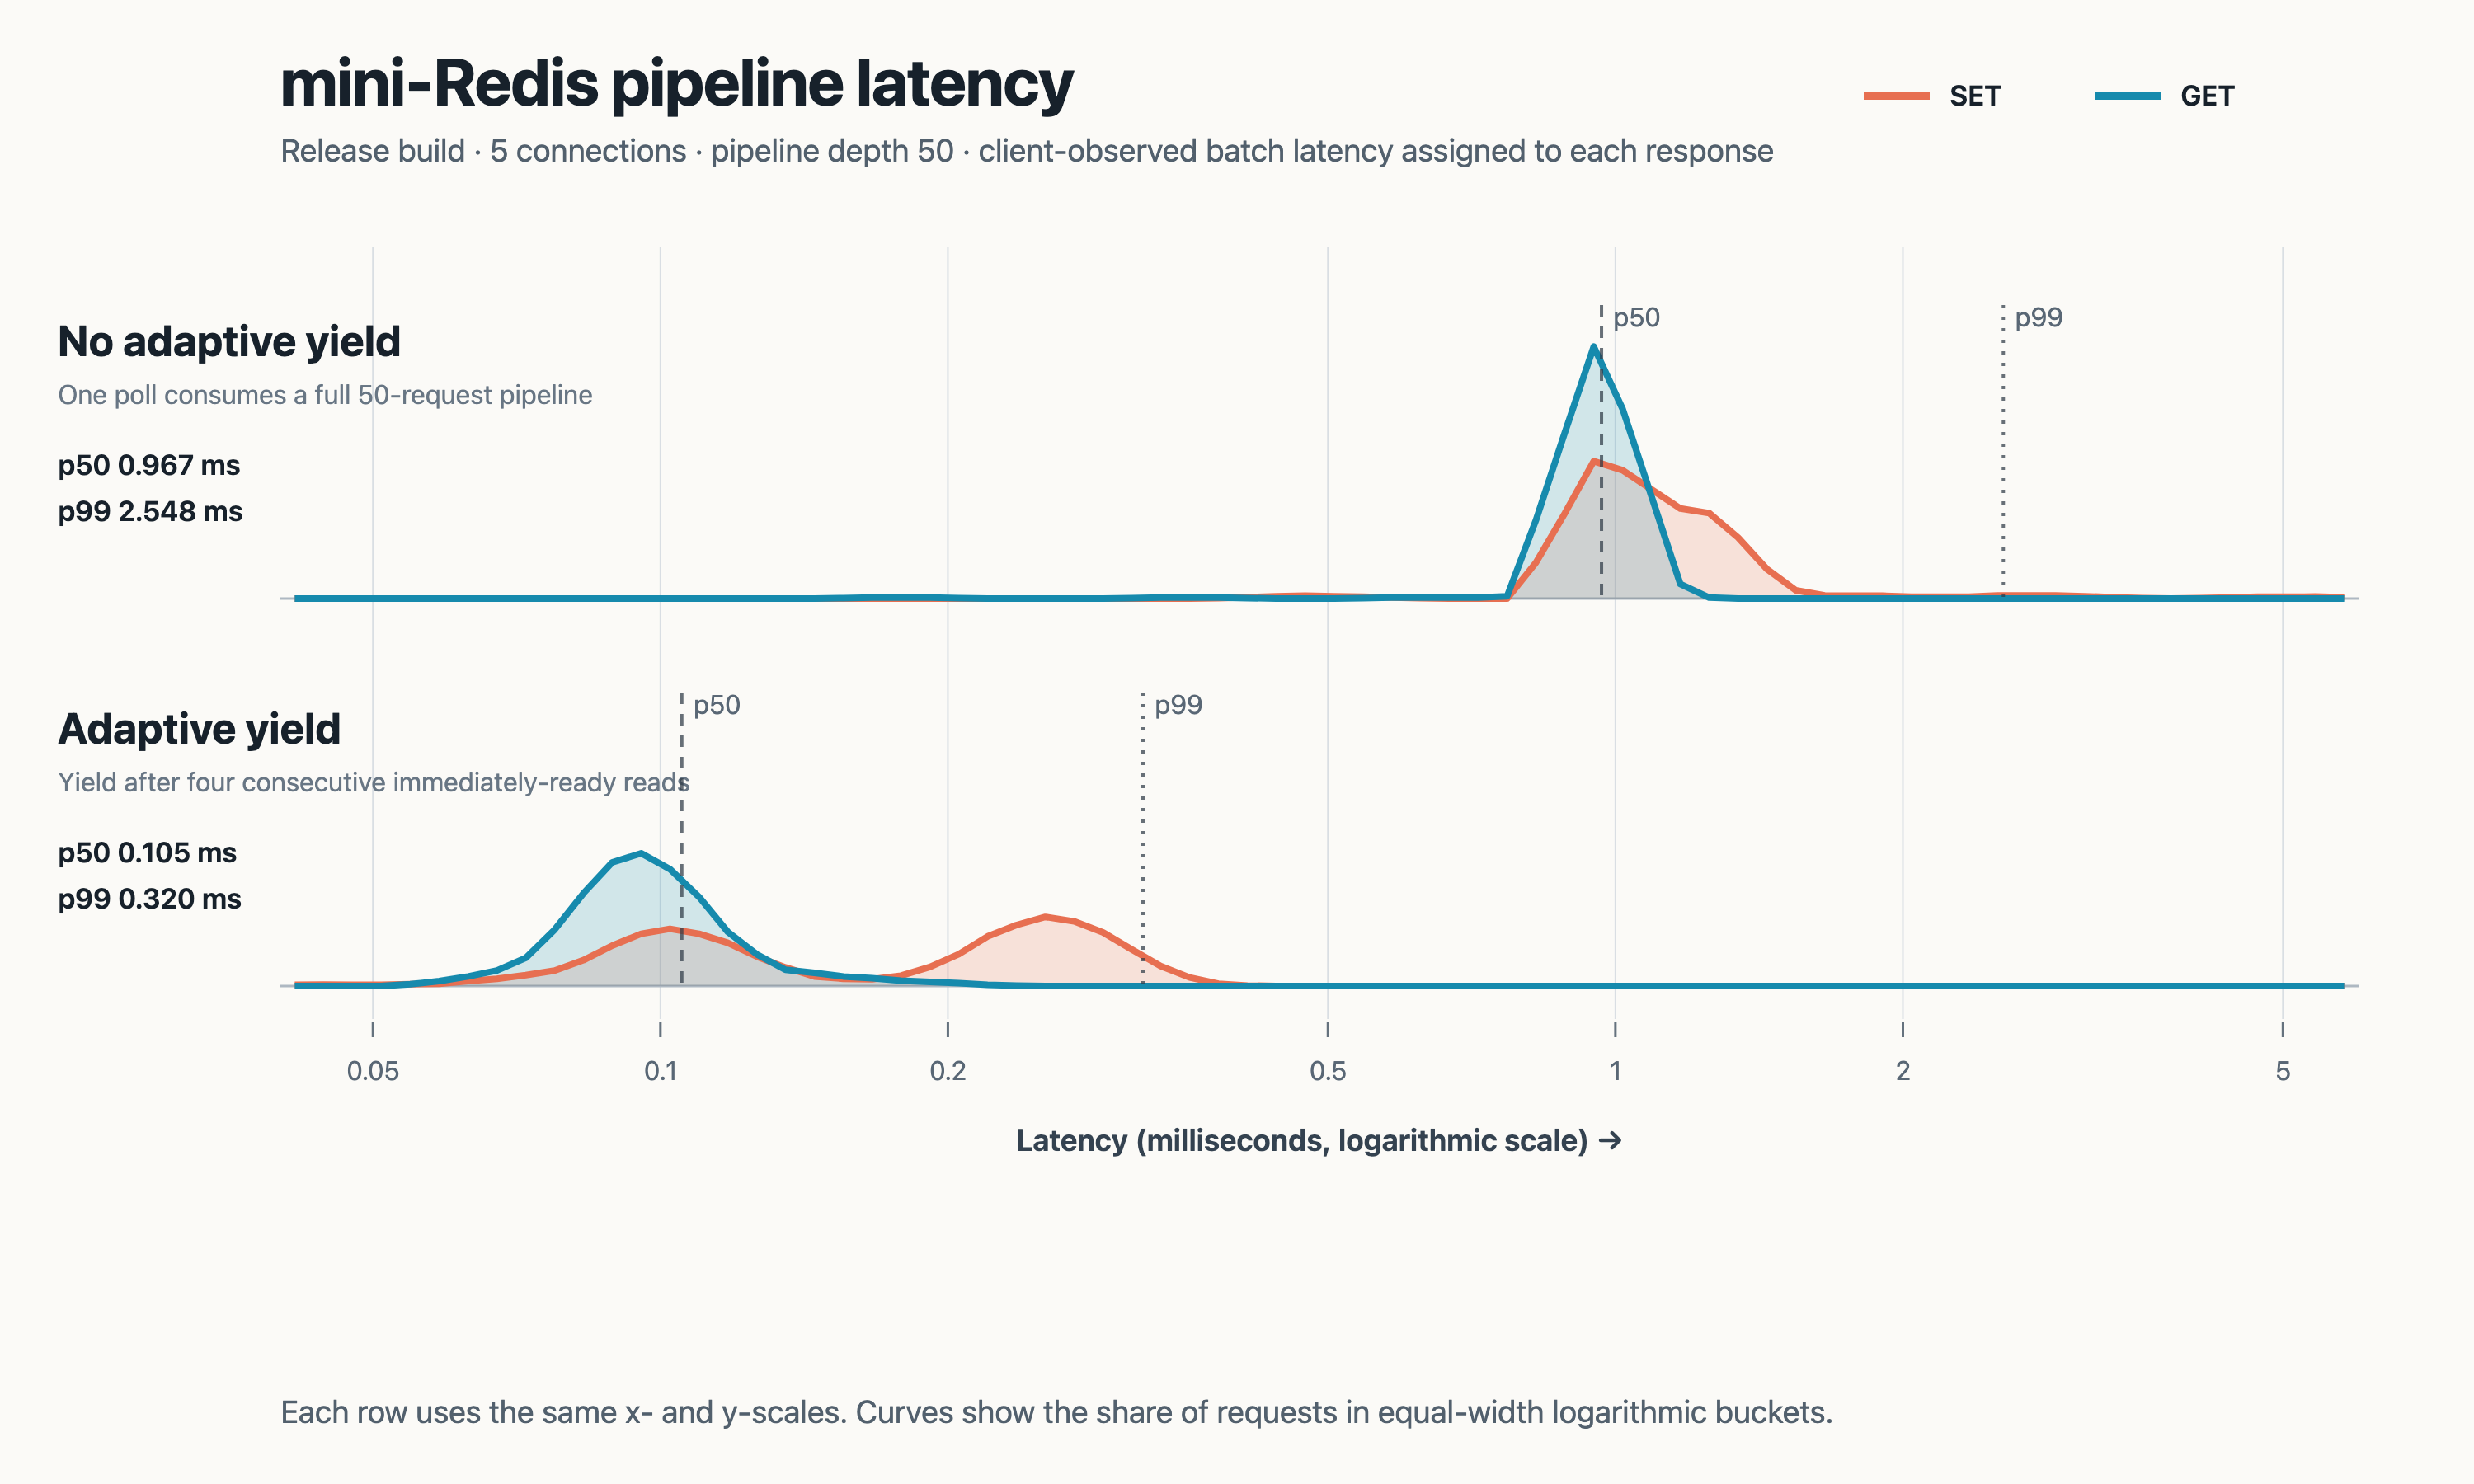
El artículo analiza la división del trabajo para latencia frente al agrupamiento para throughput, señalando que ceder después de cada solicitud puede reducir la latencia drásticamente con un sacrificio mínimo de throughput, como ilustran estas mediciones de latencia de Mini-Redis.
Para throughput, agrupar el trabajo útil por evento de runtime es más eficiente. El mejor ejemplo es `tokio::fs`: sin `io_uring`, Tokio ejecuta cada operación de sistema de archivos en un pool de bloqueo compartido, y cada llamada `spawn_blocking` lleva sobrecoste. Cuando se realiza una serie de operaciones del sistema de archivos o de bloqueo, agrupalas en la unidad más grande razonable. En algunos casos, un hilo del sistema operativo dedicado es una mejor opción.
**Cuidado con los recursos globales** El runtime de Tokio tiene un pool de bloqueo global y una cola de tareas global. A tasas suficientemente altas, empujar trabajo a la cola de bloqueo se convierte en un cuello de botella; `spawn_blocking` puede aparecer en flamegraphs. La cola global generalmente debe permanecer cerca de vacía. Operaciones a nivel de runtime como `spawn_blocking` son prominentes en flamegraphs cuando la cola es constantemente profunda.
**Ten extremo cuidado con los mutex** Bloquear un worker en un mutex contendido puede paralizar todo el runtime. Los registros de métricas detrás de un mutex o un lock de lectura-escritura son especialmente susceptibles: si un flush mantiene el lock mientras hace trabajo costoso, cada worker de Tokio puede eventualmente programar una tarea que se bloquea en el mismo lock, haciendo imposible el stealing. Mantén las secciones críticas extremadamente cortas—una sola actualización de hashmap, por ejemplo. `RWLock`s casi nunca son la primitiva correcta, ya que aún crean contentión atómica en el camino de lectura. No mantengas un lock mientras haces flush, realizas I/O, o esperas otro future. Un truco común es bloquear, luego clonar los datos; si las lecturas stale son tolerables, esto limita el tiempo que se mantiene el mutex.
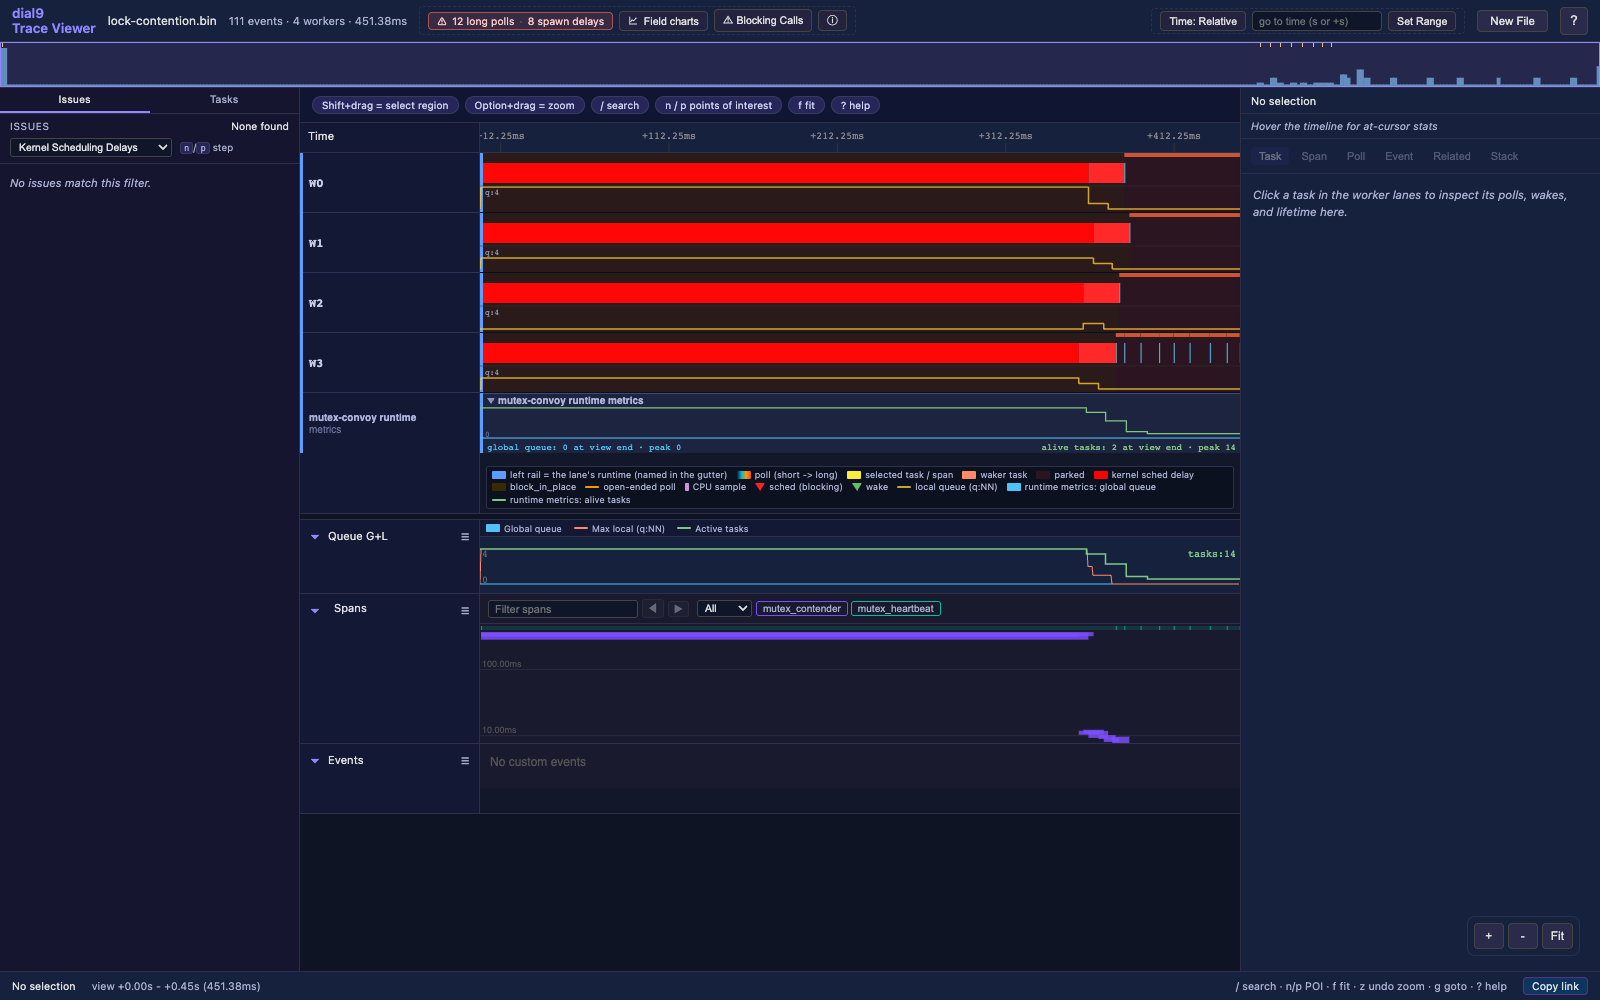
El artículo advierte que bloquear un worker sobre un mutex contendido puede paralizar todo el runtime, y muestra un trazado donde la contentión de mutex conduce a demoras de planificación del kernel y menor actividad de workers.
`tokio::sync::Mutex` intercambia un problema por otro: es más caro de bloquear y susceptible a problemas sutiles como `FutureLock`, y realmente solo es apropiado si la sección crítica dura múltiples milisegundos. Considera usar canales en su lugar, donde una tarea es propietaria de los datos compartidos y los mensajes de canal denotan mutaciones.
**Limitar el paralelismo—usualmente** Tokio puede generar muchas más tareas que el resto del sistema puede manejar. Abrir accidentalmente miles de conexiones concurrentes es común. La respuesta es aburrida: limitar la concurrencia. Un `Semaphore` suele ser suficiente; los algoritmos adaptativos sofisticados a veces son apropiados pero añaden complejidad.
**Aislar los workers de Tokio de otros hilos** Si el sistema operativo está muy cargado, puede tomar 10–20 ms (o más) al núcleo programar un worker después de que Tokio intenta despertarlo. La latencia P99 en milisegundos de un solo dígito es un desastre. Fijar los workers de Tokio a núcleos CPU dedicados mediante `cgroups` o APIs relacionadas es la solución más básica. El mismo problema puede surgir de hilos de fondo (por ejemplo, `tracing_appender`) que hacen más de 100 ms de trabajo sin ceder la CPU. Mover el trabajo de fondo no crítico a su propio núcleo y reubicar los workers de Tokio a otros núcleos usualmente mejora la latencia.
**Trucos cuando se sabe mejor** En aplicaciones async idealizadas, todo el trabajo ocurre en pequeños bursts con yields frecuentes. El mundo real no siempre funciona de esa manera, y los pequeños bursts no son necesariamente la forma más rápida de ejecutar software. Bajo carga ligera, el work stealing de Tokio puede compensar cuando un worker está ocupado más tiempo de lo usual—pero esto falla cuando el runtime o el OS están muy cargados. En ambos casos, el stealing tarda más, y el mantenimiento del núcleo (como el drive de I/O) puede no ocurrir con suficiente frecuencia para mantener baja latencia.
Bloquear el executor puede ser aceptable bajo carga ligera, pero este consejo no aplica cuando se usa `tokio::join!` o `tokio::select!`, los cuales utilizan concurrencia dentro de una tarea. Dentro de una sola tarea, el bloqueo impide cualquier otro progreso, a veces manifestándose como timeouts inesperados.
El aislamiento más fuerte viene de asignar trabajo a runtimes separados y fijar esos runtimes a núcleos dedicados. Muchos servicios de red tienen tanto trabajo sensible a latencia como trabajo de fondo de menor prioridad; al ponerlos en runtimes separados se crea una frontera de planificación. En TokioConf, la mayoría de los ponentes terminaron moviéndose a una solución con al menos dos runtimes.
**Spinning para mantener el control** El spinning para mantener el control es una táctica muy avanzada para perseguir latencia medida en microsegundos. No es generalmente recomendado.