Un nuevo tipo de modelo de lenguaje se presentó al público a mediados de septiembre de 2026, cuando TypeSafe AI anunció Jev, la primera liberación de lo que la empresa llama su familia de modelos "System One". Jev no chatea, no escribe código ni genera texto abierto. En cambio, recibe entrada no estructurada —documentos, mensajes, estado de programa— y devuelve decisiones tipadas y probabilísticas: clasificaciones, puntuaciones, elecciones de enrutamiento, extracciones. Sus creadores lo presentan como el "momento ChatGPT para la clasificación": un único modelo de propósito general que puede manejar diversas tareas de clasificación a bajo costo, sin el ajuste fino por tarea que ha sido práctica estándar durante mucho tiempo.
El lanzamiento se acompaña de una retrospectiva técnica de Sebastian Raschka que recorre la historia de la clasificación de texto —desde bag-of-words y naive Bayes hasta redes neuronales recurrentes y convolucionales y los transformers modernos— para enmarcar qué cambia Jev y qué no.
## De bag-of-words a decisiones calibradas
El artículo de Raschka comienza con la era bag-of-words, donde los textos se reducían a vectores de conteo de palabras de tamaño fijo alimentados a naive Bayes, regresión logística o XGBoost. El enfoque es rápido e interpretable, pero descarta el orden de las palabras: "the dog bites the man" y "the man bites the dog" se convierten en vectores idénticos. Los n-gramas pueden recuperar algo de estructura local a costa de una explosión del vocabulario.
El aprendizaje profundo introdujo los word embeddings —vectores densos que representan palabras individuales— permitiendo que las redes neuronales recurrentes (RNNs) y las redes neuronales convolucionales (CNNs) modelaran secuencias y contexto local. Las RNNs procesan tokens paso a paso, manteniendo un estado oculto que resume el historial; las LSTMs y GRUs añadieron compuertas para mitigar gradientes que desaparecen. Las CNNs deslizan filtros aprendidos sobre ventanas de embeddings adyacentes y luego hacen pooling a representaciones de tamaño fijo. Ambas arquitecturas precedieron a los transformers, pero eran más difíciles de entrenar y menos paralelizables.
El artículo de ULMFiT de 2018 demostró que pre-entrenar una RNN en corpus grandes y luego ajustar finamente podía alcanzar un 95,4 % de exactitud en el benchmark de sentimiento IMDb, muy por encima del 85,7 % de una LSTM desde cero y el 89,9 % de la regresión logística bag-of-words. El aprendizaje por transferencia se convirtió en el paradigma dominante, culminando en modelos basados en transformers como BERT y la serie GPT.
## En qué Jev es diferente
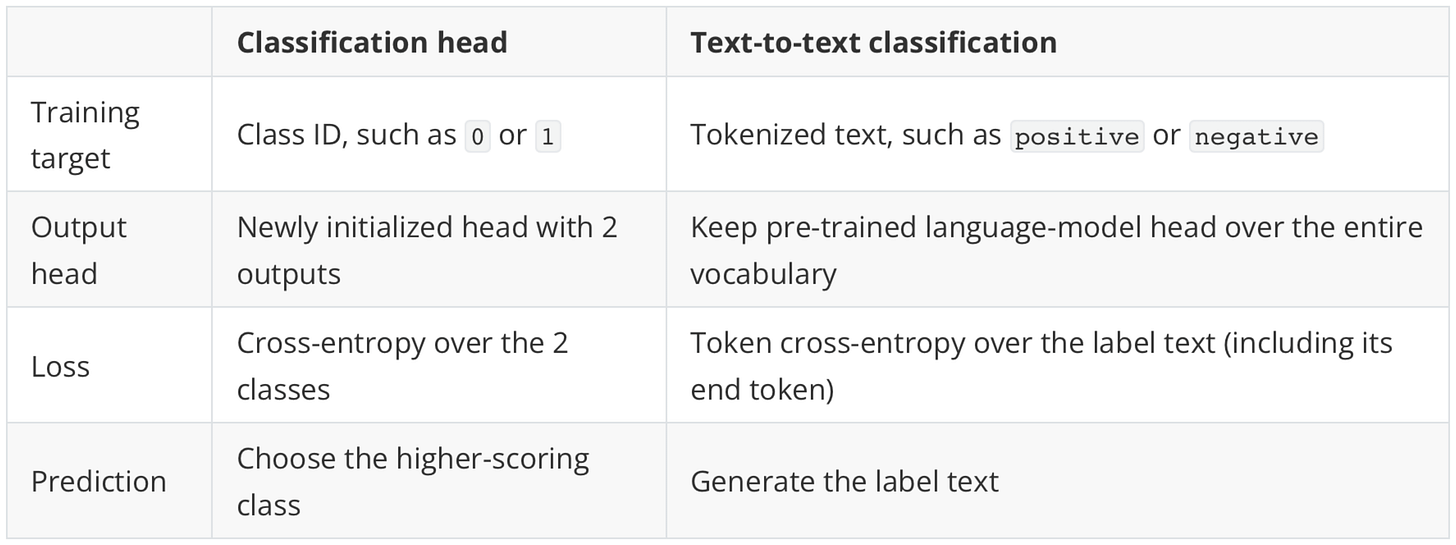
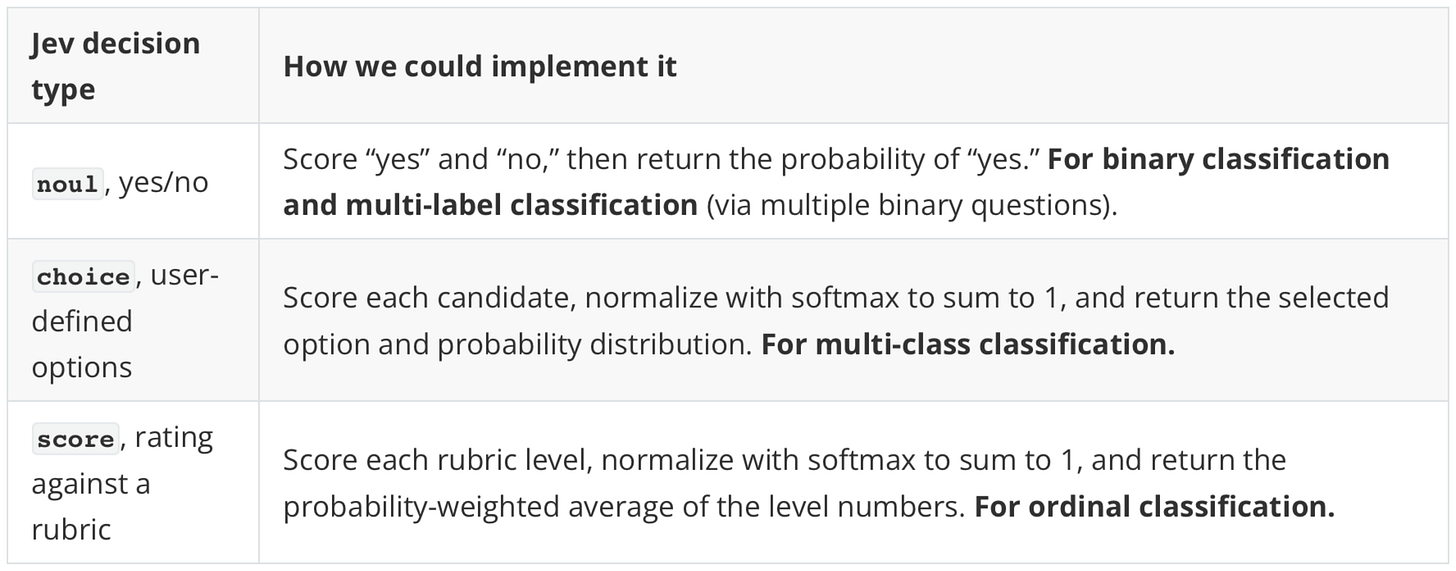
El anuncio de TypeSafe presenta a Jev como una ruptura con el paradigma LLM en varias dimensiones, empezando por su espacio de salida: Jev emite valores estructurados y tipados —clases, puntuaciones, indicadores booleanos— definidos de antemano. No puede producir cadenas libres, lo que elimina las alucinaciones y los errores de análisis por construcción.
El anuncio de TypeSafe presenta a Jev como una ruptura con el paradigma LLM en varias dimensiones:
Mientras que los LLM generan tokens secuencialmente (3–329 segundos de extremo a extremo para modelos frontier), Jev calcula todas las probabilidades de salida en paralelo, completando en 70–500 milisegundos. Sus tokens de entrada cuestan $0,042 por millón frente a $0,20–$10 para LLM, y los tokens de salida se describen como demasiado baratos para medirlos porque el modelo no genera secuencias de longitud variable.
- **Espacio de salida**: Jev emite valores estructurados y tipados —clases, puntuaciones, indicadores booleanos— definidos de antemano. No puede producir cadenas libres, lo que elimina las alucinaciones y los errores de análisis por construcción. - **Muestreo**: Mientras que los LLM generan tokens secuencialmente (3–329 segundos de extremo a extremo para modelos frontier), Jev calcula todas las probabilidades de salida en paralelo, completando en 70–500 milisegundos. - **Objetivo de entrenamiento**: En lugar de Reinforcement Learning from Human Feedback (RLHF) o Verifiable Rewards (RLVR), TypeSafe desarrolló Reinforcement Learning for Calibrated Decisions (RLCD). El objetivo son "probabilidades epistémicamente honestas": cuando Jev asigna un 90 % de confianza, debería acertar aproximadamente el 90 % de las veces, y entradas similares deberían producir distribuciones de confianza similares. - **Economía**: Los tokens de entrada cuestan $0,042 por millón (frente a $0,20–$10 para LLM); los tokens de salida se describen como "demasiado baratos para medirlos" porque el modelo no genera secuencias de longitud variable.
Raschka señala que Jev se sitúa entre dos extremos: los LLM de propósito general que pueden clasificar pero son lentos y caros, y los clasificadores especializados estrechos que son más rápidos y baratos para una sola tarea pero carecen de generalidad. La propuesta de Jev es amplitud a velocidad: un modelo para enrutamiento, puntuación, extracción, verificaciones de guardarraíl y ramas de decisión en tiempo real.
## La calibración como habilitador de la automatización
La afirmación de calibración es central para el argumento de automatización. Los LLM convencionales, incluso cuando se les pide confianza, tienden a ser sobreconficientes e inconsistentes. Si un modelo acierta el 95 % de las veces pero no puede señalar en cuál de los 5 % fallará, el software aguas abajo no puede actuar sobre su salida de forma segura sin revisión humana. El entrenamiento RLCD de Jev optimiza explícitamente la fiabilidad de las probabilidades reportadas, no solo la exactitud top-1.
La demostración comparativa de TypeSafe ilustra la diferencia arquitectónica: Jev devuelve una distribución completa de probabilidades sobre claves predefinidas en un solo paso hacia adelante, mientras que un LLM generaría un objeto JSON token por token. El diseño paralelo también significa que la latencia escala con el tamaño del modelo, no con la longitud de la salida.
## Alcance y limitaciones
Ambas fuentes son cuidadosas con los límites. Raschka enfatiza que para un problema estrecho y bien definido, un clasificador especializado probablemente superará a Jev en exactitud, velocidad y costo. El valor de Jev es la generalidad: "mucho más general que esos modelos específicos de tarea." TypeSafe reconoce que la sostenibilidad del precio a largo plazo no está demostrada y que los números de latencia publicados provienen de portátiles de la Costa Oeste conectados a su región de servicio actual.
El modelo está en acceso temprano. No se proporcionaron benchmarks independientes ni evaluaciones de terceros en el paquete de origen. La referencia de arXiv (Raschka, 2014) ofrece contexto histórico sobre naive Bayes pero no afecta al rendimiento de Jev.
## Por qué la comunidad técnica reacciona
El indicador de discusión adjunto al envío en Hacker News captura un tema recurrente: desarrolladores que han pasado años construyendo clasificadores por tarea ven en Jev un posible punto de inflexión: un modelo, sin ajuste fino, salida estructurada inmediata. La analogía con el impacto de ChatGPT en la generación de texto es explícita: una herramienta de propósito general que elimina el paso de ingeniería a medida para una amplia clase de problemas.
Si Jev cumple esa promesa a escala queda por validar. Pero las decisiones arquitectónicas —salida estructurada paralela, probabilidades calibradas, decisiones de esquema fijo— representan una alternativa coherente al paradigma LLM dominante para el subconjunto de cargas de trabajo de IA que son fundamentalmente de clasificación.