Hister es un motor de búsqueda autohospedado que construye un índice personal a partir de las páginas web que visitas, tu historial y marcadores del navegador, archivos locales y sitios web que eliges rastrear. A diferencia de los motores de búsqueda tradicionales que consultan la web en vivo, Hister almacena el contenido del documento extraído junto con su índice de búsqueda en un servidor que tú ejecutas, de modo que la información sigue siendo localizable incluso si la página original cambia o desaparece.
## Cómo funciona
Ejecutas el servidor Hister localmente o en una máquina que controles. Una extensión de navegador para Firefox o Chrome puede indexar automáticamente las páginas a medida que las visitas. También puedes importar el historial y marcadores del navegador existentes, monitorear directorios locales en busca de nuevos archivos, o rastrear sitios web específicos. El servidor extrae texto de HTML, PDF y otros formatos admitidos, y luego indexa el contenido completo, no solo títulos y URLs.
El mismo índice se puede buscar a través de múltiples interfaces: una interfaz web en `http://127.0.0.1:4433`, una interfaz de terminal (TUI), herramientas de línea de comandos, una API HTTP y un endpoint MCP (Model Context Protocol) que permite a los asistentes de IA recuperar resultados directamente.
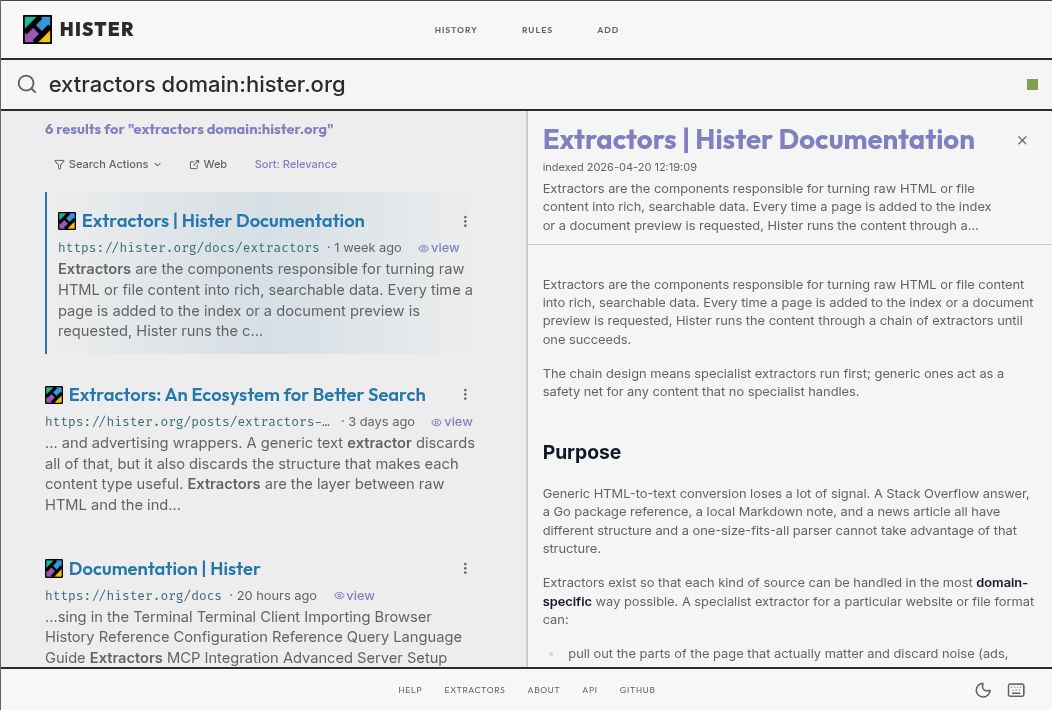
This image shows the Hister web user interface at http://127.0.0.1:4433, where users can search their indexed pages and files, view readable previews of stored content, and navigate results without leaving the search interface.
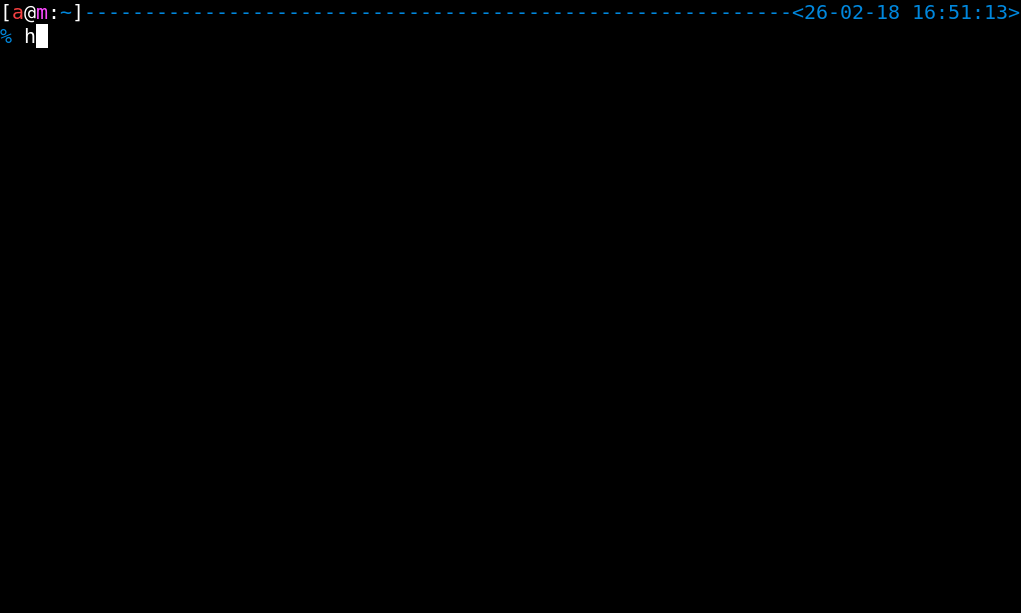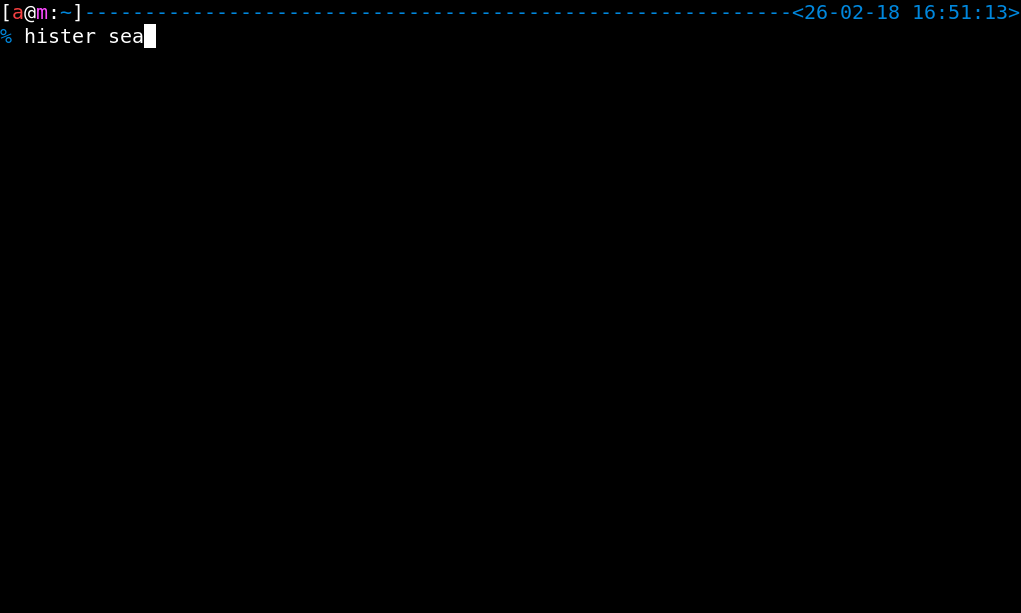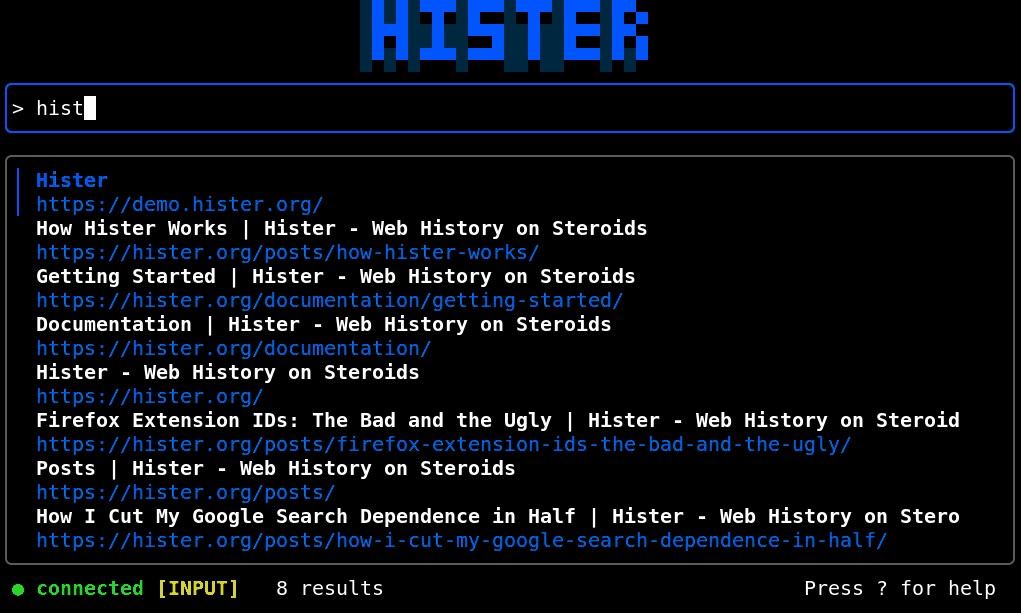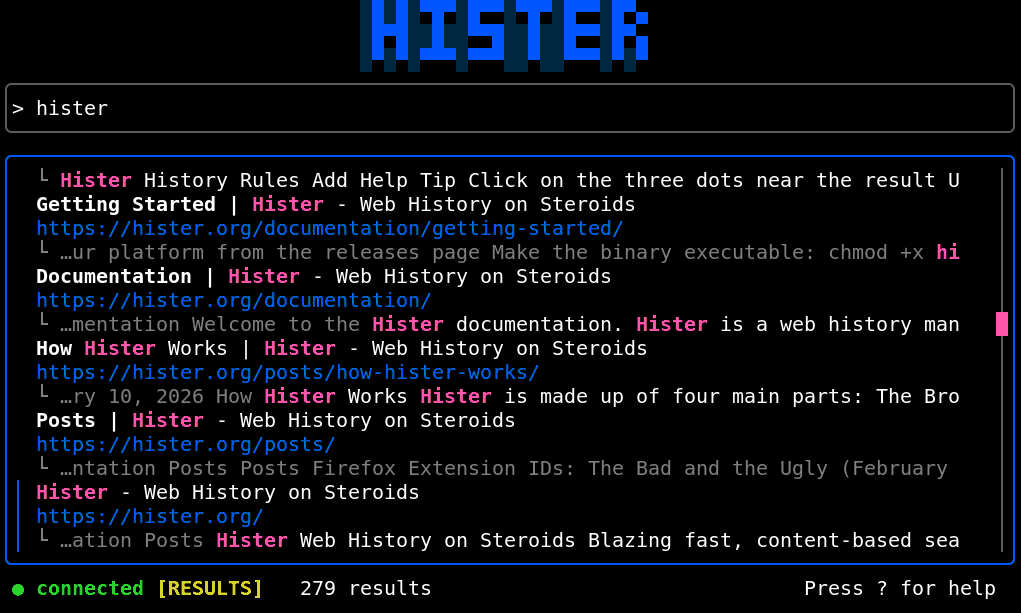
This animated gif illustrates the Hister terminal user interface, which provides a keyboard‑driven way to search the personal index, browse results, and access the same functionality as the web UI from a command line.
## Capacidades de búsqueda
Hister admite un lenguaje de consultas rico más allá de las palabras clave simples:
- **Filtros de campos** para buscar dentro de atributos específicos como `url:`, `title:` o `domain:` - **Frases entre comillas** para coincidencias exactas - **Comodines y negación** (por ejemplo, `python -snake`) - **Rangos de fechas** para acotar por cuándo se indexó una página - **Alias de consultas** para consultas complejas reutilizables - **Prioridades de resultados** para elevas ciertas fuentes
La búsqueda semántica opcional permite encontrar documentos por significado en lugar de términos exactos. Esto envía el texto del documento a un endpoint de embeddings que configuras, como un modelo local a través de Ollama o una API remota, para que puedas habilitarlo o deshabilitarlo según tus preferencias de privacidad.
## Manejo de contenido y vistas previas
Cuando Hister indexa una página, almacena el contenido extraído junto con el índice de búsqueda. Los resultados de búsqueda muestran una vista previa limpia y legible de ese contenido almacenado junto con la URL original, para que puedas verificar la coincidencia sin salir de la interfaz de búsqueda. Como el contenido se almacena localmente, sigue siendo accesible incluso si la página original se edita más tarde, se convierte en de pago o se elimina por completo.
Las reglas de indexación te dan control sobre qué se indexa y cómo se clasifica. Las reglas de omisión excluyen URLs o patrones coincidentes. Las reglas de prioridad elevan los resultados de fuentes preferidas. El seguimiento de versiones puede conservar versiones anteriores de un documento cuando cambia. Las comprobaciones de contenido sensible pueden marcar o excluir material que coincida con patrones que defines.
## Modelo de privacidad
Hister no tiene telemetría ni realiza solicitudes de red externos por defecto. La extensión del navegador envía el contenido de la página solo al servidor Hister que configuras (además de obtener los favicons de las páginas). El servidor almacena documentos e índices localmente. La búsqueda semántica opcional envía texto al endpoint de embeddings que elijas. Toda la pila puede ejecutarse en una sola máquina sin dependencia de la nube. El código fuente está licenciado bajo AGPLv3.
## Opciones de implementación
Un único binario se ejecuta en Linux, macOS o Windows sin necesidad de configuración para una instalación personal. Para servidores compartidos, Hister admite múltiples usuarios con aislamiento de documentos por usuario, usando SQLite o PostgreSQL como backend. Hay paquetes Docker y Nix disponibles. El desarrollo requiere Go 1.26, npm y un compilador C para las dependencias CGO.
## Contexto y limitaciones
El autor del proyecto creó anteriormente Searx, un motor de metabúsqueda respetuoso con la privacidad, pero pasó a un enfoque de índice personal después de encontrarse con las limitaciones del modelo de metabúsqueda. Chrome incluyó una función de búsqueda de historial de texto completo desde 2008 hasta 2013 antes de eliminarla.
Las limitaciones actuales señaladas por los usuarios incluyen: la extensión del navegador indexa todas las páginas visitadas por defecto (una mejora sugerida es un umbral de tiempo de permanencia, por ejemplo, indexar solo páginas vistas durante 4+ segundos), y el software aún no está empaquetado en los repositorios de distribuciones Linux principales, lo que algunos usuarios citan como una barrera de implementación. La integración MCP es relativamente nueva y su utilidad práctica con varios asistentes de IA aún está siendo explorada por la comunidad.