Kev es una familia de código abierto de modelos de decisiones pequeños basados en Qwen3.5, diseñados para ejecutarse de forma local o en un punto final administrado por el usuario. El proyecto ofrece variantes de 0,8B, 4B y 9B, código de entrenamiento, datos de evaluación y una API compatible con la interfaz System One de TypeSafe.
El sistema responde a varios tipos de preguntas en una sola solicitud: decisiones de sí o no, enrutamiento de opción múltiple y calificaciones numéricas. Las preguntas comparten el mismo texto de entrada, pero no pueden leerse entre sí; así, un ticket de soporte puede enrutarse, revisarse para determinar si requiere escalado y recibir una puntuación de frustración sin que las respuestas dependan unas de otras.
El repositorio también ofrece una vía local práctica. Documenta compatibilidad con CUDA, ROCm y Apple Silicon, y señala que los modelos de 4B y 9B caben en un Mac de 32 GB. El servidor de ejemplo se enlaza a localhost de forma predeterminada, mientras que se puede exigir una clave de API para el acceso remoto.
La evidencia más clara es la propia tabla de evaluación del proyecto. En «fuentes nuevas», las precisiones de prueba reportadas son 0,684 para Kev-0.8B, 0,837 para Kev-4B y 0,852 para Kev-9B; también se reportan puntuaciones de Brier más bajas para los modelos más grandes. Estos son resultados reportados por el editor, no una validación independiente.
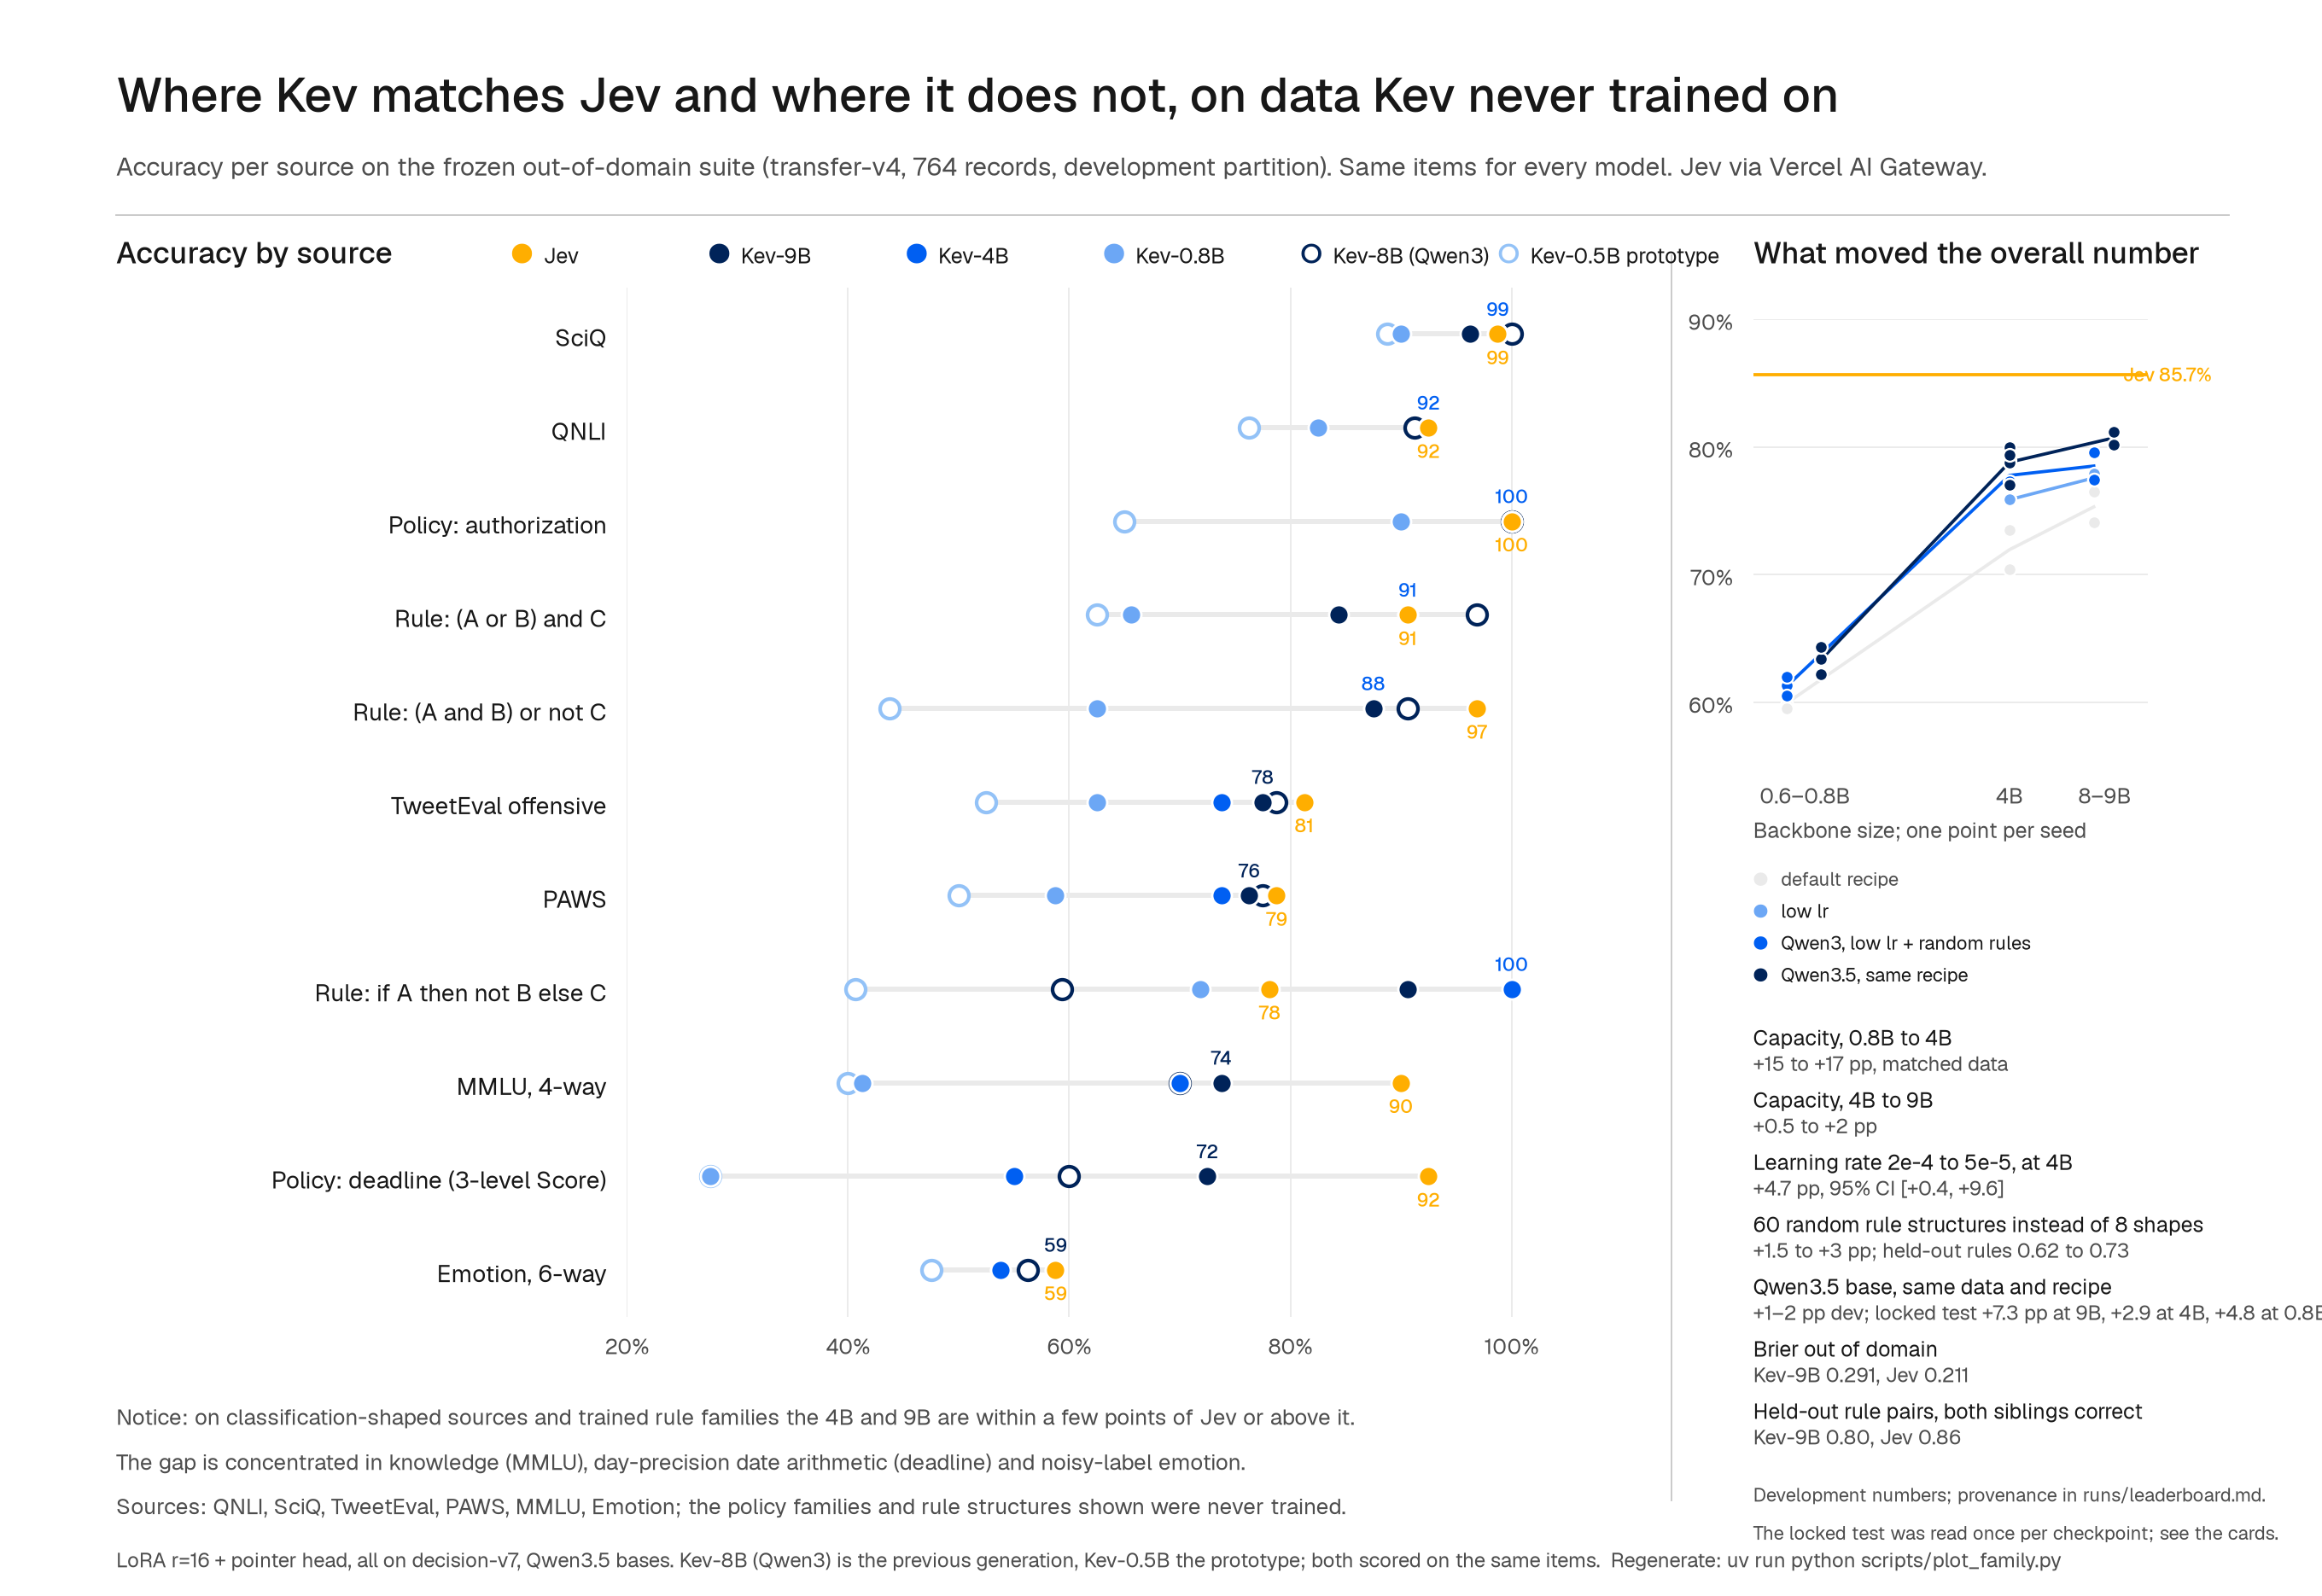
El artículo analiza la tabla de evaluación reportada por el proyecto y los límites de comparar Kev con Jev; este gráfico visualiza directamente esos resultados específicos de cada fuente.
El README advierte que la comparación con Jev no está controlada porque se desconocen los conjuntos de datos de entrenamiento de Jev. Esto es importante para quienes evalúan Kev frente a sistemas similares: el paquete respalda el diseño declarado de Kev y sus puntos de referencia autoinformados, pero no una afirmación definitiva de que sea más preciso que Jev en términos generales.