Kage es un proyecto de código abierto para la línea de comandos que aborda la preservación web convirtiendo un sitio activo en una copia estática y accesible sin conexión. Su creador describe un proceso en el que Chrome sin interfaz renderiza cada página, se captura el DOM terminado, se eliminan los scripts y se reescriben las rutas de CSS, imágenes y fuentes para que apunten a recursos locales. La afirmación central del repositorio es que las páginas resultantes tienen el mismo aspecto que el sitio activo, pero no ejecutan JavaScript ni realizan solicitudes de red.
Esta distinción es importante porque guardar una página con un navegador convencional puede conservar el marcado fuente sin reproducir la página después de que se haya producido el renderizado del lado del cliente. Kage, en cambio, espera a que la página se estabilice antes de tomar la instantánea. En la práctica, la herramienta intenta preservar el estado renderizado que ve el lector, en lugar de limitarse al HTML devuelto inicialmente por el servidor. Esto resulta útil para documentación, ensayos, tutoriales y otros sitios relativamente estáticos cuyo valor reside en el contenido y no en su comportamiento interactivo.
El proyecto documenta un flujo de trabajo sencillo: `kage clone` crea una copia navegable, `kage serve` permite previsualizarla localmente y `kage pack` comprime la copia en un único archivo. El comando clone puede limitar el número de páginas y la profundidad del rastreo, seguir prefijos de ruta seleccionados, incluir subdominios, desplazar las páginas para activar recursos de carga diferida y reanudar el proceso tras una interrupción. La documentación también indica que el rastreador lee `robots.txt` y obtiene el trabajo inicial de `sitemap.xml`, aunque las opciones permiten modificar esos valores predeterminados.
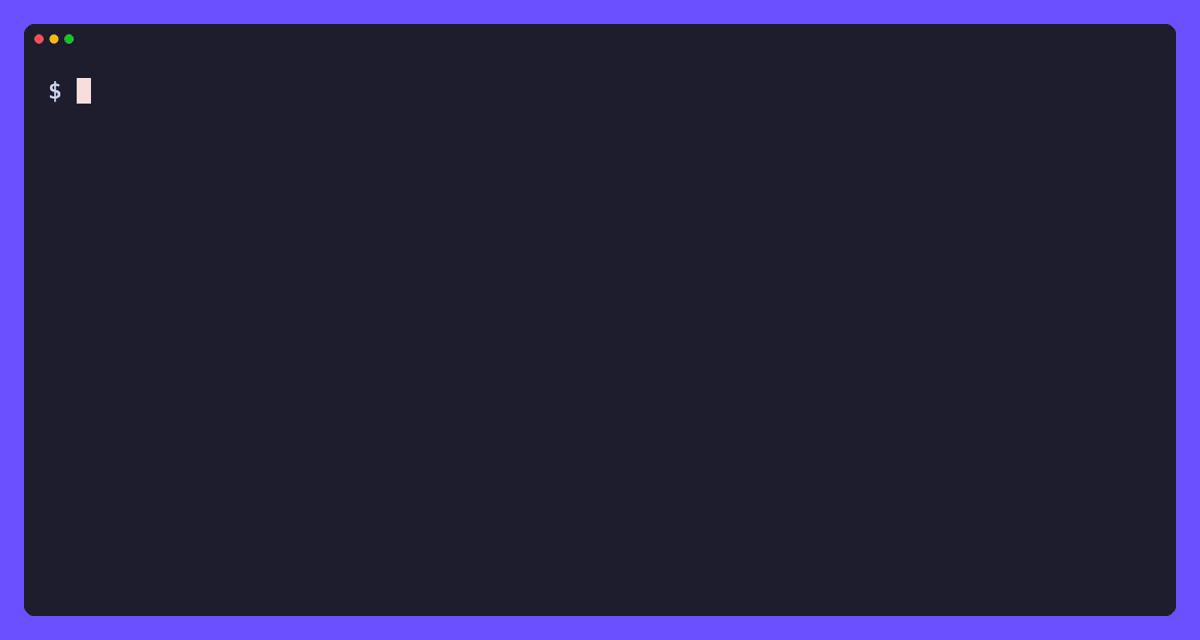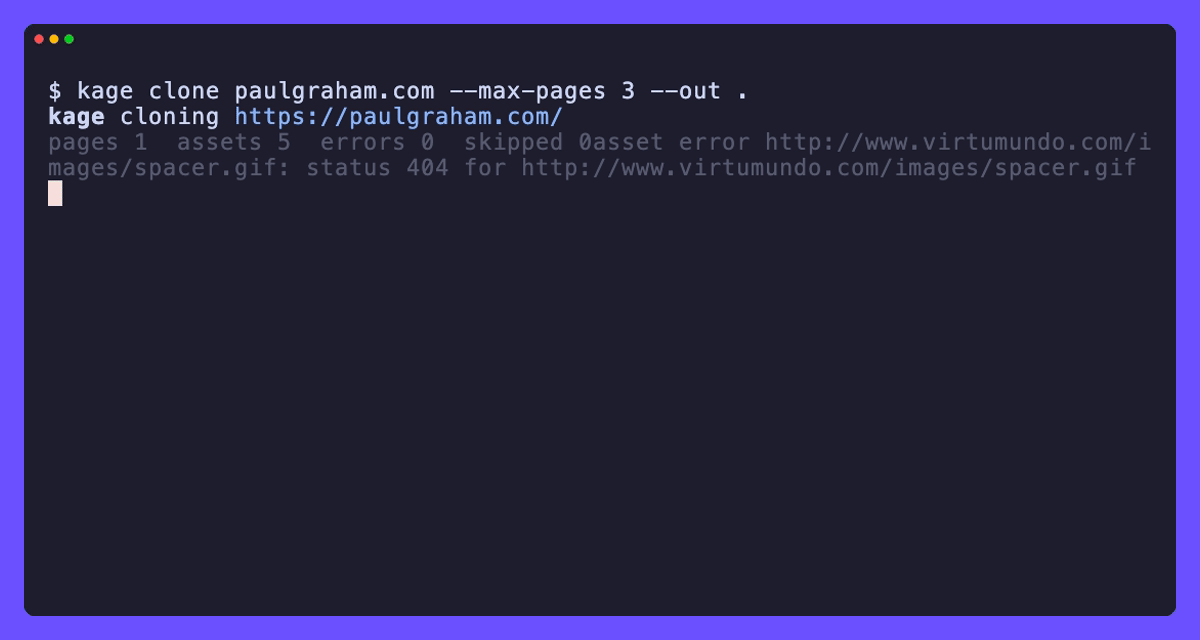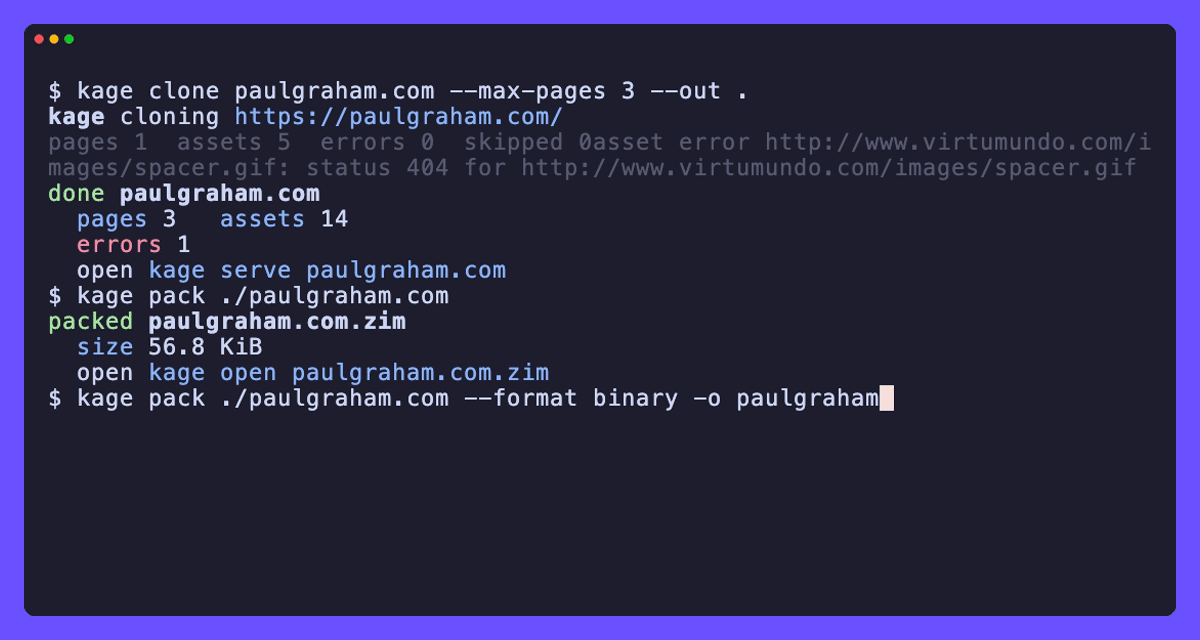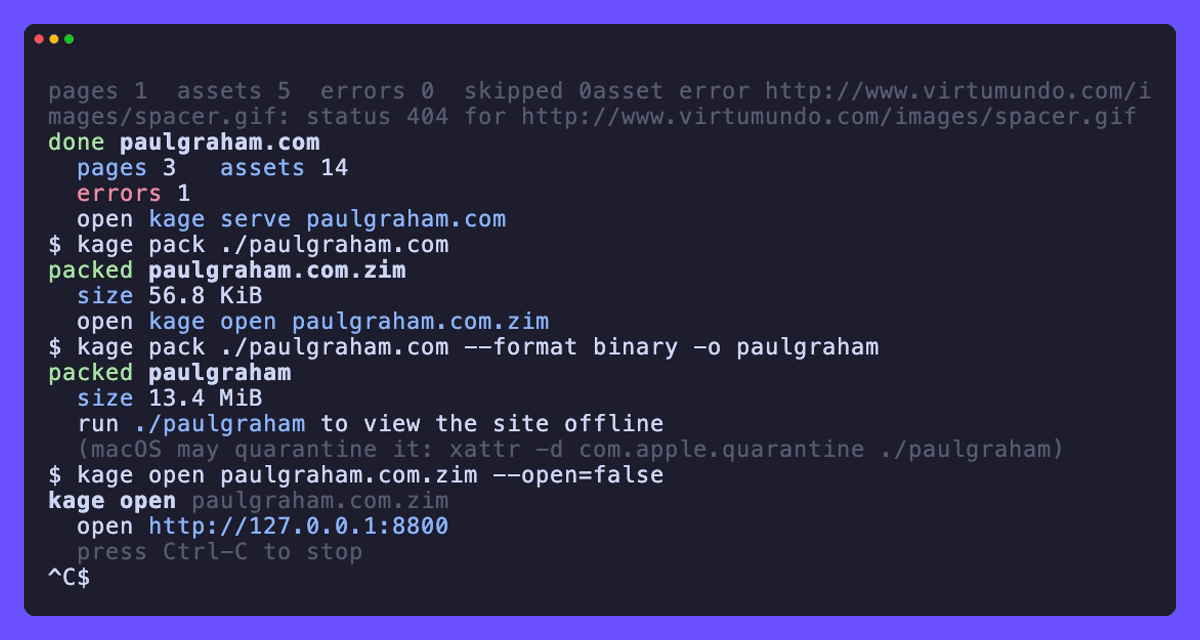
La demostración sigue el flujo documentado de clonación, empaquetado y servicio descrito en el artículo, y muestra el sitio resultante funcionando sin su conexión activa original. Crédito: github.com.
Para su transporte y acceso a largo plazo, Kage puede generar un archivo ZIM, un formato utilizado por el ecosistema de contenidos sin conexión de Kiwix. El repositorio afirma que el texto se comprime con Zstandard, mientras que los elementos multimedia se conservan sin pasar por ese paso de compresión. También señala que el mismo archivo puede abrirse mediante herramientas o aplicaciones de Kiwix, aunque Kage no crea el índice de búsqueda de texto completo incluido en algunos paquetes de Kiwix. Esta limitación significa que la navegación puede seguir siendo funcional, incluso cuando la búsqueda dentro del lector es menos eficaz que en archivos creados específicamente para ese fin.
Una segunda opción de empaquetado añade el archivo al final de un ejecutable de Kage y produce un único archivo capaz de servir el sitio sin requerir Kage, un lector de ZIM ni ninguna otra instalación. La contrapartida es el tamaño: el repositorio estima unos 13 MiB para el visor antes de añadir el propio sitio. Las compilaciones opcionales pueden abrir el resultado en una ventana nativa mediante WebViews de la plataforma, mientras que la compilación predeterminada escrita íntegramente en Go abre el navegador del sistema. Estas son opciones de implementación documentadas por el proyecto, no garantías independientes para todos los sistemas operativos ni versiones futuras de los navegadores.
La captura ilustra el ejecutable empaquetado opcional y el método de visualización mediante WebView nativa descritos en el artículo. Crédito: github.com.
La afirmación sobre la eliminación de scripts debe interpretarse con precisión. El repositorio proporcionado describe la eliminación del JavaScript del resultado capturado y la localización de los recursos enlazados; no demuestra que todos los sitios web puedan preservarse de manera fiel. Los formularios, la autenticación, la transmisión de contenido multimedia, las acciones dependientes del servidor, el contenido incrustado de terceros y las funciones que requieren API activas pueden estar ausentes, deteriorados o reducidos a su último estado renderizado. Por lo tanto, una instantánea puede conservar el aspecto y el contenido legible sin preservar el comportamiento de la aplicación original.
Las pruebas tampoco muestran cómo gestiona Kage los derechos de autor, las condiciones del servicio, los muros de pago, los datos privados o los controles de acceso específicos de cada sitio. La configuración de rastreo de la documentación describe un comportamiento técnico, no un permiso legal. Los lectores deben considerar la herramienta como una forma de crear copias autorizadas de material al que tienen derecho a acceder y evaluar por separado las normas aplicables a cada fuente.
La idea mejor respaldada por la documentación de Kage es la separación: permitir que un navegador real produzca la página visible y conservar después una representación estática que ya no dependa del JavaScript del sitio original. Sus limitaciones son igual de importantes. El archivo registra un rastreo realizado en un momento concreto, dentro de unos límites configurados, y no puede demostrar que se hayan capturado contenidos dinámicos, estados ocultos o versiones futuras del sitio. Para el tipo adecuado de sitio web, puede ser una vía práctica para la lectura sin conexión; para una aplicación web completa, es una instantánea, no una réplica funcional.