Transformer Explainer comienza con una pregunta práctica: ¿cómo puede un modelo de texto generar un token sin dejar de tener en cuenta los tokens anteriores? La respuesta no es que comprima toda la conversación en un único resumen fijo. En la arquitectura al estilo de GPT, exclusiva del decodificador, que se muestra en la página, cada token conserva una representación, y las capas intercambian y transforman información entre esas representaciones repetidamente antes de que el modelo prediga el siguiente token.
La primera etapa convierte el prompt en números que la red puede procesar. Un tokenizador divide el texto en palabras o subpalabras; cada token recibe un vector de embedding, y una codificación posicional añade información sobre su lugar en la secuencia. Para el modelo GPT-2 small que utiliza el explicador, la página describe un vocabulario de 50.257 tokens, vectores de tokens de 768 dimensiones y 12 bloques Transformer apilados. Esas son propiedades de este modelo didáctico, no constantes compartidas por todos los modelos de lenguaje modernos.
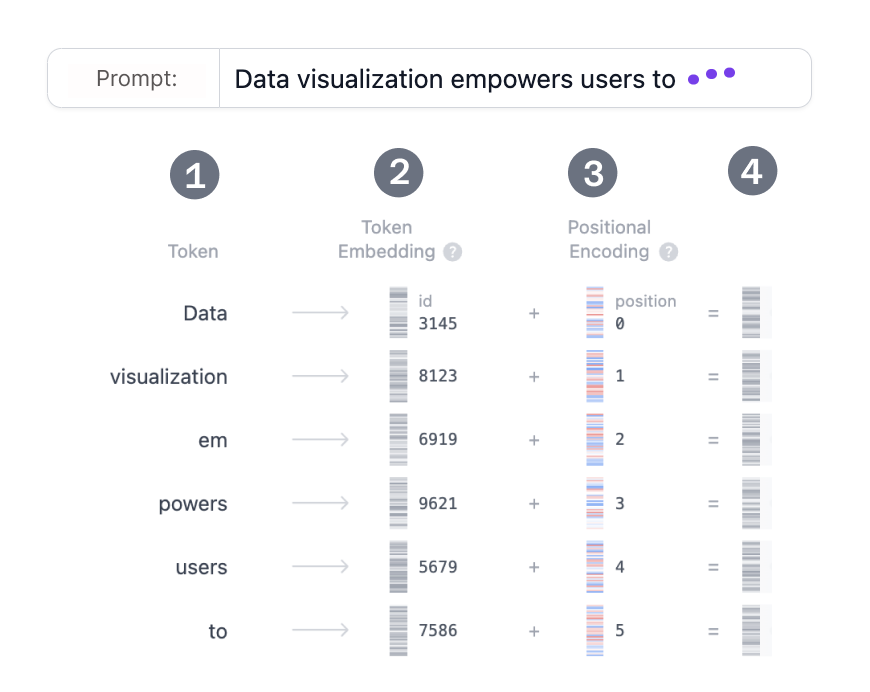
Situado después de la explicación de la tokenización, los vectores de embedding, la codificación posicional y las dimensiones del modelo GPT-2.
Dentro de cada bloque, la autoatención multi-cabezal permite que la representación de un token incorpore información de otros tokens. El modelo deriva vectores de consulta, clave y valor mediante pesos aprendidos. Las comparaciones entre consultas y claves producen puntuaciones de atención; una máscara causal impide que un decodificador utilice tokens futuros al predecir el siguiente token actual; la función softmax convierte las puntuaciones escaladas en pesos; y una combinación ponderada de vectores de valor se transmite a la siguiente etapa. Varios cabezales dividen los vectores en subespacios que pueden aprender distintas relaciones, aunque la analogía con la búsqueda web de la página no debe confundirse con una descripción literal de lo que representa un cabezal concreto cualquiera.
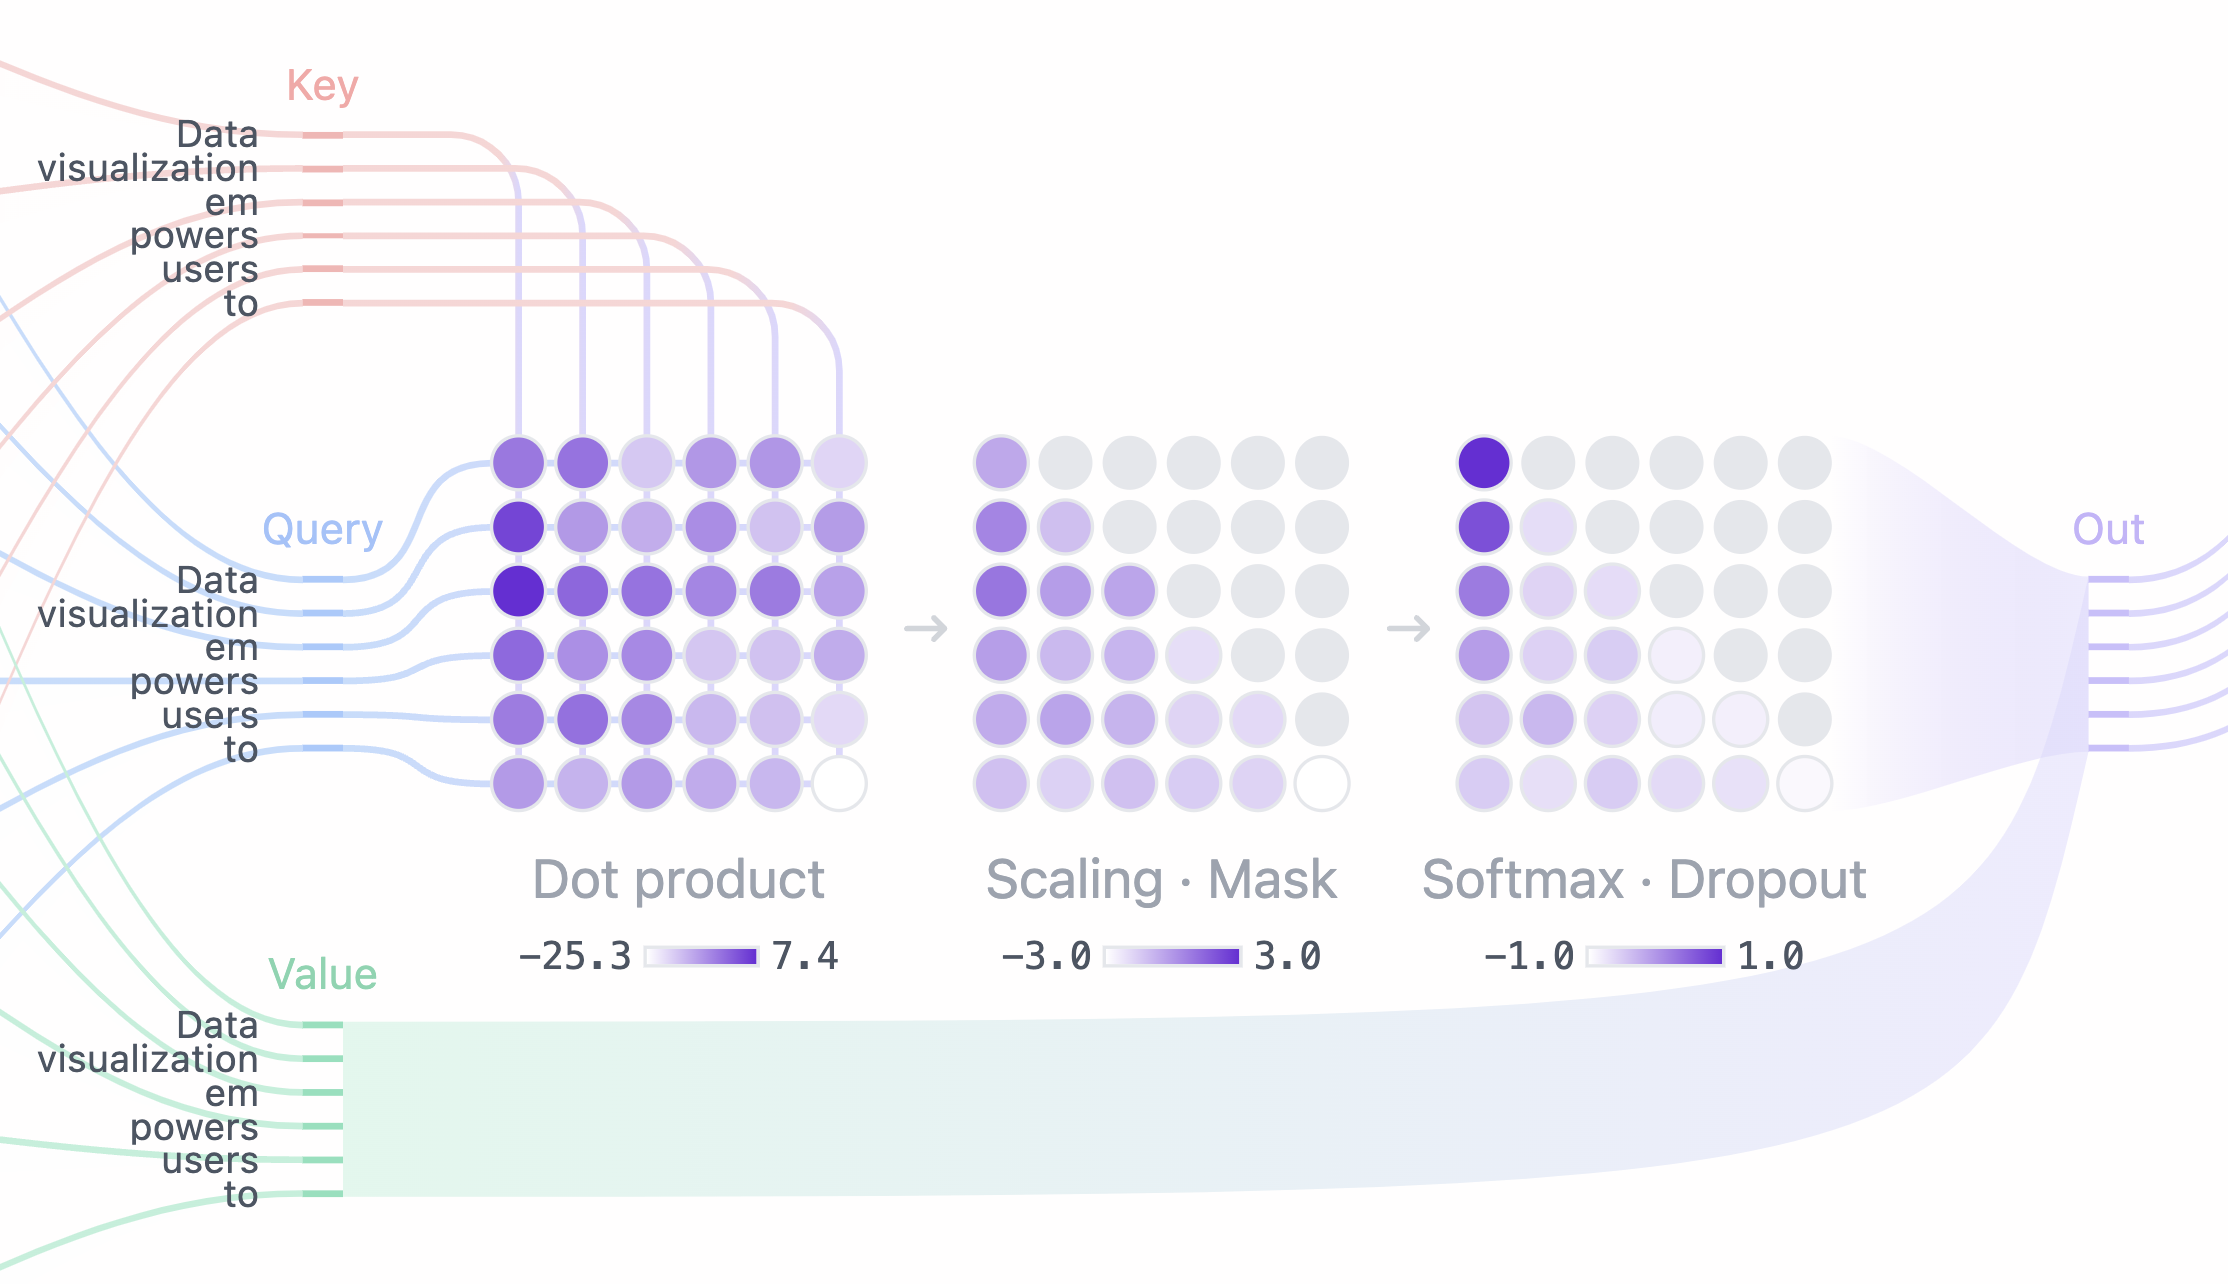
Situado después de la explicación de los vectores de consulta, clave y valor, la máscara causal, los pesos de atención y los múltiples cabezales de atención.
La atención es solo la mitad del bloque estándar descrito por el explicador. Su salida pasa por un perceptrón multicapa, o MLP, que aplica transformaciones aprendidas a cada representación de token de forma independiente. El ejemplo de GPT-2 amplía cada representación de 768 dimensiones hasta 3.072 dimensiones, aplica la no linealidad GELU y la proyecta de nuevo a 768 dimensiones. La alternancia de operaciones de atención y MLP es importante: la información reunida desde otras posiciones puede transformarse localmente y luego ponerse a disposición de capas de atención posteriores. Esta mezcla repetida es la razón de que un vector aparentemente plano en un punto no implique que el modelo haya descartado permanentemente el resto del contexto.
Después del bloque final, una capa lineal produce un logit por cada token del vocabulario, y la función softmax convierte esos logits en una distribución de probabilidad. El muestreo selecciona el siguiente token; después, este se añade a la secuencia y el proceso continúa. La temperatura modifica la nitidez de esa distribución, mientras que el muestreo top-k y top-p restringe el conjunto de candidatos. Estos controles afectan a la previsibilidad y la diversidad; por sí solos, no establecen que una salida sea segura, veraz o creativa.
Un límite útil es arquitectónico, no cosmético. La documentación técnica de Hugging Face distingue el Transformer original de codificador-decodificador de los modelos exclusivamente de codificador, como BERT, y los modelos exclusivamente de decodificador, como GPT-2. También explica que los transformers de audio suelen añadir un adaptador de entrada: un codificador convolucional de características puede convertir una forma de onda o un espectrograma en secuencias de embeddings antes de que el Transformer los procese. Esto respalda la idea más amplia de que «Transformer» designa una familia arquitectónica reutilizable cuyas entradas, máscaras y cabezales de salida varían según la tarea. No demuestra que todos los sistemas de audio o lenguaje utilicen exactamente el flujo de GPT-2 visualizado por la demostración.
El repositorio de la página interactiva identifica el software como una herramienta de aprendizaje basada en el navegador que ejecuta un modelo GPT-2 en vivo y lo vincula con un artículo de CHI de 2026. Por tanto, el repositorio corrobora la implementación y la autoría del proyecto, pero no constituye evidencia independiente de que la visualización sea la explicación más clara posible ni de que sus analogías sean universalmente válidas. Del mismo modo, las afirmaciones del explicador sobre lo que hace la atención son descripciones de la arquitectura demostrada, no pruebas experimentales sobre los conceptos internos aprendidos por todos y cada uno de los cabezales de atención de un Transformer.
Para los lectores que intentan comprender un modelo de lenguaje, el modelo mental más productivo es una secuencia de transformaciones contextuales, no una búsqueda en un párrafo comprimido. La atención determina cómo se combinan las representaciones en una capa determinada; el MLP las transforma; las conexiones residuales y la normalización ayudan a entrenar el cálculo apilado; y la capa de salida convierte las representaciones finales en probabilidades del siguiente token. Las funciones exactas aprendidas por pesos o cabezales individuales siguen dependiendo del modelo y la tarea, así que la visualización explica el cálculo sin explicar por completo por qué un modelo concreto produce una respuesta concreta.