Al evaluar agentes de programación, Unreal Labs plantea una pregunta fácil de pasar por alto: ¿qué parte de la factura corresponde al modelo y qué parte al software que decide cuándo debe razonar, esperar o llamar a una herramienta? La presentación de Unreal Agent realizada por la empresa el 22 de septiembre de 2026 sostiene que los bucles convencionales de los agentes dedican una cantidad considerable de tiempo y tokens a gestionar llamadas a herramientas en lugar de realizar el trabajo subyacente.
La respuesta propuesta es un marco de trabajo asíncrono. Según Unreal Labs, cada llamada a una herramienta se registra de inmediato como en curso mientras su ejecución continúa en segundo plano. En lugar de consultar repetidamente si la operación ha terminado, el modelo puede recibir otra instrucción de control, emitir llamadas adicionales a herramientas o continuar con otros trabajos. Cuando una operación finaliza, su resultado se añade al registro de la sesión y se invoca de nuevo al modelo. La empresa afirma que esto reduce tanto la espera como el número de turnos del modelo necesarios para completar una tarea.
Esta es una afirmación sobre el marco de trabajo, no una prueba de que todos los agentes que lo utilicen resulten más baratos. Unreal Labs atribuye los ahorros a dos decisiones de diseño: una huella relativamente pequeña de herramientas y mensajes, y un trabajo de las herramientas más útil entre las invocaciones del modelo. El repositorio publicado en GitHub aporta respaldo material a la descripción arquitectónica. Identifica un almacén de sesiones de solo anexiones, un coordinador, un traductor de herramientas que no debe bloquear el bucle de eventos y un administrador de operaciones responsable de la ejecución asíncrona. También describe operaciones persistentes y serializables, además de la recuperación de sesiones, lo que sugiere que el diseño pretende ir más allá de una demostración basada únicamente en memoria.
Los resultados comparativos explican por qué la idea atrajo atención, pero exigen una lectura cuidadosa. En Terminal-Bench 4.0, Unreal Agent y Codex obtuvieron una tasa de aprobación del 57,9 %, mientras que Unreal Agent costó 1.428 dólares en los ensayos comunicados, frente a 2.350 dólares de Codex. Pi obtuvo un 55,0 % y costó 1.827 dólares. En SWE-Atlas Codebase QnA, Unreal Agent alcanzó un 65,8 % con un coste de 936 dólares, frente al 63,3 % y 1.303 dólares de Codex y al 64,0 % y 1.033 dólares de Pi. Estas cifras respaldan la conclusión más limitada de que esta implementación fue menos costosa que las referencias indicadas en esas ejecuciones y, al mismo tiempo, obtuvo una tasa de aprobación medida similar o algo mayor.
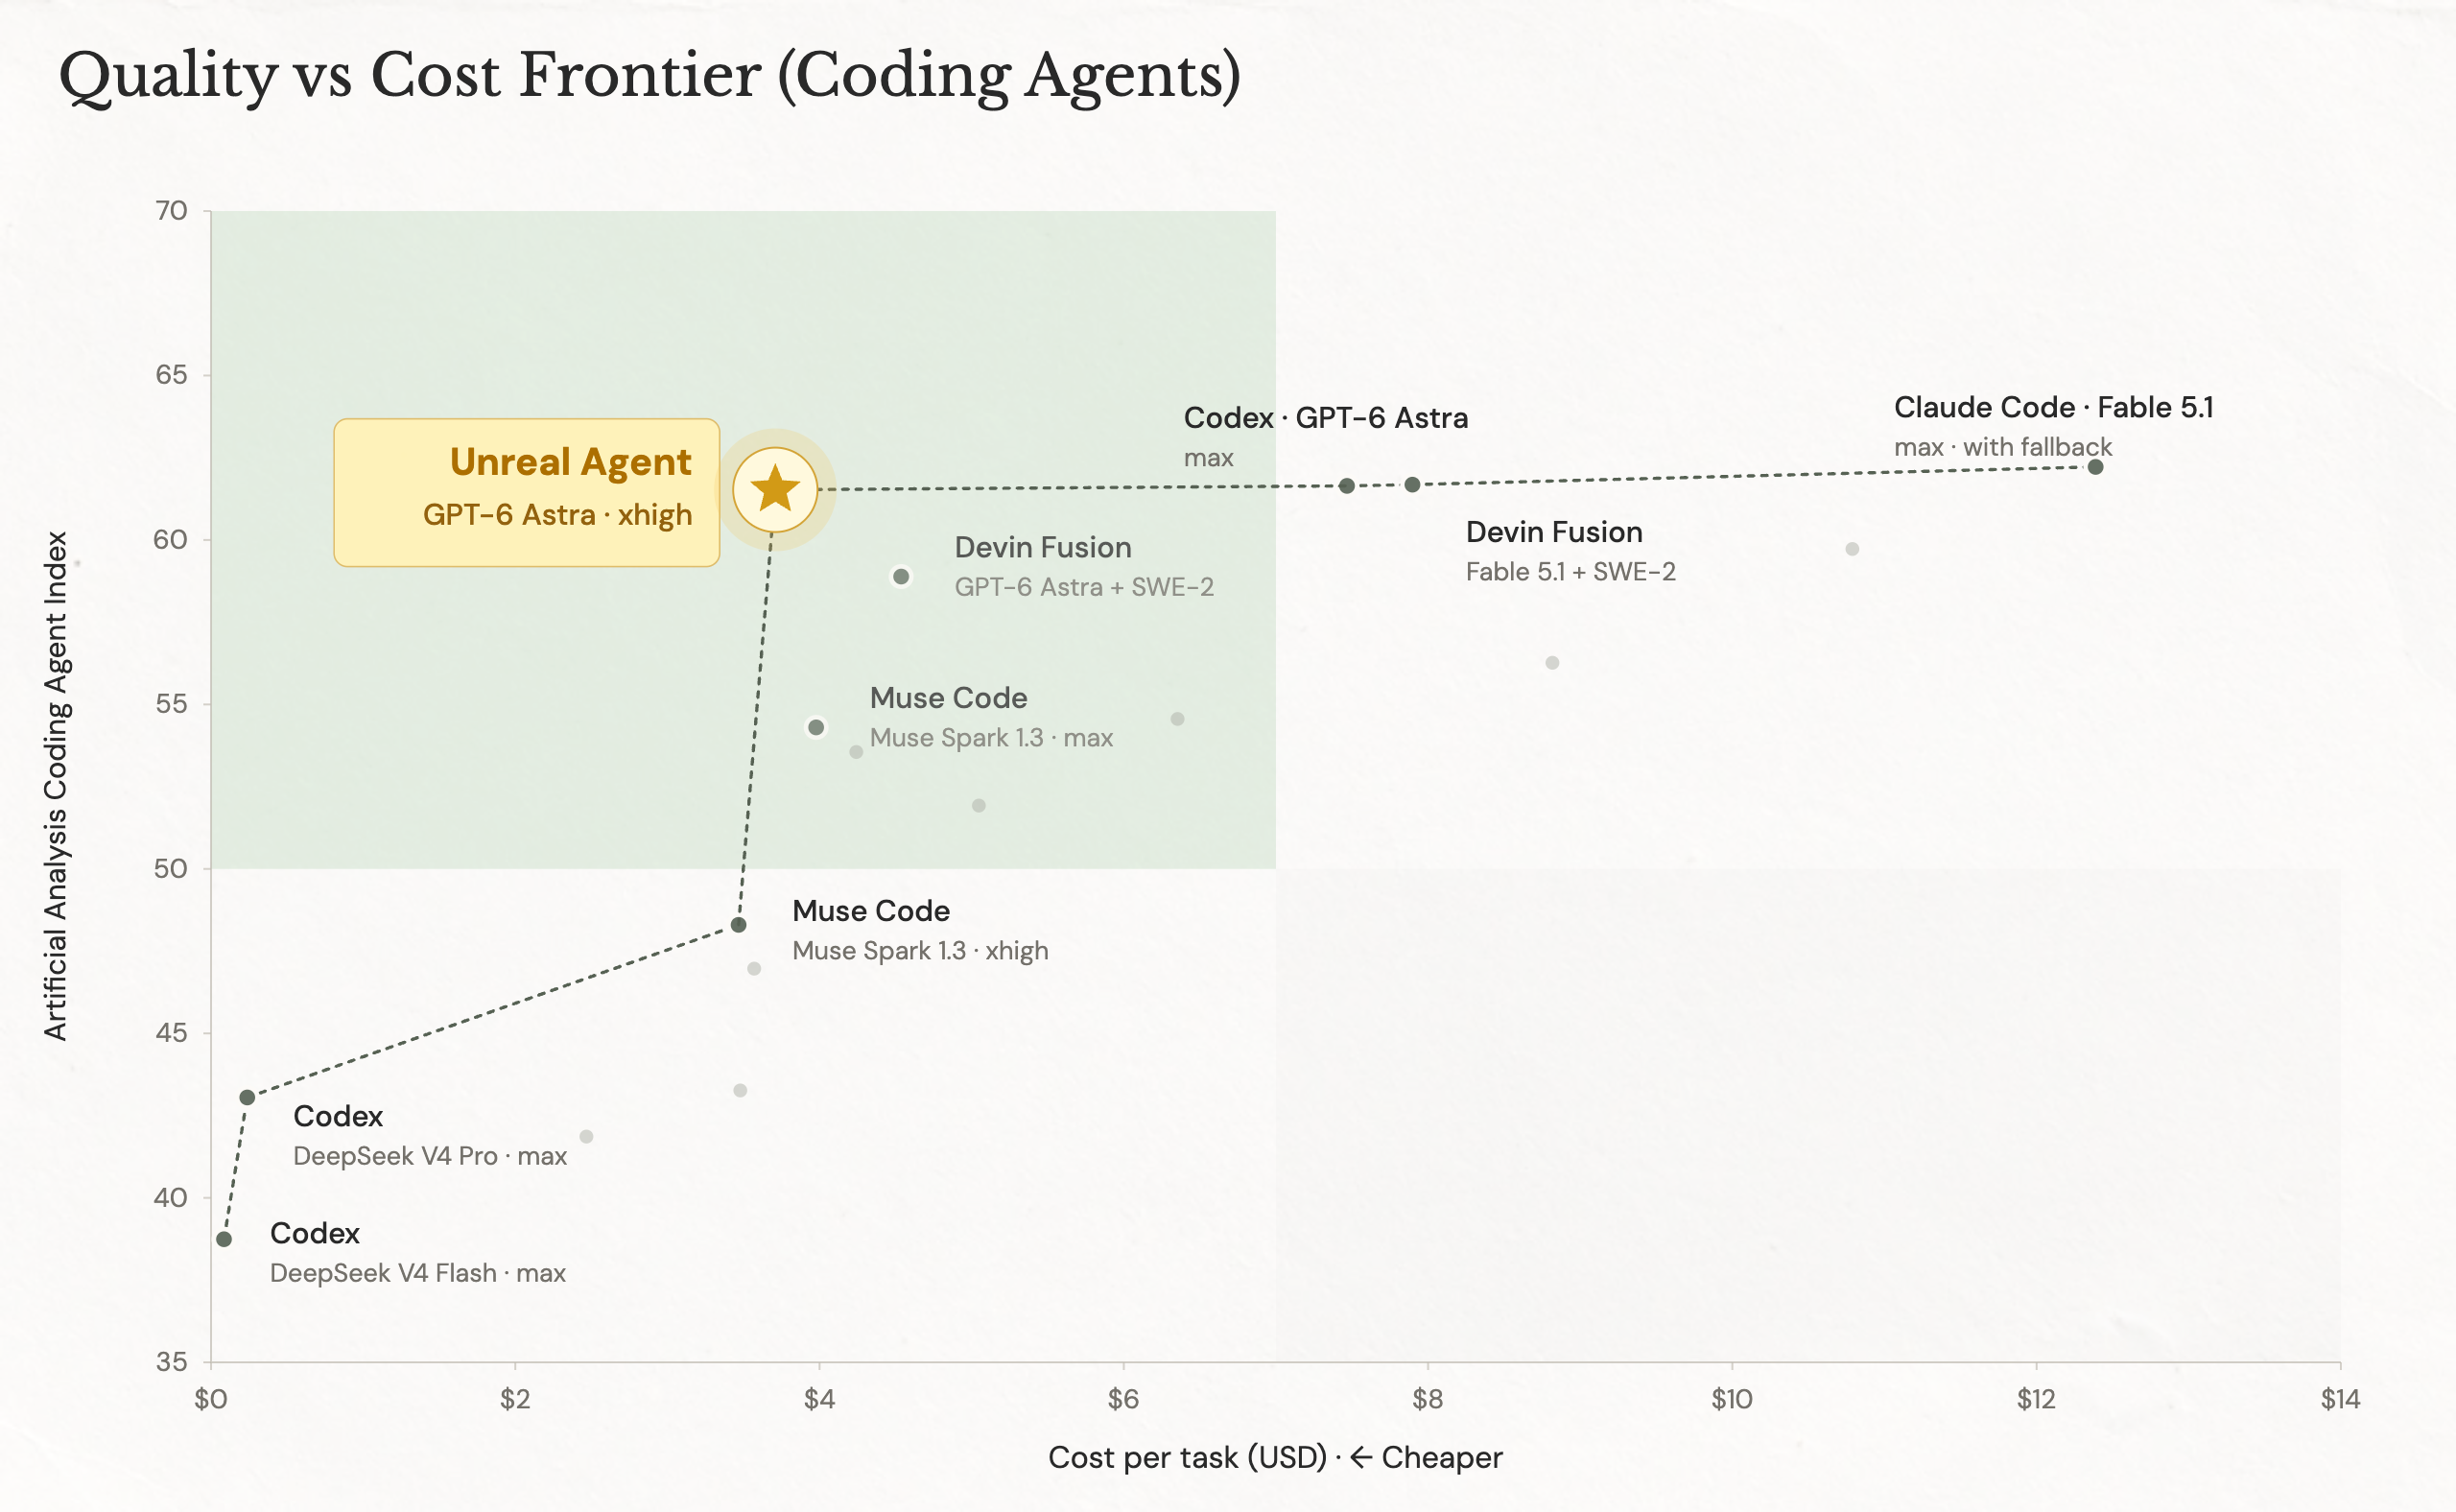
El gráfico representa las pruebas comparativas del artículo: por lo general, Unreal Agent cuesta menos que las referencias de Codex y Pi indicadas y, al mismo tiempo, obtiene tasas de aprobación medidas comparables.
El patrón continuó en las demás pruebas comunicadas. En DeepSWE 1.1, Unreal Agent obtuvo un 72,4 % con un coste de 1.367 dólares, frente al 69,0 % y 1.633 dólares de Codex y al 69,6 % y 1.584 dólares de Pi. En Agents’ Last Exam · ALE-CLI, obtuvo una tasa de aprobación completa del 30,0 % con un coste de 217 dólares, en comparación con el 29,0 % y 292 dólares de Codex y el 29,0 % y 262 dólares de Pi. La página principal señala que las pequeñas diferencias en las tasas de aprobación podrían reflejar la variabilidad de las pruebas comparativas, por lo que los resultados no deben interpretarse como prueba de una ventaja de calidad grande o constante.
La limitación más importante es la comparabilidad. La página describe Unreal Agent ejecutándose con GPT-6 Astra y un esfuerzo de razonamiento xhigh, y presenta Codex como una referencia de la clasificación, pero el material suministrado no ofrece suficientes detalles de configuración para establecer que todas las comparaciones utilizaron el mismo modelo subyacente, ajuste de razonamiento, conjunto de herramientas, política de contexto y presupuesto de ejecución. Las ejecuciones de ALE-CLI tampoco se realizaron en Harbor, a diferencia de las demás ejecuciones comparativas comunicadas. Como resultado, las tablas muestran un resultado favorable para la configuración probada de Unreal Agent, pero no aíslan la ejecución asíncrona como la única causa de la diferencia de costes.
Por ello, la afirmación destacada de la empresa de un ahorro de «hasta el 40 %» frente a Codex y de «hasta el 20 %» frente a Pi debe considerarse un límite superior comunicado por el editor, no una garantía general de rendimiento. Es compatible con varias cifras de las tablas, pero el conjunto de datos no establece que se haya realizado un único experimento controlado en el que todos los marcos de trabajo competidores se volvieran a ejecutar en condiciones idénticas. Quien elija un agente para producción todavía necesita probarlo con los repositorios relevantes, las herramientas pertinentes, las políticas de aprobación aplicables, los objetivos de latencia y los modos de fallo concretos.
El repositorio también aclara lo que la arquitectura no resuelve automáticamente. Presenta la validación, la cancelación, los errores del proveedor, la recuperación de sesiones, el estado de las operaciones y las herramientas seleccionadas por el host como responsabilidades separadas. Esta división puede facilitar la adaptación del sistema, pero también deja en manos de los equipos de despliegue la responsabilidad sobre los límites de los entornos aislados, las credenciales, los proxies, los registros de herramientas y el comportamiento de las operaciones remotas. Unreal Labs afirma que las restricciones del entorno y los controles de acceso granulares son más sólidos que depender únicamente de los ganchos del marco de trabajo; esta es una posición de ingeniería de la empresa, no una prueba independiente sobre todos los modelos de seguridad.
Existe una salvedad adicional de interoperabilidad para los equipos que estén considerando una implementación personalizada. Unreal Labs informa de que representar un resultado en curso y un resultado final como dos elementos de salida de llamadas a herramientas estaba insuficientemente especificado en la documentación de la API Responses. La empresa encontró rechazos con algunos modelos y proveedores de inferencia distintos de OpenAI, y afirma que el campo de estado `function_call_output` parecía no surtir efecto en esos casos. Por tanto, las pruebas suministradas respaldan una preocupación real sobre la compatibilidad observada por la empresa, pero no permiten afirmar que todos los proveedores se comporten de la misma manera.
Para los profesionales, la cuestión práctica no es si las herramientas asíncronas parecen elegantes. La pregunta es si las operaciones independientes pueden solaparse de forma segura, si una tarea de preparación prolongada puede cancelarse o recuperarse y si el modelo recibe suficiente estado estructurado para tomar la siguiente decisión. El diseño publicado de Unreal Agent aborda directamente esas cuestiones operativas en el nivel de los componentes, mientras que las tablas comparativas ofrecen una primera señal sobre el coste y la calidad. Sin embargo, no establecen la fiabilidad en producción, la seguridad ni ahorros para cargas de trabajo fuera de las pruebas de programación comunicadas.