Tailscale, una plataforma de conectividad que une dispositivos en redes privadas llamadas tailnets, está trabajando en cambios orientados a las partes de su sistema que mueven o preparan el tráfico. En una publicación del 22 de septiembre, la empresa dijo que el trabajo abarca el manejo de paquetes en Linux y Android, el procesamiento con múltiples colas para enrutadores de subred, conectores de aplicaciones y nodos de salida, además de mejoras más amplias de arranque mediante el almacenamiento en caché del mapa de red.
El primer cambio aborda los paquetes pequeños. Tailscale dice que la mayoría de los paquetes de red tienen alrededor de 1 KiB, pero Generic Receive Offload (GRO) de Linux, una función de rendimiento que maneja lotes más grandes de tráfico, espera búferes capaces de contener 64 KiB. La ruta anterior copiaba cada paquete pequeño en su propio búfer grande. En Linux y Android, Tailscale ahora deja los paquetes en la lectura más grande y registra dónde comienza y termina cada uno, de modo que muchos paquetes pequeños puedan compartir una sola asignación. La empresa informa que solo esto produjo una aceleración de alrededor del 5 % en muchas configuraciones de red.
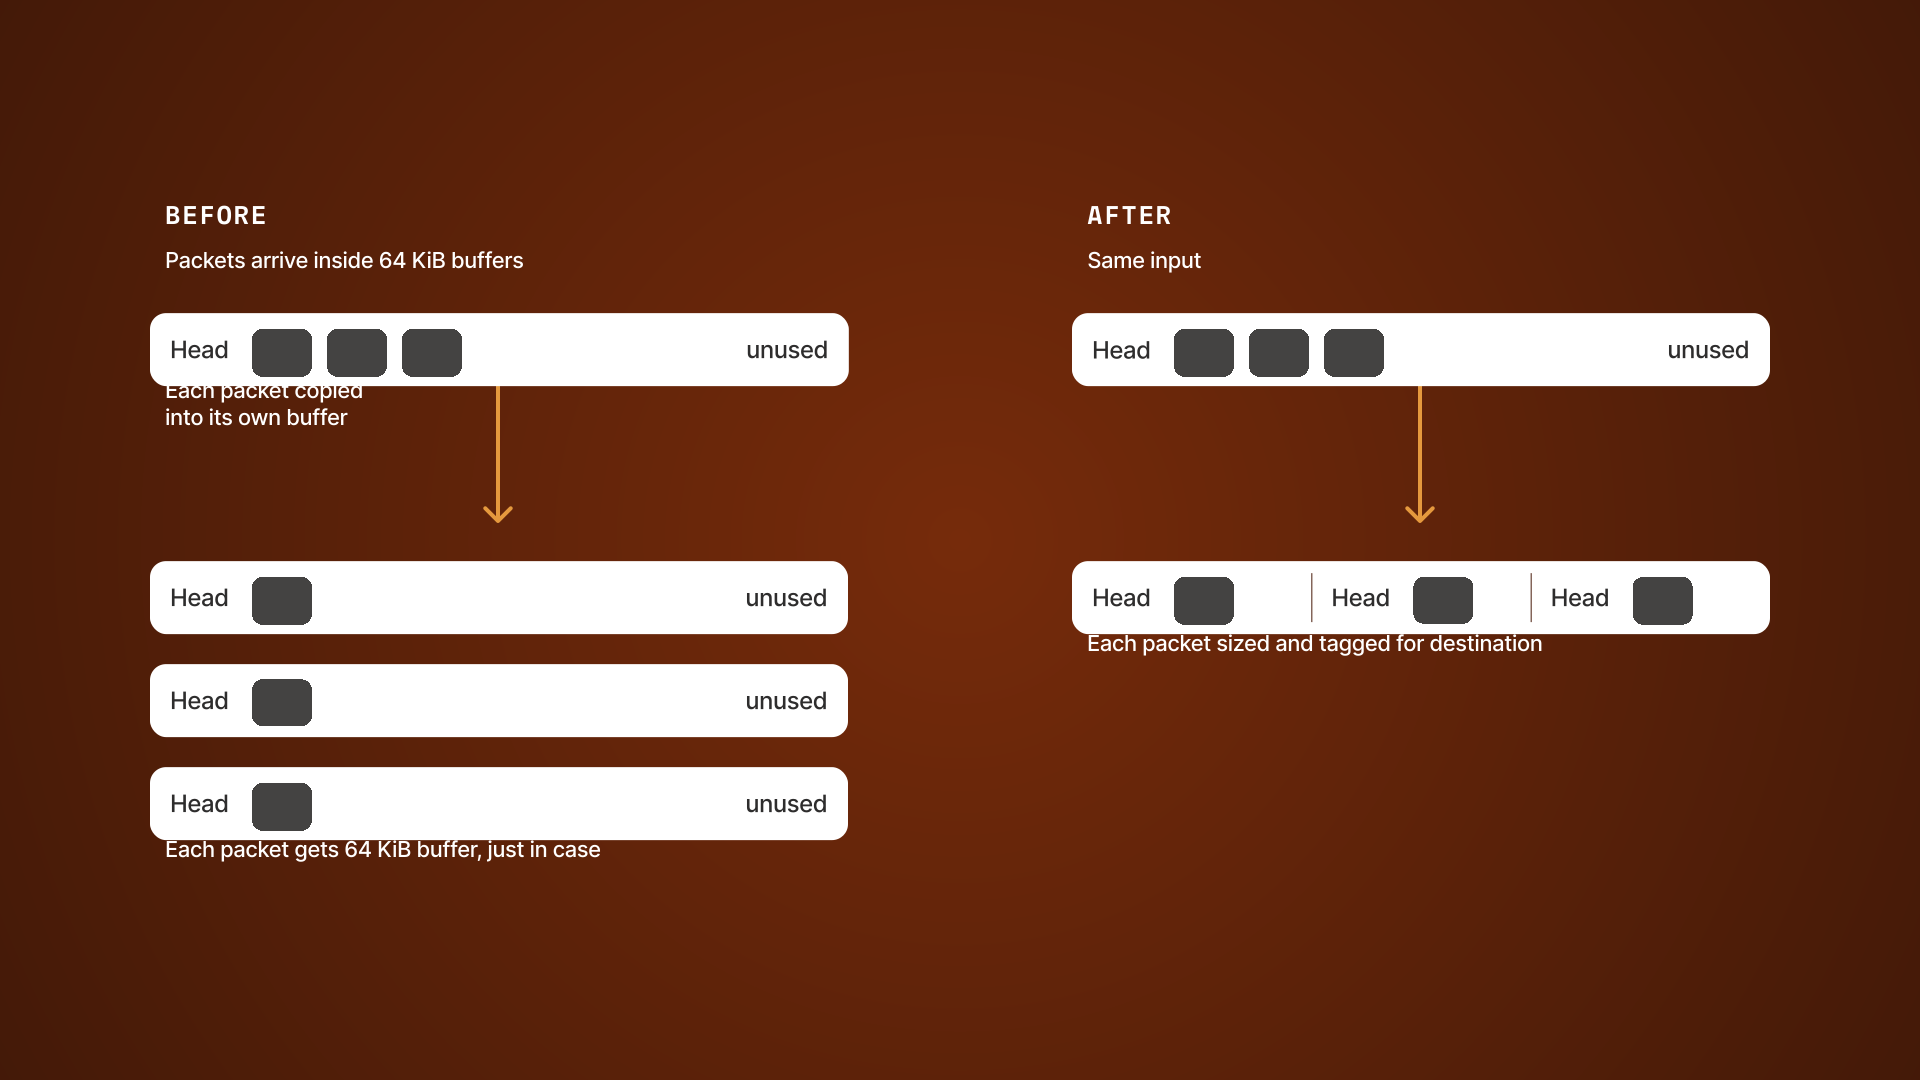
Situado después de la explicación del manejo de paquetes en Linux y Android, donde los paquetes permanecen en un búfer de lectura más grande en lugar de copiarse en búferes separados de 64 KiB.
El trabajo de múltiples colas apunta a nodos que reenvían tráfico para muchas conexiones. Los enrutadores de subred son pasarelas entre una tailnet y subredes físicas, y permiten que los dispositivos que no pueden ejecutar Tailscale se unan a la red; los nodos de salida enrutan el tráfico saliente de Internet a través de otro dispositivo. Tailscale dice que estas funciones antes procesaban flujos independientes en un único pipeline ordenado y de un solo hilo, en parte porque una aplicación receptora no debe ver sus propios paquetes llegar fuera de orden. El nuevo diseño asigna cada flujo a un carril y ejecuta los carriles en paralelo a través de núcleos de CPU, ajustando el número de carriles a la máquina y no al número de pares. La publicación dice que los conectores de aplicaciones también se benefician, pero los define solo como nodos de Tailscale que atienden a muchos usuarios con conexiones de corta duración.
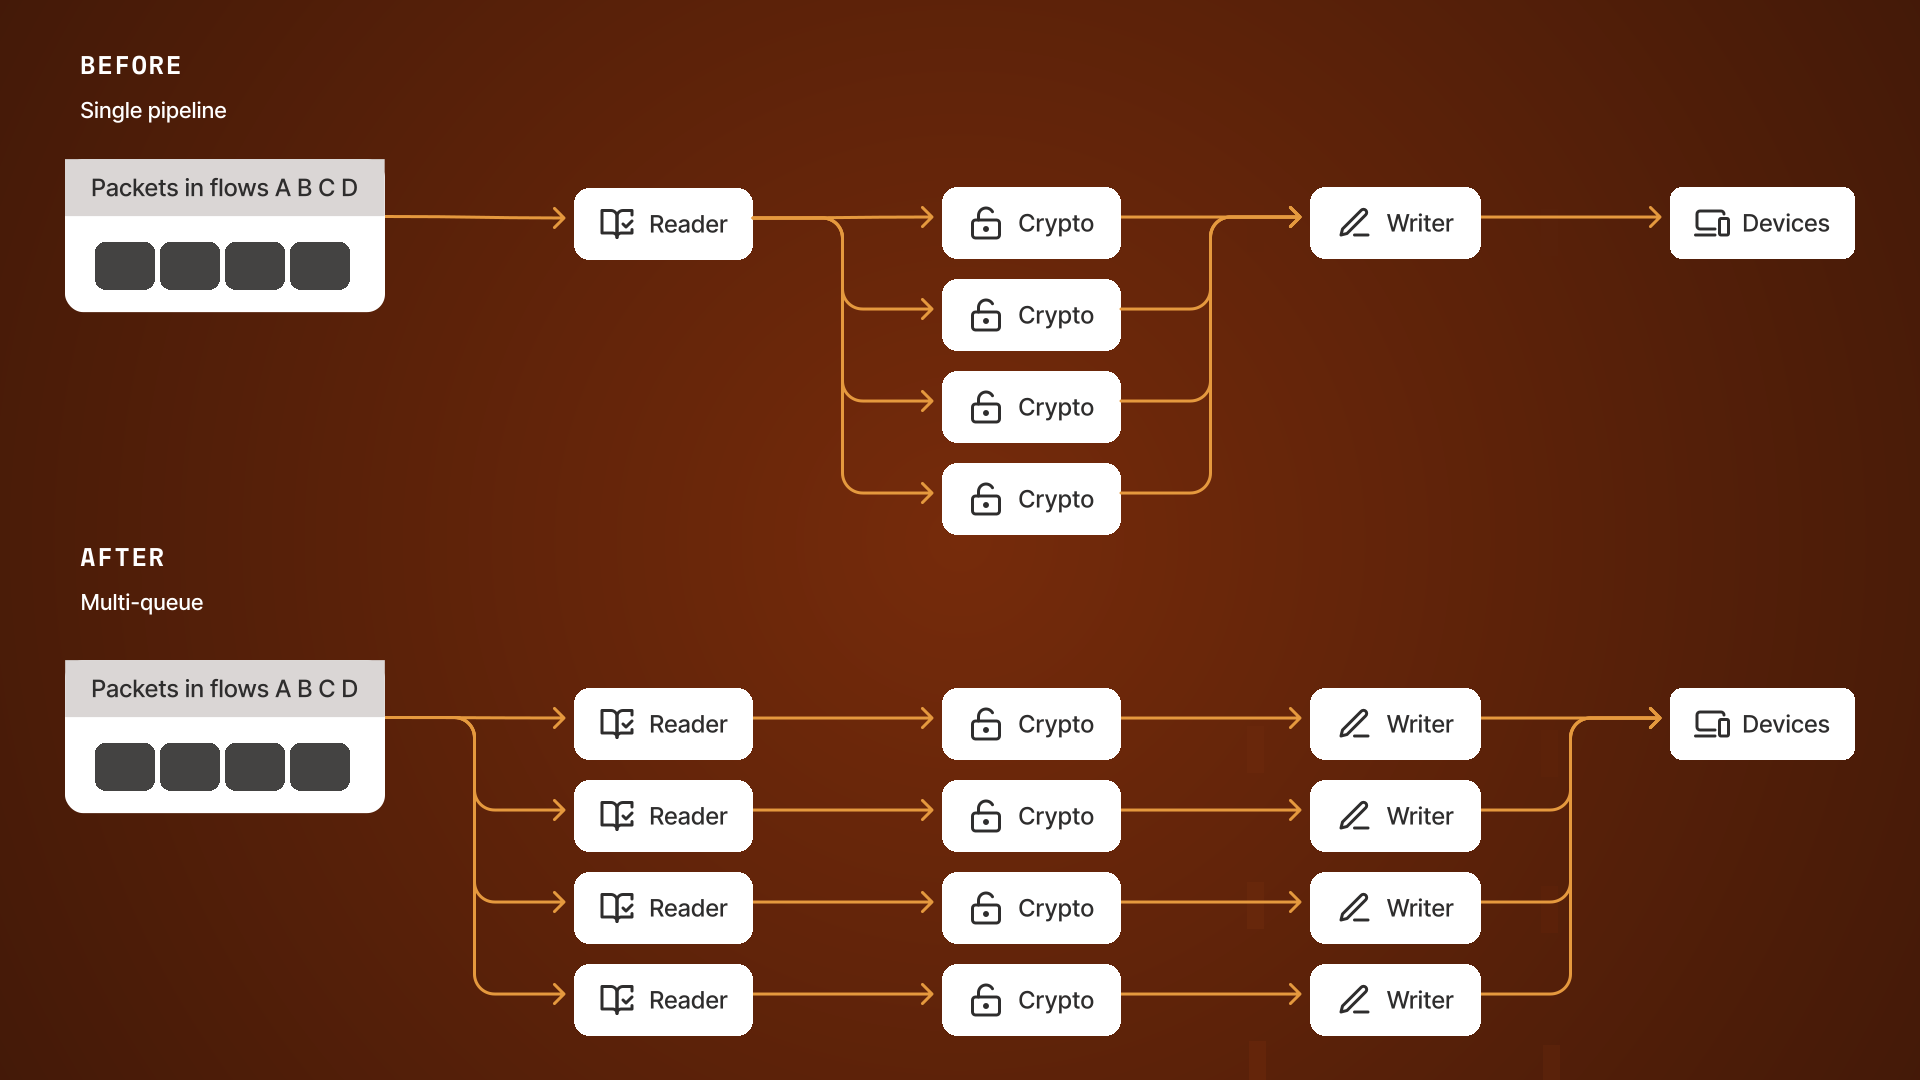
Situado después de la explicación de cómo los enrutadores de subred, los nodos de salida y los conectores de aplicaciones pasan de un único pipeline ordenado a carriles paralelos distribuidos entre núcleos de CPU.
El arranque es el otro gran objetivo. Un dispositivo normalmente se pone en contacto con el plano de control de Tailscale, se autentica y recibe un mapa de red, o netmap, que describe qué dispositivos puede alcanzar y cómo. Eso puede tardar unos 100 milisegundos en una red típica, pero el Wi-Fi deficiente de un avión, las redes filtradas de hoteles u otras conexiones débiles pueden retrasarlo o bloquearlo. Con el almacenamiento en caché del mapa de red, un dispositivo que ya se conectó guarda una copia en disco persistente y puede comenzar a establecer conexiones directas de dispositivo a dispositivo antes de llegar al plano de control. Tailscale dice que los arranques con caché caliente fueron entre uno y dos órdenes de magnitud más rápidos que los arranques en frío en tailnets con poca accesibilidad al plano de control.
Las compensaciones son específicas. El almacenamiento en caché requiere una conexión exitosa previa y espacio en disco; las tailnets muy grandes pueden generar un volumen considerable de tráfico de actualización de la caché, y el almacenamiento lento o sensible al desgaste, como las tarjetas SD, puede ser una mala opción. La disponibilidad también está escalonada: se esperan cambios en los búferes en la versión 1.104 para Linux y Android, el soporte de múltiples colas está previsto después de la versión 1.104, y el almacenamiento en caché del mapa de red está actualmente detrás de una marca de función antes de un despliegue predeterminado probado. Por ello, el enfoque en Linux y Android es un límite de implementación declarado, no una prueba de que las mismas técnicas sean imposibles en otros lugares.