Fable 5, tal como se describe en la publicación proporcionada, es un modelo de Anthropic disponible mediante planes de suscripción. La afirmación central no es que se haya demostrado un cambio en sus pesos subyacentes, sino que los usuarios podrían recibir diferentes regímenes de inferencia: la capacidad computacional y el proceso de razonamiento utilizados para responder a una indicación. Lon Lundgren informa de que, después de que Fable 5 estuviera disponible de forma permanente, las invocaciones de agosto recibieron “dramáticamente menos tokens de razonamiento” que las de julio, según cinco métodos de medición. Los “tokens de razonamiento” son los tokens de salida que el modelo dedica a razonar; que haya menos puede significar una deliberación interna menor antes de la respuesta final.
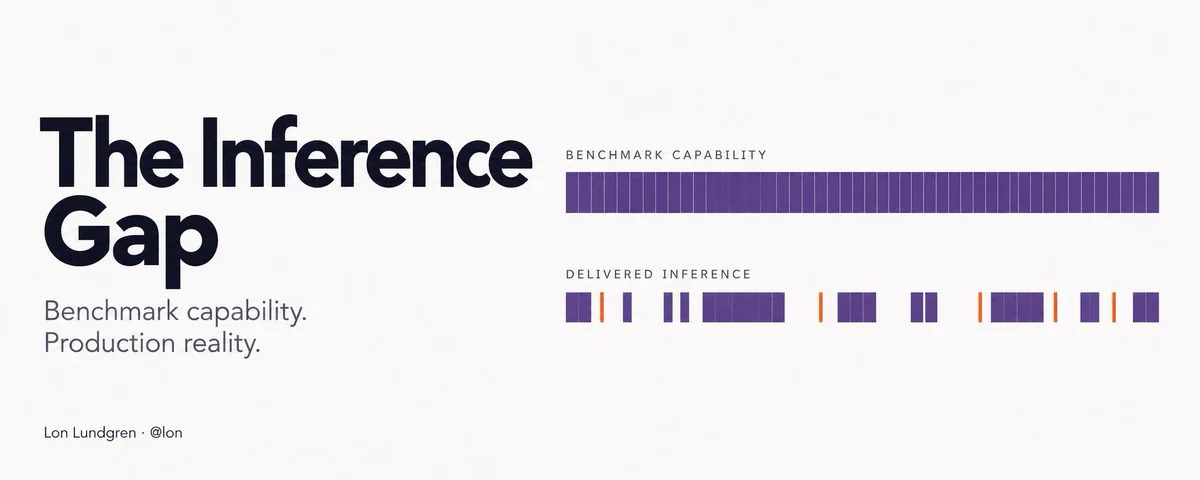
La publicación de Lundgren es la fuente primaria del informe del artículo que señala que las invocaciones de agosto utilizaron menos tokens de razonamiento que las de julio, según cinco métodos de medición.
La publicación afirma que el patrón persistió durante seis semanas, con fluctuaciones de varios días y algunos cambios alineados con anuncios o lanzamientos de productos. Lundgren también informa de que la mayoría de las solicitudes recibieron poco o ningún razonamiento, incluso cuando la interfaz parecía solicitar un esfuerzo xhigh o máximo, y de que las ejecuciones más largas rara vez alcanzaron los niveles publicados en las pruebas comparativas. Esto ayuda a explicar por qué el mismo modelo puede parecer competente un día y débil al siguiente: el nombre visible del modelo puede permanecer constante mientras cambia el régimen de servicio.
Una pregunta clave para el lector es si esto demuestra una “rebaja” deliberada. No lo demuestra. La fuente primaria establece las mediciones y la interpretación de Lundgren, no la intención de Anthropic, la causa de los cambios en la asignación ni si todos los usuarios experimentaron el mismo patrón. El material proporcionado también carece del conjunto de datos subyacente, las definiciones de los cinco métodos y una comparación directa con el protocolo de pruebas comparativas propio de Anthropic.
El rastreador independiente de Marginlab solo es relevante como contexto sobre cómo se puede supervisar el rendimiento de los modelos. Afirma que evalúa Claude Code con Opus 5.0 en un subconjunto seleccionado de SWE-Bench-Pro, mediante 50 evaluaciones diarias y muestras semanales y mensuales más amplias para detectar cambios estadísticamente significativos. Su página indica que la recopilación de la línea base todavía está en curso y que la detección de degradación está pausada, por lo que no corrobora la afirmación sobre Fable 5 ni establece que el mismo problema afecte a otros modelos.
La consecuencia práctica es la incertidumbre para los suscriptores: la calidad constante de los resultados puede depender no solo de qué modelo se selecciona, sino también del presupuesto de inferencia que se sirve realmente. Lo que sigue sin saberse es si la disminución observada en agosto fue temporal, estuvo relacionada con la carga, respondió a una política o se vinculó con un cambio específico del producto. Con base únicamente en este material, la conclusión defendible es que Lundgren observó una reducción sustancial en el uso de tokens de razonamiento, mientras que la causa y su prevalencia más amplia siguen sin verificarse.