La organización DataHaskell ha ampliado su conjunto de herramientas de ciencia de datos mediante la implementación de un escritor nativo de Parquet dentro de su biblioteca de marcos de datos. Parquet es un formato de almacenamiento columnar ampliamente utilizado que optimiza la recuperación eficiente de datos y la compresión, convirtiéndose en un estándar para la interoperabilidad entre las herramientas modernas de ciencia de datos. Anteriormente, los desarrolladores de Haskell estaban limitados en gran medida a formatos como CSV o JSON, los cuales a menudo sufren de limitaciones de rendimiento y carecen de los metadatos estructurales necesarios para el análisis de datos a gran escala. Al habilitar el soporte nativo para Parquet, la biblioteca permite a los usuarios escribir marcos de datos directamente en el disco mediante una interfaz sencilla, a la vez que proporciona opciones de configuración avanzadas para ajustar el tamaño de los grupos de filas y las páginas según cargas de trabajo específicas. La implementación gestiona la memoria utilizando matrices de bytes ancladas para manejar las complejidades del almacenamiento en búfer de los datos antes de que se vuelquen al disco, asegurando que el escritor pueda adaptarse a estructuras de datos variables. Aunque la versión actual admite esquemas planos básicos y códecs de compresión esenciales como Snappy, sigue siendo una implementación de un solo hilo con planes para abordar las restricciones de memoria y añadir soporte para estructuras de datos anidadas más complejas en futuras iteraciones. Este desarrollo marca un paso hacia hacer de Haskell una opción más práctica y eficiente para tareas intensivas en datos dentro del ecosistema más amplio de la ciencia de datos.
HN Digest / · HN #49802510
Implementación de un escritor de archivos Parquet para el ecosistema de ciencia de datos en Haskell
El proyecto DataHaskell ha introducido un escritor nativo de Parquet para su biblioteca de marcos de datos, permitiendo a los usuarios de Haskell serializar información en el formato columnar estándar de la industria para mejorar la interoperabilidad y la eficiencia en el almacenamiento.
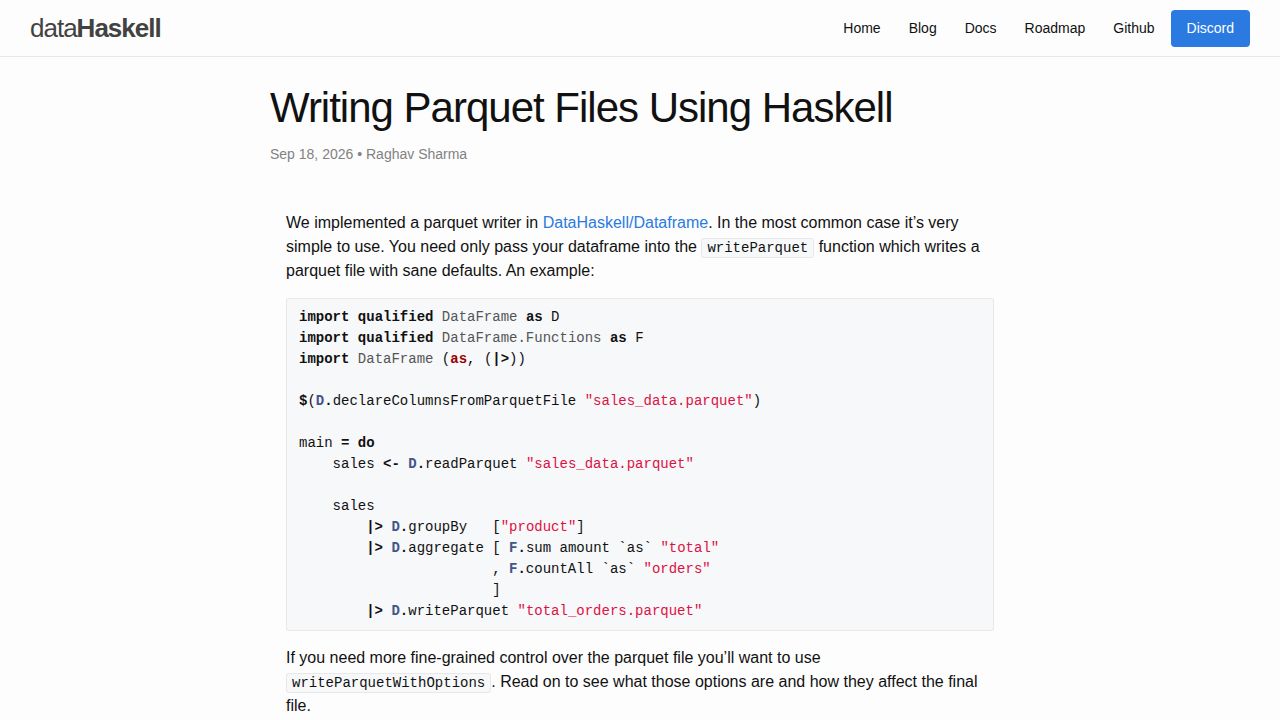
Captura de pantalla de la página de origen (datahaskell.org)